أحدث إصدارات Claude AI: دليل شامل لنماذج Haiku 5.5 وSonnet 5.5 وOpus 5.5 وClaude Code وسياسة الاستخدام الجديدة

أحدث إصدارات Claude AI وصلت خلال خمسة أسابيع فقط، وغيّرت حسابات كثيرة عند المطورين وأصحاب المواقع. فقد أطلقت أنثروبيك نموذج Claude Opus 5.5 في 22 سبتمبر 2026. ثم جاء Claude Sonnet 5.5 في 28 سبتمبر. بعد ذلك وصل Claude Haiku 5.5 في 7 أكتوبر، كما يوضح إعلان Haiku 5.5 الرسمي. وهكذا اكتملت عائلة Claude 5.5 بثلاثة نماذج، ولكل نموذج مستوى عمل مختلف. فالأول للأعمال المعقدة، والثاني للعمل اليومي، والثالث للمهام الضخمة منخفضة التكلفة.
لم تتوقف أخبار أحدث إصدارات Claude AI عند النماذج وحدها. فقد خفضت الشركة سعر قراءة الذاكرة المؤقتة (Cache Reads) في Sonnet 5.5 إلى 0.10 دولار لكل مليون توكن. كذلك أعلنت رصيد API شهريا لمشتركي Max وTeam. وفي 16 أكتوبر صدر Claude Code 2.1.302، حسب سجل Havoptic. علاوة على ذلك، نشرت أنثروبيك سياسة استخدام جديدة تبدأ في 12 نوفمبر 2026. وتضبط هذه السياسة الأعمال المستقلة والحالات عالية المخاطر.
في هذا الدليل أشرح كل نموذج بأرقامه الرسمية وأسعاره. بعد ذلك أعطيك أمثلة عملية من كل واحد منها. ثم أقارن بين النماذج الثلاثة لتختار الأنسب لعملك. كما ألخص تغييرات Claude Code وأهم بنود سياسة الاستخدام. وقد راجعت الأرقام على صفحات أنثروبيك الرسمية وعلى تقارير مستقلة. لذلك ستجد رابط المصدر داخل كل رقم مهم. وهذا يسمح لك بالتحقق منه بنفسك قبل أن تعتمد عليه في قرار أو مشروع حقيقي.
جدول المحتويات
- كيف وصلت أحدث إصدارات Claude AI خلال خمسة أسابيع؟
- ما هي أحدث إصدارات Claude AI وماذا تمثل للذكاء الاصطناعي؟
- Claude Opus 5.5: الأقوى ضمن أحدث إصدارات Claude AI بسعر أقل
- Claude Sonnet 5.5: السرعة والسعر الثابت في أحدث إصدارات Claude AI
- Claude Haiku 5.5: أرخص نموذج في أحدث إصدارات Claude AI
- مقارنة بين نماذج أحدث إصدارات Claude AI الثلاثة
- تخفيضات الأسعار في أحدث إصدارات Claude AI ورصيد API
- Claude Code 2.1.302: تحكم أكبر ضمن أحدث إصدارات Claude AI
- سياسة الاستخدام الجديدة وأحدث إصدارات Claude AI
- الخلاصة: ماذا تفعل بعد أحدث إصدارات Claude AI؟
كيف وصلت أحدث إصدارات Claude AI خلال خمسة أسابيع؟
بدأت القصة في 22 سبتمبر 2026، حين أطلقت أنثروبيك Claude Opus 5.5 كأول نموذج في عائلة Claude 5.5. وصف موقع VentureBeat هذا الإصدار بأنه يتفوق على Fable 5.1 في اختبارات الأداء الوكيلي بسعر أقل. كذلك قالت الشركة إن تكلفة تشغيله أقل بنحو 40% من Opus 5. وفي اليوم نفسه أعلنت أن Sonnet 5.5 وHaiku 5.5 سيصلان قريبا. وهكذا بدأت أحدث إصدارات Claude AI سلسلة سريعة وغير معتادة. فقد وصلت النماذج الثلاثة خلال خمسة عشر يوما فقط، وهي مدة قصيرة جدا بمقاييس هذه الصناعة.
بعد ستة أيام، في 28 سبتمبر، وصل Sonnet 5.5 بالسعر نفسه الذي حمله Sonnet 5، لكنه أسرع وأوفر في كل مهمة. وأضافت GitHub النموذج إلى Copilot في اليوم نفسه. ثم جاء Haiku 5.5 في 7 أكتوبر كنموذج صغير وسريع. وفي 8 أكتوبر نشرت أنثروبيك تفاصيل سياسة الاستخدام الجديدة. أما Claude Code فيصدر تحديثات شبه يومية، وكان الإصدار 2.1.302 في 16 أكتوبر. ويلخص الجدول التالي أحدث إصدارات Claude AI بترتيبها الزمني.
| التاريخ | الإصدار أو الحدث | أهم ما فيه |
|---|---|---|
| 22 سبتمبر 2026 | Claude Opus 5.5 | أول نموذج في عائلة 5.5، بسعر 4 دولارات للإدخال و20 للإخراج لكل مليون توكن |
| 28 سبتمبر 2026 | Claude Sonnet 5.5 | أسرع بأكثر من 30%، وتكلفة المهمة أقل حتى 30% |
| 7 أكتوبر 2026 | Claude Haiku 5.5 | أرخص وأسرع نموذج صغير، وأول Haiku بإعداد جهد قابل للضبط |
| 7 أكتوبر 2026 | خفض سعر Cache Reads | 0.10 دولار لكل مليون توكن في Sonnet 5.5، ورصيد API لمشتركي Max وTeam |
| 8 أكتوبر 2026 | إعلان سياسة الاستخدام | النسخة الجديدة تبدأ في 12 نوفمبر |
| 16 أكتوبر 2026 | Claude Code 2.1.302 | تحكم أكبر في الوضع التلقائي، وإصلاح أخطاء |
| 12 نوفمبر 2026 | بدء سياسة الاستخدام | تسري على منتجات أنثروبيك |
مقالة ذات صلة: Claude AI: كيف يغيّر هذا النموذج المتطور مستقبل الذكاء الاصطناعي؟
ما هي أحدث إصدارات Claude AI وماذا تمثل للذكاء الاصطناعي؟
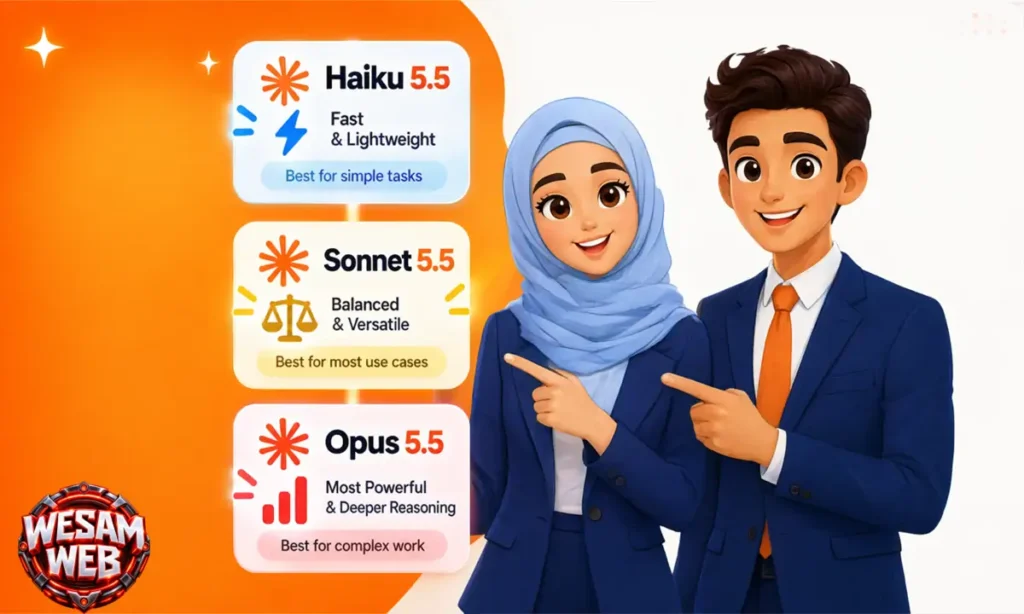
تُشكل أحدث إصدارات Claude AI قفزة نوعية حقيقية في منظومة الذكاء الاصطناعي، حيث أصبحت تعبر عن تحول المساعدين الرقميين من مجرد أدوات لتوليد النصوص إلى أنظمة برمجية ووكلاء تنفيذيين (Agents) قادرين على إدارة العمليات المعقدة بمرونة فائقة. وتتجلى القوة الكبرى لهذه الإصدارات المتقدمة في رفع مستوى الاستيعاب الممتد والسياق ليغطي ملفات ضخمة وشفرات برمجية كاملة دفعة واحدة، مما يتيح استخلاص النتائج وحل المشكلات الهندسية العميقة بدقة لا تتأثر بحدود الذاكرة النصية التقليدية.
بالإضافة إلى ذلك، تجسد الإصدارات الحديثة، مثل نماذج Sonnet و Opus وأداة Claude Code المتخصصة، التوازن الاحترافي المثالي بين الدقة البرمجية العالية والسرعة التشغيلية الاقتصادية. وبناء على ذلك، لم تعد التحديثات تقتصر على تحسين جودة المحادثة اليومية فحسب، بل امتدت لتوفر للمطورين والشركات قدرة فائقة على أتمتة كتابة الأكواد، واكتشاف الثغرات الرقمية، وتنفيذ سكريبتات الاختبار بشكل مستقل ومباشر داخل بيئات التطوير الحقيقية.
من ناحية أخرى، تمثل هذه المنظومة المحدثة نموذجاً رائعاً لمرونة الاستخدام عبر تنوع أنظمتها وسياساتها التشغيلية لتلائم مختلف فئات المستخدمين. فبينما تمنح النماذج السريعة مثل Haiku حلولاً خفيفة واقتصادية للأنظمة الذكية وروبوتات الدعم، تتيح الباقات والمنصات السحابية المؤسسية أقصى درجات حماية البيانات والأمان للمشاريع الكبرى. ونتيجة لذلك، أصبحت أحدث إصدارات Claude AI شريكاً تقنياً متكاملاً يعيد تعريف مفهوم الإنتاجية والتطوير الرقمي في الساحة التقنية.
Claude Opus 5.5: الأقوى ضمن أحدث إصدارات Claude AI بسعر أقل
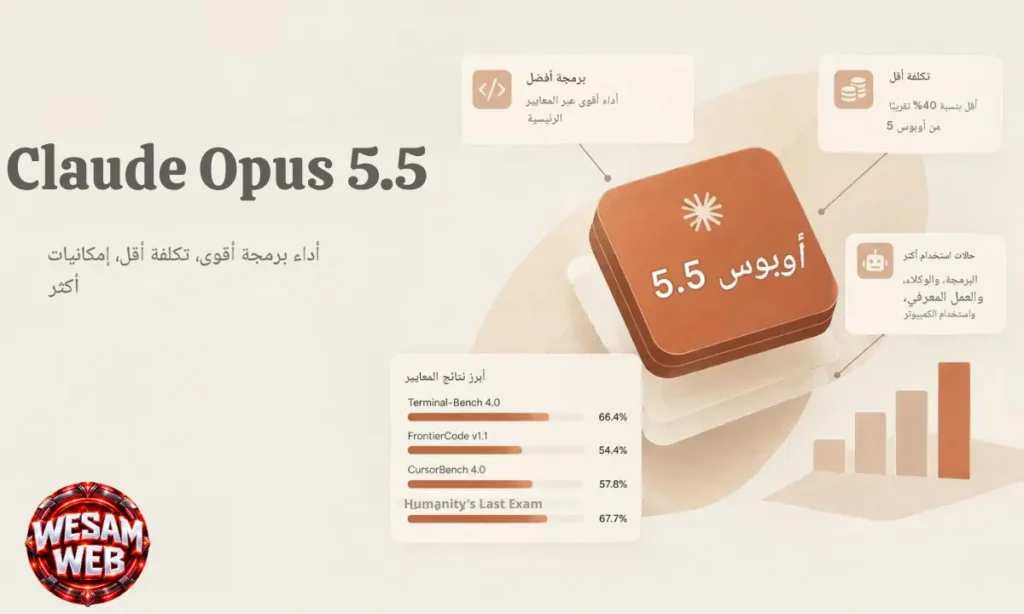
Claude Opus 5.5 هو النموذج الأقوى في عائلة 5.5. معرّفه البرمجي claude-opus-5-5. وهو متاح عبر Claude API وتطبيقات Claude وClaude Code. كذلك يعمل على Amazon Web Services وGoogle Cloud وMicrosoft Azure، حسب تقرير TechNews. وتصفه أنثروبيك بأنه نموذج للعمل المعقد الذي يحتاج إلى حكم دقيق وتفكير طويل. ويأتي Opus 5.5 كأهم نموذج في أحدث إصدارات Claude AI من حيث القدرة، لأنه يقترب من Fable 5.1 بسعر أقل بكثير.
المفاجأة هنا في السعر. يكلف Opus 5.5 مبلغ 4 دولارات لكل مليون توكن إدخال و20 دولارا لكل مليون توكن إخراج، كما يوضح تقرير DataNorth. أما Fable 5.1 فيكلف 10 دولارات و50 دولارا، أي إن Opus أرخص بنحو 60%. وكان Opus 5 يكلف 5 دولارات و25 دولارا، وفق تحليل Capital & Compute. وبذلك انخفض السعر 20% عن الجيل السابق. وتقول أنثروبيك إن تكلفة الأعمال النموذجية تنخفض نحو 40%، وإن سرعة الإخراج تزيد أكثر من 30%. لذلك وصف التحليل نفسه هذا الإصدار بأنه أول نموذج رائد من الشركة يصدر بسعر أقل من سابقه.
قبل الإطلاق اختبرت جهات مستقلة هذا النموذج، منها METR وFrontier Design، حسب تقرير The Standard. كذلك أضافت أنثروبيك ضمانات أمنية كانت مخصصة سابقا لأقوى أنظمتها. وفي الوقت نفسه ذكر موقع kingy.ai أن الشركة رفعت حدود الاستخدام كل خمس ساعات في خطط Pro وMax وTeam وEnterprise المعتمدة على المقاعد. لذلك يستفيد المشترك العادي من هذا الإصدار حتى لو لم يكتب سطرا واحدا من الكود. وتكمل هذه الخطوات صورة أحدث إصدارات Claude AI في فئة النماذج الرائدة.
أرقام Opus 5.5 وأسعاره
تنشر أنثروبيك نتائج النماذج على مقاييس الأداء الوكيلي (Agentic). يختبر Terminal-Bench 4.0 قدرة النموذج على إنجاز مهام مهنية معقدة عبر سطر الأوامر. وسجل Opus 5.5 فيه 66.4% عند جهد Xhigh، كما يظهر في جدول الأداء الرسمي. أما FrontierCode 1.1 فيسأل سؤالا عمليا، وهو: هل يقبل الفريق دمج تعديلات الكود دون تدخل بشري؟ وسجل النموذج فيه 54.4%. كذلك سجل 57.8% في CursorBench 4.0، وهو اختبار مبني على جلسات حقيقية من محرر Cursor. وتقيس هذه الأرقام جودة الكود وليس سرعة كتابته فقط.
في العمل المعرفي سجل Opus 5.5 رقم 1846 على GDPval-AA v2.1. وهذا الاختبار يغطي مهام واقعية في 44 مهنة، حسب صفحة Haiku 5.5 الرسمية. كذلك سجل 67.7% في Humanity’s Last Exam مع الأدوات. وسجل 81.8% في OSWorld 2.1 بالدرجة الجزئية، وهو اختبار يقيس تشغيل حاسوب حقيقي في مهام طويلة. ومع ذلك يجب أن تتذكر أمرا مهما. فهذه الأرقام صادرة عن أنثروبيك نفسها، وليست نتائج مستقلة. لذلك اختبر النموذج على مهامك الخاصة قبل أن تعتمده في عمل حقيقي.
| المقياس | ماذا يقيس | نتيجة Opus 5.5 |
|---|---|---|
| Terminal-Bench 4.0 | مهام معقدة عبر سطر الأوامر | 66.4% (جهد Xhigh) |
| FrontierCode 1.1 | هل يقبل الفريق دمج التعديل | 54.4% |
| CursorBench 4.0 | مهام غامضة متعددة الملفات | 57.8% |
| GDPval-AA v2.1 | أعمال واقعية في 44 مهنة | 1846 |
| Humanity’s Last Exam | معرفة وتفكير أكاديمي | 67.7% (مع الأدوات) |
| OSWorld 2.1 | تشغيل حاسوب حقيقي | 81.8% (جزئي) |
مصدرالأسعار صفحة Claude Sonnet 5.5 الرسمية.
| بند السعر لكل مليون توكن | Opus 5.5 | Opus 5 |
|---|---|---|
| الإدخال | 4 دولارات | 5 دولارات |
| الإخراج | 20 دولارا | 25 دولارا |
| قراءة الذاكرة المؤقتة | 0.20 دولار | 0.50 دولار |
أمثلة عملية على Opus 5.5 من أحدث إصدارات Claude AI
يظهر Opus 5.5 قيمته عندما يكون الطلب غامضا ويحتاج إلى قرار معماري. فقد استخدمت شركة Cognition هذا النموذج قائدا في أداة Devin Fusion، وجعلت Haiku 5.5 مساعدا له، كما جاء في شهادة الشركة على صفحة Haiku 5.5. وحققت التركيبة 66.2 على FrontierCode مع تكلفة وزمن أقل. ويعكس هذا المثال تقسيم الأدوار بين نموذج كبير ونموذج صغير. كذلك يوضح أن أحدث إصدارات Claude AI صارت تعمل كفريق، وليس كنماذج منفصلة. فالنموذج الأقوى يخطط، والأرخص ينفذ المهام المتكررة.
وقال Kevin Ngo، المبرمج الإبداعي في شركة Creator، إنه يطمئن إلى تسليم التنفيذ إلى Sonnet 5.5. لكن ذلك يحدث بعد أن يضع Opus 5.5 البنية العامة للعبة، وفق صفحة Sonnet 5.5 الرسمية. وتعكس هذه الشهادة قاعدة بسيطة، وهي أن Opus يخطط وSonnet ينفذ. أما السيناريوهات التالية فهي توضيحية من عندي، وليست نتائج منشورة من أنثروبيك. لذلك استخدمها كأفكار للتجربة. ثم عدّل الصياغة بما يناسب مشروعك وبياناتك.
- مراجعة معمارية: ترسل مستودع المشروع وتطلب أخطر ثلاث نقاط ضعف في قاعدة البيانات. ثم تطلب خطة ترحيل على مراحل.
- تحقيق في عطل: تعطيه سجلات (Logs) ثلاث خدمات. بعد ذلك يرتب الأسباب المحتملة ويقترح اختبارا لكل فرضية.
- تقرير بحثي طويل: تطلب مقارنة مالية أو قانونية من مصادر متعددة. ثم تراجع الاستنتاجات بنفسك.
- تخطيط الوكلاء: تطلب تقسيم مشروع كبير إلى مهام. بعد ذلك توزعها على Sonnet وHaiku.
متى تختار Opus 5.5 وما حدوده؟
اختر Opus 5.5 عندما تكون كلفة الخطأ أعلى من كلفة النموذج. فتقول أنثروبيك في صفحة Sonnet 5.5 الرسمية إن Opus يبقى أقوى بوضوح في الأعمال المفتوحة التي تحتاج إلى حكم مستمر. ويصح ذلك حتى لو اقترب Sonnet منه في الأرقام. لذلك يناسب Opus الاستشارات المعمارية والمشروعات الطويلة والقرارات المكلفة. كذلك يناسب المهام التي تتغير متطلباتها أثناء التنفيذ. أما الأعمال المحددة بوضوح فيكفيها نموذج أرخص. وهذه القاعدة تصح على كل نماذج أحدث إصدارات Claude AI، لأن النموذج الأغلى لا يعني دائما النتيجة الأفضل لمهمتك.
لكن Opus 5.5 ليس الأفضل في كل شيء. فبحسب تحليل Capital & Compute، خسر أمام GPT-6 Astra في اختبار AutomationBench. فقد سجل 40.0% مقابل 41.4%. وهذا يذكرنا بأن أرقام الشركات عن نماذجها تحتاج دائما إلى قراءة نقدية. كذلك يكلف Opus ضعف Sonnet 5.5 في سعر التوكن. لهذا السبب لا تجعله خيارك الافتراضي لكل طلب صغير. فالمهام البسيطة المتكررة تستهلك ميزانيتك بسرعة إذا أرسلتها إلى نموذج بهذا السعر.
ويجب أن تعرف قيود الأمان أيضا. فبحسب CloudMonitor عبر موقع ComputingForGeeks، تطبق أنثروبيك على Opus 5.5 ضمانات أمن سيبراني شبيهة بضمانات Fable 5.1. وتسمح هذه الضمانات بالعمل العادي في تطوير البرمجيات. لكنها قد تقيد المهام الهجومية عالية الخطورة. وقالت الشركة إن فرق الدفاع السيبراني ستقدم قريبا على برنامج التحقق السيبراني للحصول على وصول متدرج إلى قدرات أوسع. وبذلك تبقى الأدوات متاحة لمن يحتاجها بصورة مشروعة.
Claude Sonnet 5.5: السرعة والسعر الثابت في أحدث إصدارات Claude AI
وصل Claude Sonnet 5.5 في 28 سبتمبر 2026 كثاني نموذج في عائلة 5.5. معرّفه claude-sonnet-5-5، ويدعم نافذة سياق بحجم مليون توكن، حسب موقع Price Per Token. وتصفه أنثروبيك بأنه مكمل أسرع وأرخص لـ Opus 5.5، كما في صفحته الرسمية. فهو الأقوى في المهام المحددة بوضوح وإصلاح الأخطاء. كذلك ينشئ المستندات والعروض التقديمية وجداول البيانات بشكل مصقول. ويحتل مكانا مهما بين أحدث إصدارات Claude AI، لأنه يخدم أغلب الاستخدامات اليومية بتكلفة معقولة.
بقي سعره كما هو: دولاران لكل مليون توكن إدخال و10 دولارات لكل مليون توكن إخراج. لكن النموذج يحتاج توكنات أقل لإنجاز المهمة نفسها. لذلك تنخفض التكلفة لكل مهمة حتى 30% مقارنة بـ Sonnet 5. وذكر موقع The New Stack أن النموذج يعمل أسرع بنحو 30% أيضا. وتقول أنثروبيك إن توليد المخرجات صار أسرع بأكثر من 30%، فهو أسرع نموذج Sonnet لديها حتى الآن. ومن ثم يصلح للتجارب السريعة والحلقات التكرارية القصيرة، وهي أهم ما يحتاجه المطور أثناء العمل.
وأضافت أنثروبيك تفصيلا طريفا في إعلانها الرسمي. فهذا أول نموذج Sonnet يتغلب على لعبة Pokémon Red من لقطات الشاشة وحدها. ورغم أن المعلومة تبدو مسلية، فإنها تدل على تحسن الفهم البصري والعمل الطويل. كذلك وصف المختبرون المبكرون النموذج بأنه شريك حوار أفضل من Sonnet 5. وأشادوا أيضا بحسه في التصميم، وقالوا إن كتابته أوضح من الجيل السابق. وهذه ميزات يلمسها المستخدم العادي مباشرة، حتى لو لم يقرأ جداول الأداء.
أرقام Sonnet 5.5 وأسعاره ضمن أحدث إصدارات Claude AI
قفز Sonnet 5.5 قفزة كبيرة في البرمجة الوكيلية. فقد سجل 70.6% على Terminal-Bench 4.0، بينما سجل Sonnet 5 نسبة 10.3% فقط، حسب جدول الأداء الرسمي. وهذا الرقم يتجاوز نتيجة Opus 5.5 البالغة 66.4% عند جهد Xhigh. أما في CursorBench 4.0 فسجل 55.5% مقابل 57.8% لـ Opus. وفي FrontierCode سجل 52.1% عند Xhigh و46.2% عند Max. وتفسر أنثروبيك هذا الانخفاض بأن المراجعة الموزعة على وكلاء فرعيين سببت مهلة زمنية وتعديلات خارج نطاق المهمة.
في العمل المعرفي سجل النموذج 1844 على GDPval-AA مقابل 1846 لـ Opus 5.5. كذلك تقول أنثروبيك إن Sonnet 5.5 عند جهد منخفض أو متوسط يتفوق على أفضل نتيجة لـ Sonnet 5. ويحدث ذلك بنحو عُشر التكلفة لكل مهمة في عدة اختبارات. لذلك لا تحتاج دائما إلى رفع مستوى الجهد (Effort). ومع ذلك تذكر الشركة أن هذا النموذج لا يوسع حدود قدراتها، بل يرفع الكفاءة فقط. وهذه ملاحظة صادقة تستحق الانتباه عند مقارنة الأرقام.
| المقياس | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66.4% |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% |
| GDPval-AA v2.1 | 1844 | 1449 | 1846 |
| Humanity’s Last Exam (مع الأدوات) | 64.5% | 54.9% | 67.7% |
| OSWorld 2.1 (جزئي) | 80.1% | 57.0% | 81.8% |
| Chartography (بلا أدوات) | 61.6% | 15.6% | 64.4% |
أمثلة عملية على Sonnet 5.5
ظهرت نتائج Sonnet 5.5 بوضوح في شهادات العملاء المنشورة على صفحة النموذج الرسمية. فقد اختبرت Base44 نحو 118 بناء تطبيق حقيقيا. وأنجز النموذج كل بناء بمتوسط 3.6 محاولة، بينما احتاج Opus 5 إلى 7.7 محاولة. كذلك ذكرت Balyasny Asset Management أن النموذج استهلك نحو 121 ألف توكن لكل إجابة مالية. أما Sonnet 5 فاستهلك 497 ألفا. وتدل هذه الأرقام على أن الكفاءة لا تعني السرعة فقط، بل تعني أيضا عدد الخطوات والتوكنات اللازمة للوصول إلى الإجابة.
وفي الدعم الفني قالت Zendesk إن معالجة التذاكر صارت أسرع بنسبة 20%. كما أكدت Unity أن النموذج أكمل 90% من مهام اختبارها متعدد الخطوات في المحرر. ثم أجرت أنثروبيك اختبارا داخليا. فقد أعطت النموذج مواد أرباح شركة عامة مع قالب شرائح، وطلبت عرضا من 10 شرائح. وحكم خبيران بأن المسودة الأولى جاهزة للإرسال. أما الأمثلة التالية فهي توضيحية من عندي، وليست نتائج منشورة. فاستخدمها لتجربة النموذج على عملك الفعلي.
- إصلاح خطأ برمجي: تطلب البحث عن سبب فشل اختبار تسجيل الدخول. ثم يصلحه بأقل تعديل ممكن.
- عرض تقديمي: ترسل تقريرا ماليا مع قالب شركتك. بعد ذلك يعيد عرضا من عشر شرائح.
- وكيل دعم: يقرأ تذكرة العميل ويقرر إغلاقها أو تصعيدها. ثم يكتب ملخصا قصيرا.
- تحليل جدول بيانات: تلصق مبيعات شهرية. ثم يشرح أسباب هبوط الربع الأخير في ثلاث نقاط.
متى تختار Sonnet 5.5 من أحدث إصدارات Claude AI وما حدوده؟
يمثل Sonnet 5.5 الاختيار الافتراضي المناسب لمعظم الفرق. فتطبيقات Claude وClaude Code تستخدم الجهد المتوسط افتراضيا، بينما تستخدم Claude Platform الجهد العالي، كما توضح صفحة النموذج الرسمية. وكلما خفضت الجهد زادت السرعة وقلت التكلفة. لذلك ابدأ بالمتوسط. ثم ارفع الجهد فقط عندما تفشل المهمة. وبهذه الطريقة تحصل من أحدث إصدارات Claude AI على أفضل توازن بين الجودة والسعر، دون أن تدفع ثمن تفكير زائد لا تحتاجه.
وتوجد قيود يجب أن تعرفها. فهذا أول Sonnet يصدر بضمانات أمن سيبراني مماثلة لأقوى نماذج الشركة. وبالتالي تتراجع المهام السيبرانية عالية الخطورة إلى Sonnet 5، بينما يبقى إصلاح الأخطاء العادي سليما. كذلك أضافت أنثروبيك مصنفات تمنع استخراج التفكير (Distillation). ووسعت أيضا التفكير المحفوظ (Preserved Thinking). لذلك اقرأ التوثيق إذا بدلت حسابك داخل جلسة Claude Code. فهذا التبديل قد يسبب سلوكا لم تتوقعه.
وعلى مستوى API تغير شيء مهم لمن يعطل التفكير. فهو يحتاج إلى إعداد جديد اسمه between_tools، كما يشرح دليل الترحيل الرسمي. ومع ذلك يبقى Opus 5.5 أقوى في الأعمال المفتوحة الطويلة. لذلك لا تعتمد على الأرقام وحدها. بل جرب النموذجين على مهمتين حقيقيتين من عملك. وبعد ذلك قرر بناء على النتيجة والتكلفة معا، وليس على الاسم أو السعر فقط.
Claude Haiku 5.5: أرخص نموذج في أحدث إصدارات Claude AI
أطلقت أنثروبيك Claude Haiku 5.5 في 7 أكتوبر 2026، ومعرّفه claude-haiku-5-5. وتصفه الشركة في إعلانها الرسمي بأنه أرخص وأسرع وأقوى نموذج صغير أصدرته. لذلك صممته للأعمال الضخمة الحساسة للتكلفة. ومن أمثلتها التلخيص والضغط (Compaction) واستعلامات قواعد البيانات والتصنيف. كذلك يعمل وكيلا فرعيا (Subagent) يدعم Opus 5.5 وSonnet 5.5 في البرمجة. وهذا الدور يجعله جزءا مهما من أحدث إصدارات Claude AI عند بناء أنظمة الوكلاء.
السعر هو الخبر الأكبر. فهذا النموذج يكلف نحو 75% أقل من Haiku 4.5 في المتوسط، كما تؤكد صحيفة iThome. وللطلبات التي لا تتجاوز 100 ألف توكن تبلغ نسبة التخفيض 90%. وهذه الطلبات تمثل نحو 90% من استخدام النموذج السابق، حسب إعلان أنثروبيك. لكن المرمز (Tokenizer) الجديد يستهلك توكنات أكثر قليلا. وقد احتسبت الشركة ذلك في الرقم. كما أنه أول Haiku يدعم إعداد الجهد القابل للضبط، فيتحكم المطور في التوازن بين التكلفة والذكاء.
وتقول أنثروبيك إنه أسرع نماذجها بالسرعة القياسية. لكنه أبطأ من نماذج Opus عندما تعمل بوضع Fast Mode. كذلك يتوفر على AWS وGoogle Cloud وAzure. علاوة على ذلك، حدثت الشركة حزم Python SDK وTypeScript SDK، وصارت تدعم Browser Use وComputer Use بنسخة تجريبية. ولهذا يناسب Haiku 5.5 هذه المهام بسرعته وسعره. وذكر موقع Android Authority أنه يتفوق على GPT-6 Luna في عدة اختبارات.
أرقام Haiku 5.5 وأسعاره بين أحدث إصدارات Claude AI
على مقياس GDPval-AA سجل Haiku 5.5 رقم 1620، بينما سجل Haiku 4.5 رقم 735 وسجل GPT-6 Luna رقم 1437، وفق جدول الأداء الرسمي. وفي OSWorld 2.1 بلغ 72.4% مقابل 15.7% للإصدار السابق. أما في Humanity’s Last Exam فسجل 45.9% دون أدوات و57.4% مع الأدوات. وهذه قفزة تجعل المقارنة مع الجيل السابق شبه غير عادلة. كذلك تفسر لماذا تعدّه أنثروبيك أقوى نموذج صغير أصدرته حتى الآن.
في البرمجة سجل 39.2% على Terminal-Bench 4.0، بينما سجل Haiku 4.5 نسبة 0.0% وسجل Luna نسبة 16.4%. كذلك سجل 46.4% على FrontierCode 1.1 مقابل 42.4% لـ Luna. ومع ذلك تقول أنثروبيك بصراحة إن Sonnet 5.5 وOpus 5.5 أفضل للمهام المعقدة. فقد سجل Sonnet 70.6% على Terminal-Bench نفسه. لذلك خصص Haiku للمهام الضيقة والمحددة. وراجع بطاقة النظام الرسمية إن أردت معرفة طريقة إجراء الاختبارات.
| المقياس | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna |
|---|---|---|---|
| GDPval-AA v2.1 | 1620 | 735 | 1437 |
| OSWorld 2.1 (مجموعة غير متصلة) | 72.4% | 15.7% | 48.9% |
| Humanity’s Last Exam (بلا أدوات) | 45.9% | 10.2% | غير متاح |
| Terminal-Bench 4.0 | 39.2% | 0.0% | 16.4% |
| FrontierCode 1.1 | 46.4% | غير متاح | 42.4% |
| Chartography (بلا أدوات) | 46.4% | 6.4% | 29.1% |
| السعر لكل مليون توكن | Haiku 5.5 (حتى 100 ألف / أكثر) | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|
| قراءة الذاكرة المؤقتة | 0.01 / 0.05 دولار | 0.10 دولار | 0.10 دولار |
| كتابة الذاكرة المؤقتة | 0.125 / 0.625 دولار | 1.25 دولار | 2.50 دولار |
| الإدخال | 0.10 / 0.50 دولار | 1.00 دولار | 2.00 دولار |
| الإخراج | 0.50 / 2.50 دولار | 5.00 دولارات | 10.00 دولارات |
أمثلة عملية على Haiku 5.5
تؤكد شهادات العملاء في إعلان Haiku 5.5 أن قيمته في السرعة والحجم. فقد اختبرته Asana في منتجها AI Teammates على مهام مثل فرز الأخطاء وإعداد المشاريع. وسجلت انخفاضا في زمن الإنجاز تجاوز 30%. كذلك وصل تسريع الاستدلال لكل دورة وكيل إلى 2.5 ضعف. أما HubSpot فسجل النموذج عندها 92.8% على اختبار CRM، وكان الأسرع في كشف السجلات القديمة الملتبسة بأعلى نسبة إصابة وأقل نسبة إنذار كاذب.
وتدير AlphaSense ميزة Ask in Document بنحو 8 ملايين استدعاء أسبوعيا. وفي 400 استعلام سجل Haiku 5.5 نتيجة 0.84 مقابل 0.76 للإصدار السابق. كذلك سجلت Box تفوقا بـ11 نقطة بنصف زمن الاستجابة تقريبا. أما Rogo فتستخدمه وكيلا فرعيا يستخرج سطر إيرادات القطاع من تقرير 10-K بينما يبني نموذج أكبر العرض. وهذه الأمثلة التالية توضيحية من عندي، فجربها على بياناتك قبل أن تعمّمها على مشروعك.
- تصنيف رسائل الدعم: تطلب تصنيف الرسالة إلى فاتورة أو مشكلة تقنية أو شكوى. ثم تطلب النتيجة بصيغة JSON.
- تلخيص الاجتماعات: يلخص مئات النصوص يوميا. وبذلك تحصل على خمس نقاط لكل نص.
- وكيل فرعي: يستخرج رقما محددا من تقرير طويل. ثم يسلمه لنموذج أكبر يبني التحليل.
- استعلام قاعدة بيانات: يحول سؤالا بالعربية إلى استعلام SQL بسيط.
متى تختار Haiku 5.5 من أحدث إصدارات Claude AI وما حدوده؟
اختر Haiku 5.5 عندما يكون الحجم كبيرا والزمن مهما. فهو يناسب خدمة العملاء الحية والتصفح الآلي. كذلك يناسب المهام المتكررة التي تصل إلى آلاف الطلبات. وهو يحقق أفضل قيمة مع الطلبات التي لا تتجاوز 100 ألف توكن، وهي غالبية الاستخدام الفعلي حسب أرقام أنثروبيك. ومن بين أحدث نماذج Claude AI يبقى هذا النموذج الأنسب لأي نظام يعالج كميات ضخمة من النصوص القصيرة.
أما حدوده فواضحة. فلا تستخدمه للبرمجة الوكيلية المعقدة، لأن الفرق بين 39.2% و70.6% على Terminal-Bench كبير. كذلك تقول أنثروبيك إن ضمانات الأمن السيبراني فيه أشد من Haiku 4.5. لكنها أخف قليلا من بقية النماذج الحديثة. فهي تسمح بمهام دفاعية أوسع من Sonnet 5.5. ومع ذلك تحجب اختبار الاختراق والتقنيات التي يستخدمها المهاجمون. وتطبق على الأحياء الضمانات نفسها المطبقة على Sonnet 5 وSonnet 5.5 وOpus 5.
وإذا كنت تنتقل من Haiku 4.5 فاختبر التكلفة الفعلية أولا. فالمرمز الجديد يستهلك توكنات أكثر قليلا، كما ذكرت الشركة. كذلك يمكنك ضبط مستوى الجهد لتوازن بين التكلفة والذكاء. وتنصح أنثروبيك بقراءة دليل الترحيل الرسمي قبل التبديل. وبعد ذلك ابدأ بعينة صغيرة من طلباتك، ثم وسّع الاستخدام تدريجيا إذا جاءت النتائج مرضية.
مقارنة بين نماذج أحدث إصدارات Claude AI الثلاثة
عند النظر إلى أحدث إصدارات Claude AI مجتمعة تظهر قاعدة واضحة. فـOpus يتولى التفكير الصعب والقرارات المكلفة. أما Sonnet فيتولى العمل اليومي من برمجة ومستندات وتحليل. بينما يتولى Haiku الحجم الكبير والمهام الصغيرة السريعة. لذلك لا يوجد نموذج واحد يناسب كل شيء. بل يوجد توزيع ذكي للأدوار. وهذا التوزيع هو ما تحاول أنثروبيك تسويقه بجعل الأسعار والسرعات مختلفة بدرجة واضحة بين النماذج الثلاثة.
وللتوضيح خذ مثالا حسابيا بسيطا مبنيا على صفحة الأسعار الرسمية. افترض أنك تعالج 10 ملايين توكن إدخال بطلبات أقل من 100 ألف توكن. يكلفك Haiku 5.5 نحو دولار واحد. ويكلفك Sonnet 5.5 نحو 20 دولارا. أما Opus 5.5 فيكلفك نحو 40 دولارا. وهذا حساب للإدخال فقط. فهو لا يشمل الإخراج ولا الذاكرة المؤقتة. ومع ذلك يوضح فرق الحجم بين النماذج الثلاثة، ويبين كيف يتضاعف الفرق مع آلاف الطلبات اليومية.
| النموذج | تاريخ الإطلاق | المعرّف | الإدخال / الإخراج لكل مليون توكن | الأنسب لـ |
|---|---|---|---|---|
| Haiku 5.5 | 7 أكتوبر 2026 | claude-haiku-5-5 | 0.10 / 0.50 دولار (حتى 100 ألف) | تصنيف، تلخيص، وكيل فرعي |
| Sonnet 5.5 | 28 سبتمبر 2026 | claude-sonnet-5-5 | 2 / 10 دولارات | برمجة يومية، مستندات، عروض |
| Opus 5.5 | 22 سبتمبر 2026 | claude-opus-5-5 | 4 / 20 دولارا | أعمال معقدة، قرارات معمارية |
كيف توزع العمل بين النماذج الثلاثة؟
أفضل نمط عملي أن يقود نموذج كبير ويبني نموذج صغير. فـOpus يضع الخطة والبنية العامة. بعد ذلك ينفذ Sonnet الأجزاء الواضحة. ثم يعالج Haiku المهام الصغيرة المتكررة. ومن أمثلتها قراءة ملفات كثيرة واستخراج أرقام. وقد رأينا هذا النمط في أداة Devin Fusion، كما في شهادة Cognition. ورأيناه أيضا في شهادة مطور Creator على صفحة Sonnet 5.5. وهذا يؤكد أن توزيع الأدوار صار ممارسة فعلية عند الفرق المحترفة.
وانظر إلى موقع محتوى كبير كمثال توضيحي. يستطيع Opus تصميم استراتيجية المحتوى وهيكل الأقسام. بعد ذلك يكتب Sonnet المسودات ويصلح الأخطاء التقنية. أما Haiku فيصنف آلاف التعليقات أو المقالات القديمة. ويحدث ذلك في ساعات قليلة وبتكلفة صغيرة. وهكذا تدفع ثمن الذكاء العالي حيث تحتاجه فقط. وتصلح هذه الفكرة لأي موقع أو شركة تعمل بآلاف المهام الصغيرة وعدد قليل من القرارات الكبيرة.
ولا تعتمد على تخمين واحد. فابدأ بـ Sonnet 5.5 عند جهد متوسط. ثم راقب النتائج على 20 مهمة حقيقية من عملك. بعد ذلك انقل المهام البسيطة المتكررة إلى Haiku. وصعّد الصعب منها إلى Opus. وتذكر أن كل أرقام الأداء هنا صادرة عن أنثروبيك. لذلك يبقى اختبارك الخاص هو الحكم الأخير. فالاختبار على بياناتك يكشف ما لا تكشفه أي جداول منشورة.
تخفيضات الأسعار في أحدث إصدارات Claude AI ورصيد API
في 7 أكتوبر خفضت أنثروبيك سعر قراءة الذاكرة المؤقتة في Sonnet 5.5 بنسبة 50%، كما أعلنت في صفحة Haiku 5.5 الرسمية. فصار السعر 0.10 دولار لكل مليون توكن، وكان قبل ذلك 0.20 دولار. وتشكل هذه القراءات حصة كبيرة من استهلاك التوكنات في المهام الوكيلية. لذلك تقول الشركة إن تكلفة Sonnet 5.5 انخفضت نحو 20% في معظم هذه الأعمال. وهذا الخفض واحد من أهم تغييرات أحدث إصدارات Claude AI لمن يشغل وكلاء يعملون ساعات طويلة.
كذلك أعلنت أنثروبيك رصيد API شهريا لكل مشتركي Max وTeam. ويستخدم هذا الرصيد على منصة Claude لتجربة بناء الأدوات والتطبيقات والوكلاء، ويصلح لأي نموذج. وبدأ الطرح في الأسبوع نفسه، وتجد تفاصيله في مقالة مركز المساعدة. ويوضح الجدول التالي قيمة الرصيد لكل خطة. وتفيد هذه القيمة من يريد أن يجرب نموذجا جديدا في مشروع صغير دون أن يخصص له ميزانية إضافية من البداية.
| الخطة | الرصيد الشهري |
|---|---|
| Max 5x | 100 دولار |
| Max 20x | 200 دولار |
| Team | حتى 500 دولار، مشتركة بين المستخدمين |
ما هي قراءة الذاكرة المؤقتة ولماذا تهم؟
تعمل الذاكرة المؤقتة للمطالبات (Prompt Caching) بفكرة بسيطة. فأنت تدفع مرة واحدة لكتابة الجزء الثابت من المطالبة. ومن أمثلته التعليمات والمستندات الطويلة. بعد ذلك تدفع سعرا أقل بكثير عند قراءته في كل طلب لاحق. وفي المهام الوكيلية يعيد النموذج قراءة سياق طويل في كل خطوة. ولهذا تهيمن Cache Reads على التكلفة. وتشرح صفحة الأسعار الرسمية أسعار الكتابة والقراءة لكل نموذج.
وإليك حسابا توضيحيا. لنفترض أن جلسة وكيل قرأت 50 مليون توكن من الذاكرة المؤقتة. فبسعر 0.20 دولار تدفع 10 دولارات. أما بسعر 0.10 دولار فتدفع 5 دولارات فقط. وهذا توفير 50% في بند القراءة وحده. لكنه ينعكس كنحو 20% على التكلفة الكلية، كما تقول أنثروبيك. والسبب أن التكلفة الكلية تشمل بنودا أخرى، مثل الإدخال الجديد والإخراج وكتابة الذاكرة. لذلك لا تتوقع أن يهبط فاتورتك إلى النصف.
ولتستفيد أكثر، رتب مطالباتك بحيث يأتي الجزء الثابت أولا. فضع التعليمات والمستندات المرجعية في البداية. ثم أضف السؤال المتغير في النهاية. وبهذا تتطابق البادئة بين الطلبات، فتزيد فرص القراءة من الذاكرة المؤقتة. كذلك تجنب تغيير الجزء الثابت بين طلب وآخر، لأن أي تغيير فيه يبطل الاستفادة. وراجع توثيق Claude Platform لمعرفة مدة بقاء الذاكرة وأحجامها الدنيا قبل أن تصمم نظامك.
Claude Code 2.1.302: تحكم أكبر ضمن أحدث إصدارات Claude AI
Claude Code هي أداة أنثروبيك لتفويض مهام البرمجة إلى Claude. وتعمل من سطر الأوامر وتطبيقات سطح المكتب والجوال، كما يشرح التوثيق الرسمي. وقد صدر الإصدار 2.1.302 في 16 أكتوبر 2026، بعد يوم واحد من الإصدار 2.1.301. وحسب موقع Havoptic كان هذا الإصدار رقم 244 في 2026. كذلك بلغ عدد الإصدارات في الشهر الأخير 25 إصدارا. وهذه وتيرة سريعة تجعل الأداة من أكثر أجزاء أحدث إصدارات Claude AI تغيرا.
تلخص ملاحظات الإصدار التحديث في نقطتين. الأولى هي تحكم أكبر في طريقة عمل الوضع التلقائي (Auto Mode) على جهازك. والثانية هي إصلاح أخطاء كانت تقطع المحادثات. وبعضها كان يظهر عند التبديل بين مزودي الخدمة. لذلك يستحق التحديث من يعمل في جلسات طويلة. وكذلك من ينتقل بين Vertex وBedrock أثناء الجلسة. وتصلح هذه التحسينات للفرق التي تعتمد على الأداة في عملها اليومي، لأن الأخطاء المتكررة تضيع وقتا أكثر مما يبدو.
ولا ينتهي الأمر عند 2.1.302. فبحسب الموقع نفسه وصلت السلسلة إلى 2.1.312 في 27 أكتوبر. لذلك حدّث الأداة بانتظام. وراجع ملف CHANGELOG الرسمي على GitHub لمعرفة كل تغيير بدقة. كما يمكنك تثبيت الأداة من حزمة npm الرسمية. وإذا كنت تدير فريقا، فاتفق على نسخة محددة بين الأعضاء. فهذا يقلل المفاجآت عندما يختلف سلوك الأداة من جهاز إلى آخر.
أبرز ما تغير في Claude Code ضمن أحدث إصدارات Claude AI
أضاف الإصدار خيارات جديدة تخص التحكم والاستقرار، وفق ملاحظات الإصدار على Havoptic. فهو يسمح باختيار النموذج الذي يستخدمه مصنف الوضع التلقائي على جهازك. لكن هذا الخيار لا يغير النموذج الذي يعمل على جانب الخادم. كذلك أضاف صفا جديدا في الأمر /config. وهذا الصف يشغل ضغط الخمول (Idle Compaction) أو يوقفه. وصارت الإشعارات بعد هذا الضغط تشرح طريقة إيقافه. وبذلك يعرف المستخدم ما حدث لمحادثته ولماذا.
وتتضمن القائمة التالية أهم التغييرات، وكلها منقولة من ملاحظات الإصدار الرسمية. فإذا كنت تستخدم Claude Code يوميا، فستلاحظ بعضها مباشرة. أما إذا كنت تستخدمه أحيانا فقط، فتكفيك معرفة الإصلاحات التي تمنع الأخطاء الغامضة. وتبقى النقطة الأخيرة عن Claude Design مهمة لمن يعتمد عليه، لأن موعد الإغلاق قريب.
- متغير بيئة جديد: يحدد نموذج المصنف في الوضع التلقائي على جانب العميل.
- خيار Idle Compaction: صف جديد في
/configللتحكم في ضغط المحادثة عند الخمول. - إشعار Claude Design: يظهر في
/design-syncو/design-login. ويقول إن النسخة المستقلة claude.ai/design تغلق في 14 ديسمبر 2026. - إصلاح خطأ Prompt is too long: كان يظهر عند إيقاف دورة أثناء ضغط المحادثة.
- إصلاح التبديل بين المزودين: كانت الطلبات تفشل بعد التبديل إلى Vertex أو Bedrock أثناء الجلسة.
- إصلاح أداة Read: عولجت مشكلة في قراءة ملفات الصور.
استخدام النماذج الجديدة داخل Claude Code
تعمل نماذج 5.5 كلها داخل Claude Code. لتجربة Haiku 5.5 اكتب في الطرفية الأمر claude --model claude-haiku-5-5، كما يوضح دليل ClaudeLog. ويذكر الدليل أن الإصدار 2.1.293 هو أول إصدار يعرف هذا النموذج. لذلك تأكد أن نسختك أحدث منه. وبعد ذلك ابدأ التجربة على مهمة صغيرة. وهكذا تتعرف على سلوك النموذج وسرعته قبل أن تعتمد عليه في مشروع كامل.
وانتبه إلى مستوى الجهد الافتراضي. فـClaude Code وتطبيقات Claude تستخدم الجهد المتوسط. بينما تستخدم Claude Platform الجهد العالي، كما تذكر صفحة Sonnet 5.5. لذلك إذا لاحظت أداء أبطأ أو أغلى من توقعك، فتحقق من هذا الإعداد أولا. وتقترح أنثروبيك البدء بالمتوسط للبرمجة المحددة جيدا. أما المهام الغامضة فقد تحتاج إلى جهد أعلى، لكن بعد أن تجرب المتوسط وتتأكد أنه لا يكفي.
كذلك استفد من الوكلاء الفرعيين. اجعل Opus 5.5 أو Sonnet 5.5 يقود الجلسة. ثم دع Haiku 5.5 يقرأ الملفات ويلخصها. وإذا بدلت حسابك في منتصف جلسة تستخدم Sonnet 5.5، فاقرأ توثيق التفكير المحفوظ. لأن هذا التبديل قد يتأثر. وهذه نقطة صغيرة لكنها توفر عليك أخطاء غامضة. وتساعدك هذه الخطوات على الاستفادة من أحدث إصدارات Claude AI داخل بيئة عمل واحدة بدل التنقل بين أدوات كثيرة.
سياسة الاستخدام الجديدة وأحدث إصدارات Claude AI
ضمن أحدث إصدارات Claude AI جاءت أيضا نسخة جديدة من Usage Policy. نشرتها أنثروبيك في 8 أكتوبر 2026، وتسري في 12 نوفمبر، كما يوضح إعلان السياسة الرسمي. وهي أول مراجعة كبيرة منذ أكثر من عام. فقد بدأت النسخة السابقة في 15 سبتمبر 2025، وفق ملخص Penchan. وتبقى النسخة القديمة سارية حتى موعد البدء. لذلك يملك أصحاب التطبيقات أسابيع قليلة لمراجعة استخدامهم قبل أن تصبح القواعد الجديدة ملزمة.
تقول الشركة إن معظم التعديلات توضيحية. فقد صار Claude يعمل أطول وبقدر أكبر من الاستقلال خلال العام الماضي. لذلك أضافت أمثلة جديدة تبين كيف تنطبق القواعد على هذه القدرات. كما استندت إلى أنماط إساءة استخدام رصدتها في تقرير التهديدات السيبرانية لشهر سبتمبر. وأبرز هذه الأنماط عمليات التأثير وتطوير الأسلحة والمراقبة. وهذا يفسر لماذا تركز التعديلات الجديدة على الاستخدامات الأكثر خطورة، بدل أن تغير القواعد العامة للمستخدم العادي.
أهم التغييرات في سياسة الاستخدام
أضافت أنثروبيك قسما جديدا عن الحملات المضللة. كذلك أعادت كتابة أقسام الانتخابات والأسلحة والمراقبة. ثم أعادت صياغة متطلبات الحالات عالية المخاطر. وصارت القائمة تحدد التوصيات المشمولة وغير المشمولة. وبذلك تجيب مباشرة عن سؤال متكرر: أي الاستخدامات يخضع لهذه المتطلبات؟ وتجد هذه التفاصيل كلها في النص الكامل للسياسة، لذلك ارجع إليه عند أي شك في حالة استخدام محددة.
وأضافت الشركة ضوابط جديدة عندما يتصل Claude بأجهزة تتخذ إجراءات مادية مستقلة، بعد إطلاق معيار عتاد النماذج. كما أضافت منعا لسلوك القسوة المتكررة بلا هدف ضد النماذج. وتوضح النقاط التالية أهم هذه التغييرات، وكلها مأخوذة من إعلان أنثروبيك. وقد صغتها بكلماتي لتسهل قراءتها على المطور وصاحب الموقع.
- النشاط المضلل: قسم جديد يجمع القواعد المتفرقة عن الحسابات الوهمية ومواقع الأخبار المفبركة. ويشمل عمليات التأثير السياسية والتجارية.
- الانتخابات: صار القسم يركز على خداع الناخبين وتعطيل الانتخابات. وأزالت الشركة المنع الشامل على الاستهداف المخصص للتصويت.
- الأسلحة: يشمل المنع السوفت وير والهاردوير التي تشغل السلاح. ويشمل أيضا تسليح الطائرات المسيرة والمركبات الذاتية.
- المراقبة وإنفاذ القانون: يمنع تتبع الأشخاص دون موافقتهم. كما يمنع استخدام Claude لتحديد من يحقق معه أو يعتقل أو يتهم.
- الحالات عالية المخاطر: ما يؤثر على الصحة والحقوق القانونية والمال والرزق يتطلب إنسانا مؤهلا. وهذا الإنسان يراجع التوصيات ويغيرها عند الحاجة. كما يجب إبلاغ المتأثر بأن الذكاء الاصطناعي استخدم.
- الأجهزة المتصلة: عند ربط Claude بعتاد قد يسبب إصابات، يجب أن يراقب مشغل مؤهل الجهاز ويوقفه. كما يجب أن يبقى الجهاز في حالة آمنة إذا انقطع الاتصال.
- السلوك المسيء للنماذج: منع القسوة المتكررة بلا غرض مفهوم. ولا يشمل الإحباط العادي أو المحتوى الإبداعي المظلم أو الاختبار والبحث.
- المناطق المدعومة: توضيح لكيفية تطبيق القيود على الكيانات المسجلة أو المملوكة بأغلبية في مناطق غير مدعومة، كما في صفحة المناطق المدعومة.
ماذا تعني سياسة الاستخدام لمستخدمي أحدث إصدارات Claude AI؟
بالنسبة للمستخدم العادي يتغير القليل. فأنثروبيك تؤكد أن القاعدة الجديدة عن الإساءة للنماذج تخص الحالات القصوى. لذلك لا تشمل الإحباط العادي أو الاعتراض على الإجابة. كذلك لا تشمل الكتابة الإبداعية المظلمة. وتقول الشركة إن قدرة Claude على إنهاء المحادثات مع المسيئين المصرين تبقى وسيلة الإنفاذ الأساسية. وقد ربطت صحيفة Business Standard هذا التحديث بجدل شعبي سبقه، لكن الشركة تقدمه كتنظيم محدود.
أما بالنسبة للمطورين وأصحاب المنتجات فالأمر أهم. تخيل موقعا يقدم إرشادات صحية أو مالية مبنية على Claude. هذا الاستخدام يتطلب مراجعة من إنسان مؤهل. كما يتطلب إبلاغ المستخدم بأن الذكاء الاصطناعي ساهم. وهذه المتطلبات لم تتغير، لكن النص صار يحدد بدقة أي التوصيات مشمولة. وإذا ربطت Claude بروبوت أو ذراع آلية، فعليك توفير مشغل يراقب ويوقف. لذلك صمم نظامك من البداية ليبقى آمنا عند انقطاع الاتصال بالنموذج.
وينبغي لأصحاب المواقع الانتباه إلى بند الحملات المضللة. فاستخدام Claude لإدارة شبكات حسابات وهمية أو مواقع أخبار مفبركة ممنوع. ويسري ذلك على الأغراض السياسية والتجارية معا. كذلك نبه AWS Health مستخدمي Amazon Bedrock إلى أمر مهم، كما يوضح مقال Classmethod. فالاستمرار في الاستخدام بعد 12 نوفمبر يعني قبول الشروط الجديدة. لذلك اقرأ النص الكامل على صفحة Usage Policy. ثم قارنه بتطبيقك قبل الموعد، وسجل ملاحظاتك لفريقك القانوني أو التقني.
الخلاصة: ماذا تفعل بعد أحدث إصدارات Claude AI؟
اجتمع في هذه الأسابيع الخمسة ثلاثة نماذج وتخفيض أسعار وتحديث أداة وسياسة جديدة. فـOpus 5.5 يقود الأعمال المعقدة بسعر أقل من سابقه. أما Sonnet 5.5 فيقدم أداء قريبا من Opus بنصف السعر تقريبا. بينما يفتح Haiku 5.5 الباب لمهام ضخمة كانت مكلفة جدا. وتأتي أحدث إصدارات Claude AI مع Claude Code 2.1.302 وقواعد استخدام أوضح تبدأ في 12 نوفمبر. وتكمل هذه الأجزاء بعضها، فهي ليست أخبارا منفصلة بل حزمة واحدة لمن يبني على Claude.
برأيي الخبر الأهم ليس نموذجا بعينه، بل الكفاءة. فالنماذج الجديدة تحتاج توكنات أقل. كذلك تعمل أسرع وتكلف أقل لكل مهمة. وهذا يغير حسابات الفرق الصغيرة أكثر مما تغيرها نتيجة إضافية في اختبار. لذلك ابدأ بـ Sonnet 5.5 عند جهد متوسط. ثم وجه الأعمال الكثيرة البسيطة إلى Haiku. وصعّد إلى Opus عند الحاجة فقط. وبهذه الطريقة تحصل على أفضل نتيجة من أحدث إصدارات Claude AI دون أن ترهق ميزانيتك.
وإليك خطوات عملية قصيرة. أولا، حدّث Claude Code إلى أحدث إصدار. ثانيا، جرب كل نموذج على 10 إلى 20 مهمة حقيقية من عملك. ثالثا، راجع سياسة الاستخدام قبل 12 نوفمبر إذا كان لديك تطبيق يخدم الناس. وأخيرا، تذكر أن أرقام الأداء هنا صادرة عن أنثروبيك، وقد وضعت لك رابط كل مصدر لتتحقق منه. ولأن الأمور تتحرك بسرعة، ارجع إلى الصفحات الرسمية قبل أي قرار كبير، وتابع جديد أحدث إصدارات Claude AI أولا بأول.