هياكل البيانات (Data Structures): الدليل الشامل من الأساسيات إلى الأنظمة الحديثة

عندما يفتح المبرمج ملفا يضم ملايين السجلات، فإن هياكل البيانات هي التي تحدد هل سيجد المعلومة المطلوبة خلال لحظة أم بعد انتظار طويل. هذا الفرق لا يظهر في الأمثلة الصغيرة، لكنه يظهر بقسوة حين يكبر حجم البيانات وتتزايد الطلبات المتزامنة على النظام. فالبرنامج الذي يعمل بسلاسة على عشرة عناصر قد ينهار عند مليون عنصر. والسبب في الغالب ليس ضعف الجهاز، بل طريقة تنظيم البيانات داخل الذاكرة وطريقة الوصول إليها.
وتبدأ القصة من فكرة بسيطة، فكل برنامج يخزن المعلومات ويعالجها ويعيد عرضها. لكن الحاسوب لا يفهم الترتيب المنطقي الذي يفهمه الإنسان، فهو يتعامل مع خلايا ذاكرة مرقمة ومتتابعة. ولذلك يحتاج المبرمج إلى قواعد تنظيمية تحول هذه الخلايا إلى بنية مفهومة وقابلة للاستخدام. هذه القواعد هي ما نسميه هياكل البيانات، وهي من أول ما يدرسه طالب علوم الحاسوب، وأكثرها حضورا في المقابلات التقنية وفي الأنظمة الإنتاجية الكبيرة. ومع ذلك يستخدمها كثير من المطورين دون فهم آلية عملها الداخلية.
وفي هذا الدليل المرجعي سنبني الصورة كاملة وبالتدريج. سنبدأ بالمفهوم الأساسي وكيفية تخزين البيانات في الذاكرة، ثم ننتقل إلى الأنواع الرئيسية مثل المصفوفات والقوائم المرتبطة والمكدسات والطوابير، وصولا إلى الأشجار والرسوم البيانية والهياكل المتقدمة. كما سنتناول تحليل الكفاءة وترميز Big O، ونوضح الفرق بينها وبين قواعد البيانات ومراكز البيانات. وفي النهاية ستعرف كيف تختار الهيكل المناسب لكل مهمة، وكيف تتعلم هذا المجال عمليا خطوة بعد خطوة.
جدول المحتويات
- ما هي هياكل البيانات؟
- تاريخ هياكل البيانات
- كيف تعمل هياكل البيانات؟
- ما أنواع هياكل البيانات؟
- المصفوفات (Arrays) في هياكل البيانات
- القوائم المرتبطة بهياكل البيانات
- ما هي القوائم المرتبطة (Linked Lists)؟
- كيف تتكون العقد (Nodes) والمؤشرات والمراجع (Pointers and References)؟
- القائمة المرتبطة أحادية الاتجاه (Singly Linked List)
- القائمة المرتبطة ثنائية الاتجاه (Doubly Linked List)
- القائمة المرتبطة الدائرية (Circular Linked List)
- كيفية إدراج العناصر وحذفها والبحث عنها
- مزايا القوائم المرتبطة وعيوبها
- الفرق بين المصفوفات والقوائم المرتبطة
- مثال عملي على إنشاء قائمة مرتبطة والتعامل مع عناصرها
- المكدسات (Stacks) في هياكل البيانات
- الطوابير (Queues)
- ما هو الطابور (Queue)؟
- مبدأ أول من يدخل أولا يخرج (First In, First Out, FIFO)
- العمليات الأساسية للطابور: Enqueue وDequeue وFront
- الطابور الدائري (Circular Queue)
- طابور الأولوية (Priority Queue)
- الطابور مزدوج النهاية (Deque)
- استخدامات الطوابير في أنظمة التشغيل والشبكات ومعالجة المهام
- الفرق بين المكدسات والطوابير
- مثال عملي على إنشاء طابور بلغة Python
- جداول التجزئة (Hash Tables) في هياكل البيانات
- ما هي جداول التجزئة؟
- كيف تعمل دالة التجزئة (Hash Function)؟
- ما هو التصادم (Collision) في جداول التجزئة؟
- طرق معالجة التصادم: التسلسل المنفصل والعنونة المفتوحة
- عوامل التحميل (Load Factor) وإعادة بناء الجدول (Rehashing)
- مزايا جداول التجزئة وعيوبها
- استخدامات جداول التجزئة في البحث السريع والتخزين المؤقت
- مثال عملي على استخدام القواميس في Python بوصفها تطبيقا لجداول التجزئة
- هياكل البيانات: المجموعات والقواميس (Sets & Maps)
- هياكل البيانات الشجرية (Tree Data Structures)
- ما هي هياكل البيانات الشجرية؟
- مكونات الشجرة: الجذر والعقد والأبناء والأوراق والمستويات والارتفاع
- الشجرة الثنائية (Binary Tree)
- شجرة البحث الثنائية (Binary Search Tree – BST)
- كيفية البحث والإدراج والحذف في شجرة البحث الثنائية
- الأشجار المتوازنة وأهميتها
- شجرة AVL
- شجرة الأحمر والأسود (Red-Black Tree)
- أشجار B و B+
- شجرة Trie للبحث عن الكلمات والبادئات
- اجتياز الأشجار: Preorder و Inorder و Postorder و Level Order
- مثال عملي على إنشاء شجرة بحث ثنائية والتعامل معها
- هيكل البيانات Heap: الأكوام في البرمجة
- هياكل البيانات البيانية (Graph Data Structures)
- ما هي الرسوم البيانية في الداتا ستركشر؟
- الرؤوس (Vertices) والحواف (Edges)
- الرسوم البيانية الموجهة وغير الموجهة
- الرسوم البيانية الموزونة وغير الموزونة
- الرسوم البيانية المتصلة وغير المتصلة
- تمثيل الرسوم البيانية باستخدام قائمة التجاور ومصفوفة التجاور
- الفرق بين قائمة التجاور ومصفوفة التجاور
- استخدامات الرسوم البيانية في الشبكات والخرائط والعلاقات الاجتماعية
- مثال عملي على تمثيل رسم بياني بلغة Python
- شرح وتنفيذ الشيفرة البرمجية للرسم البياني
- هياكل البيانات المتقدمة
- تحليل كفاءة هياكل البيانات
- ماذا تعني كفاءة هيكل البيانات؟
- التعقيد الزمني (Time Complexity)
- التعقيد المكاني (Space Complexity)
- فهم ترميز Big O بصورة مبسطة
- الفرق بين O(1) وO(log n) وO(n) وO(n log n) وO(n²)
- أفضل حالة ومتوسط الحالة وأسوأ حالة
- مقارنة كفاءة العمليات الأساسية في هياكل البيانات
- لماذا لا تكفي سرعة العملية وحدها للحكم على أفضل هيكل بيانات؟
- كيف تختار هيكل البيانات المناسب؟
- تحديد طبيعة البيانات وطريقة استخدامها
- الاختيار بناء على سرعة البحث والإضافة والحذف
- الاختيار بناء على استهلاك الذاكرة
- الاختيار بناء على ترتيب البيانات وإمكانية تكرار العناصر
- اختيار هيكل البيانات حسب طبيعة التطبيق البرمجي
- أمثلة عملية لاختيار الهيكل المناسب في مواقف مختلفة
- أخطاء شائعة عند اختيار هياكل البيانات
- الفرق بين هياكل البيانات وقواعد البيانات ومراكز البيانات
- الفرق بين هياكل البيانات (Data Structures) وقواعد البيانات (Databases)
- مقارنة بين هياكل البيانات وقواعد البيانات
- كيف ترتبط هياكل البيانات بقواعد البيانات؟
- الفرق بين هياكل البيانات (Data Structures) ومراكز البيانات (Data Centers)
- مقارنة بين هياكل البيانات ومراكز البيانات
- كيف تعمل هياكل البيانات داخل الأنظمة المستضافة في مراكز البيانات؟
- استخدامات هياكل البيانات في التطبيقات والأنظمة الحديثة
- هياكل البيانات في تطوير تطبيقات الويب
- هياكل البيانات في تطبيقات الهواتف والأجهزة الذكية
- هياكل البيانات في أنظمة التشغيل وإدارة الذاكرة
- هياكل البيانات في الشبكات والاتصالات
- هياكل البيانات في محركات البحث واسترجاع المعلومات
- هياكل البيانات في الألعاب و المحاكاة الافتراضي ة والواقع الممتد
- هياكل البيانات في الذكاء الاصطناعي والتعلم الآلي
- هياكل البيانات في الذكاء الاصطناعي التوليدي ومعالجة النصوص
- هياكل البيانات في أنظمة الملفات وإدارة الموارد
- العلاقة بين هياكل البيانات والخوارزميات
- هياكل البيانات في لغات البرمجة
- هياكل البيانات الأساسية في Python
- هياكل البيانات في Java
- هياكل البيانات في C وC++
- JavaScript: المصفوفات المتغيرة، الكائنات (Objects)، Map/Set
- كيف تختلف طريقة تنفيذ هياكل البيانات بين لغات البرمجة؟
- هل توفر لغات البرمجة هياكل بيانات جاهزة أم يجب بناؤها يدويا؟
- مقارنة بين هياكل البيانات المدمجة والمخصصة
- الفرق بين الهياكل المدمجة (Built-in) والهياكل التي تبنيها يدوياً (Custom Implementation)
- الأخطاء الشائعة عند التعامل مع هياكل البيانات
- كيف تتعلم هياكل البيانات وتطبقها عمليا؟
- كيف تختبر صحة تنفيذ هيكل البيانات وكفاءته؟
- الأدوار الوظيفية والقيمة التشغيلية لهياكل البيانات
- الفوائد والمكاسب التقنية لاستخدام هياكل البيانات
- مفهوم التعقيد الزمني وسلوك نمو الدوال
- الأسئلة الشائعة حول هياكل البيانات
- ما المقصود بهياكل البيانات باختصار؟
- ما أشهر أنواع هياكل البيانات؟
- ما الفرق بين هياكل البيانات الخطية وغير الخطية؟
- ما الفرق بين المصفوفة والقائمة المرتبطة؟
- ما الفرق بين المكدس والطابور؟
- ما أفضل هيكل بيانات للبحث السريع؟
- هل تختلف هياكل البيانات من لغة برمجة إلى أخرى؟
- هل يمكن تعلم هياكل البيانات دون معرفة متقدمة بالرياضيات؟
- ما العلاقة بين هياكل البيانات والخوارزميات؟
- ما الفرق بين هياكل البيانات وقواعد البيانات؟
- ما الفرق بين هياكل البيانات ومراكز البيانات؟
- لماذا تعد هياكل البيانات مهمة لمبرمجي البرمجيات؟
- الخاتمة
ما هي هياكل البيانات؟
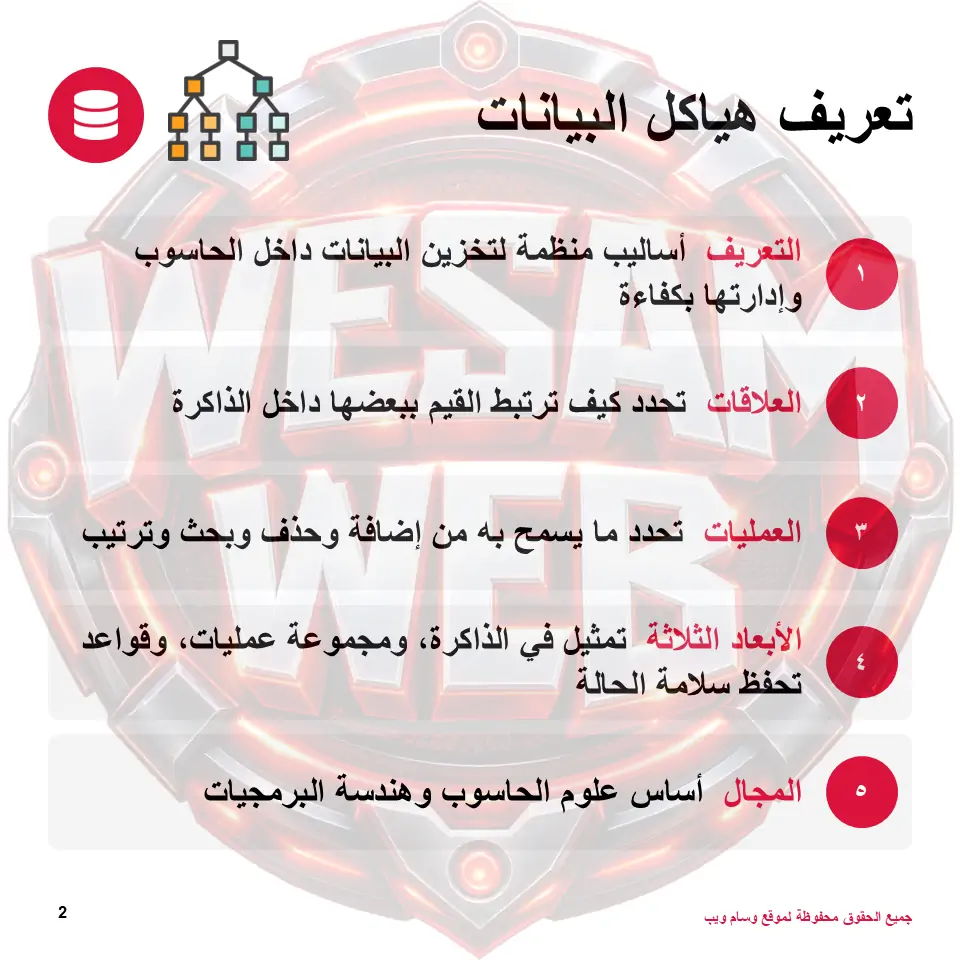
هياكل البيانات (Data Structures) هي تراكيب تُستخدم لتنظيم البيانات وتمثيلها داخل الحاسوب، وتحديد العلاقات بين عناصرها، بما يتيح الوصول إليها ومعالجتها بكفاءة. ويختلف كل هيكل في طريقة تنظيمه للبيانات والعمليات التي يدعمها، ولذلك يؤثر اختياره في كفاءة تنفيذ العمليات مثل الإضافة والحذف والبحث والتعديل. ومن هنا تأتي أهمية اختيار هيكل البيانات المناسب لطبيعة المشكلة التي يعالجها البرنامج.
وتتجلى أهمية هذا المفهوم في أن البرمجيات الحديثة تتعامل مع كميات هائلة من المعلومات في كل ثانية. فتطبيق التجارة الإلكترونية يخزن المنتجات وسلات الشراء والطلبات، ومحرك البحث يفهرس مليارات الصفحات. وفي كل حالة، يحدد الهيكل المستخدم مقدار الزمن والذاكرة اللذين يستهلكهما النظام. لذلك يعد فهم هذا المجال مهارة تأسيسية لا غنى عنها لكل من يعمل في تطوير البرمجيات أو هندسة النظم أو الذكاء الاصطناعي.
ولكي تتضح الصورة، سنقسم هذا القسم إلى محاور متكاملة. سنبدأ بالتعريف الدقيق في سياق علوم الحاسوب، ثم نشرح سبب الحاجة إليها في البرمجة. بعد ذلك ننتقل إلى كيفية تنظيمها للمعلومات، ونوضح الفرق بين البيانات وهياكلها. وأخيرا نختم بأمثلة من الحياة اليومية تجعل الفكرة ملموسة وسهلة الاستيعاب.
تعريف هياكل البيانات في علوم الحاسوب
في علوم الحاسوب، يقصد بهيكل البيانات أي صيغة تنظيمية تجمع مجموعة من القيم وتحدد العلاقات بينها والعمليات التي يمكن تنفيذها عليها. ويتكون الهيكل عادة من ثلاثة أبعاد مترابطة. البعد الأول هو تمثيل البيانات داخل الذاكرة، والبعد الثاني هو مجموعة العمليات المتاحة، والبعد الثالث هو القواعد التي تضمن سلامة الحالة بعد كل عملية. وهذا التعريف يفسر لماذا لا تعد القيمة المفردة هيكلا، فالرقم 5 مثلا بيانات فقط، بينما المصفوفة التي تضم عشرة أرقام هيكل له قواعد العمليات.
ومن الناحية الأكاديمية، تقع هذه الهياكل عند ملتقى فرعين أساسيين. الفرع الأول هو التمثيل المنطقي، أي الصورة التي يراها المبرمج عند التعامل مع الهيكل. الفرع الثاني هو التمثيل الفيزيائي، أي الطريقة التي يحجز بها النظام الذاكرة ويخزن بها العناصر فعليا. وقد يختلف التمثيلان كثيرا. فـالطابور مثلا يبدو منطقيا كصف من العناصر، لكنه قد يخزن فيزيائيا داخل مصفوفة أو قائمة مرتبطة. وهذا الفصل بين الواجهة والتنفيذ من أقوى الأفكار في هندسة البرمجيات.
وتجدر الإشارة إلى أن هذه المفاهيم لا ترتبط بلغة برمجة معينة، فهي واحدة سواء كتبت بلغة Python أو Java أو C++. ما يتغير هو طريقة التنفيذ وحجم الدعم الجاهز من اللغة. ولهذا يعد التعلم هنا استثمارا طويل الأمد، لأن المعرفة المكتسبة تنتقل مع المطور من لغة إلى أخرى. كما أن الخوارزميات تعمل فوق هذه الهياكل وترتبط بها ارتباطا وثيقا، وهي علاقة سنفصلها في قسم مستقل لاحقا.
لماذا نحتاج إلى هياكل البيانات في البرمجة؟
يحتاج المبرمج إلى هذه الهياكل لأن البيانات الخام وحدها لا تكفي لبناء نظام فعال. فعندما تتراكم المعلومات دون تنظيم، يصبح البحث عن عنصر واحد عملية بطيئة، ويصبح التعديل عليه محفوفا بالأخطاء. أما عند اختيار الهيكل الصحيح، فتتحول العمليات الثقيلة إلى خطوات قليلة وسريعة. وتظهر حجم الحاجة في أن 57.9% من المطورين استخدموا لغة Python وفق استطلاع Stack Overflow لعام 2025، وهي لغة تضع القوائم والقواميس والمجموعات في متناول كل مبتدئ.
وفي الواقع العملي، تظهر الحاجة عند مواجهة مشكلات يومية متكررة. فمطور التطبيقات يحتاج إلى التحقق من تكرار اسم المستخدم خلال أجزاء من الثانية، ومطور الأنظمة يحتاج إلى جدولة المهام حسب الأولوية. كما يحتاج مهندس الشبكات إلى إيجاد أقصر مسار بين جهازين. وكل مشكلة من هذه تجد حلها الطبيعي في هيكل محدد، وهو ما يجعل الاختيار الصحيح أهم من كتابة الشيفرة نفسها. فمن اختار هيكلا خاطئا لن تنقذه أفضل صياغة برمجية.
ويمكن تلخيص أبرز الأسباب التي تجعلها ضرورية في البرمجة فيما يلي:
- تسريع البحث والوصول إلى العناصر داخل المجموعات الكبيرة.
- تقليل استهلاك الذاكرة عبر تمثيل البيانات بالشكل الأنسب لطبيعتها.
- تبسيط منطق البرنامج وجعل الشيفرة أوضح وأسهل في الصيانة.
- دعم قابلية التوسع حين تتضاعف البيانات وأعداد المستخدمين.
- إتاحة حلول جاهزة لمشكلات متكررة مثل الترتيب والجدولة والتوجيه.
كيف تساعد هياكل البيانات على تنظيم المعلومات والوصول إليها؟
تنظم هذه الهياكل المعلومات عبر فرض ترتيب أو علاقة محددة بين العناصر. فبعضها يرتب العناصر في تسلسل خطي يسهل المرور عليها واحدا بعد الآخر، كما في المصفوفات والقوائم. وبعضها يبنيها في تفرعات هرمية تسرع البحث، كما في الأشجار. وبعضها يربط العناصر بشبكة علاقات معقدة، كما في الرسوم البيانية. وهكذا يتحول التنظيم من مجرد ترتيب شكلي إلى أداة تقلل الجهد الحاسوبي المطلوب.
أما الوصول إلى المعلومة، فيعتمد على آلية الفهرسة التي يتيحها الهيكل. فالمصفوفة تصل إلى أي عنصر عبر رقم موقعه مباشرة، بينما تحتاج القائمة المرتبطة إلى المرور على العقد واحدة تلو الأخرى. وتصل جداول التجزئة إلى القيمة عبر مفتاحها في زمن شبه ثابت. وتختلف هذه الآليات اختلافا كبيرا في السرعة، ولذلك يقاس الأداء بما يسمى التعقيد الزمني الذي سنشرحه بالتفصيل في قسم تحليل الكفاءة.
ولا يقتصر التنظيم على السرعة فقط، بل يمتد إلى سلامة البيانات وسهولة التعامل معها. فالمكدس مثلا يمنع المبرمج من الوصول إلى العنصر الأوسط، وهذا القيد يحمي منطق البرنامج من الأخطاء. وكذلك تمنع المجموعات تكرار العناصر تلقائيا. وبذلك تعمل هذه الهياكل كعقد التزام بين المبرمج والنظام، فتحدد ما يمكن فعله وما يجب تجنبه، وتجعل سلوك البرنامج أكثر قابلية للتوقع.
ما الفرق بين البيانات وهياكل البيانات؟
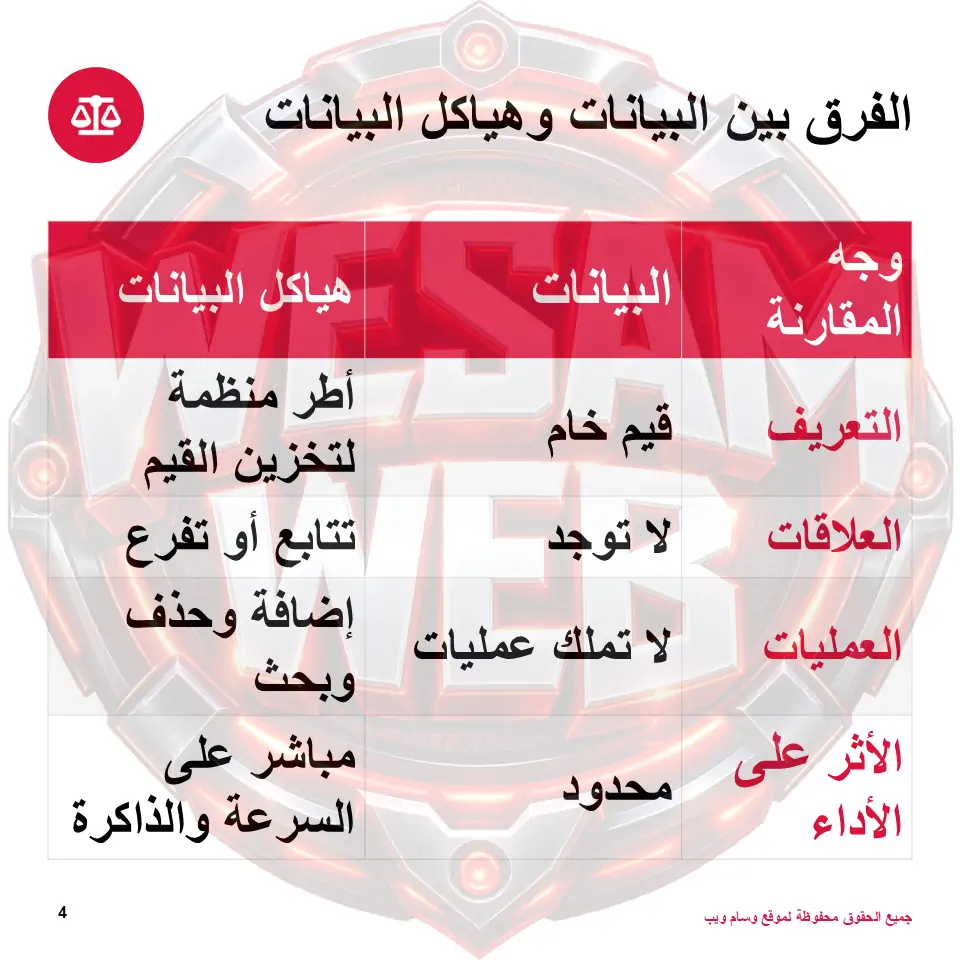
البيانات هي القيم الخام التي يعالجها البرنامج، مثل رقم أو نص أو تاريخ أو قيمة منطقية. وهي مادة أولية لا تحمل تنظيما ولا علاقات في حد ذاتها. أما الهيكل فهو الإطار الذي يحتضن هذه القيم ويحدد كيفية ترتيبها وطريقة التعامل معها. فالأسماء أحمد وسارة ويوسف بيانات، لكن وضعها في قائمة مرتبطة أو شجرة أو جدول تجزئة يحولها إلى هيكل له سلوك وأداء مختلفان. وفيما يلي مقارنة توضح الفروق الجوهرية:
| وجه المقارنة | البيانات (Data) | هياكل البيانات (Data Structures) |
| التعريف | قيم خام أو حقائق مجردة | أطر منظمة لتخزين القيم وإدارتها |
| الدور | مادة تعالج | وعاء ينظم المادة ويحدد عملياتها |
| العلاقات | لا توجد علاقات بين القيم | علاقات محددة مثل التتابع أو التفرع |
| العمليات | لا تملك عمليات خاصة | إضافة وحذف وبحث وترتيب |
| الأثر على الأداء | محدود | مباشر على السرعة والذاكرة |
| أمثلة | 25، “سارة”، True | مصفوفة، مكدس، شجرة، رسم بياني |
أمثلة واقعية على هياكل البيانات في الحياة اليومية
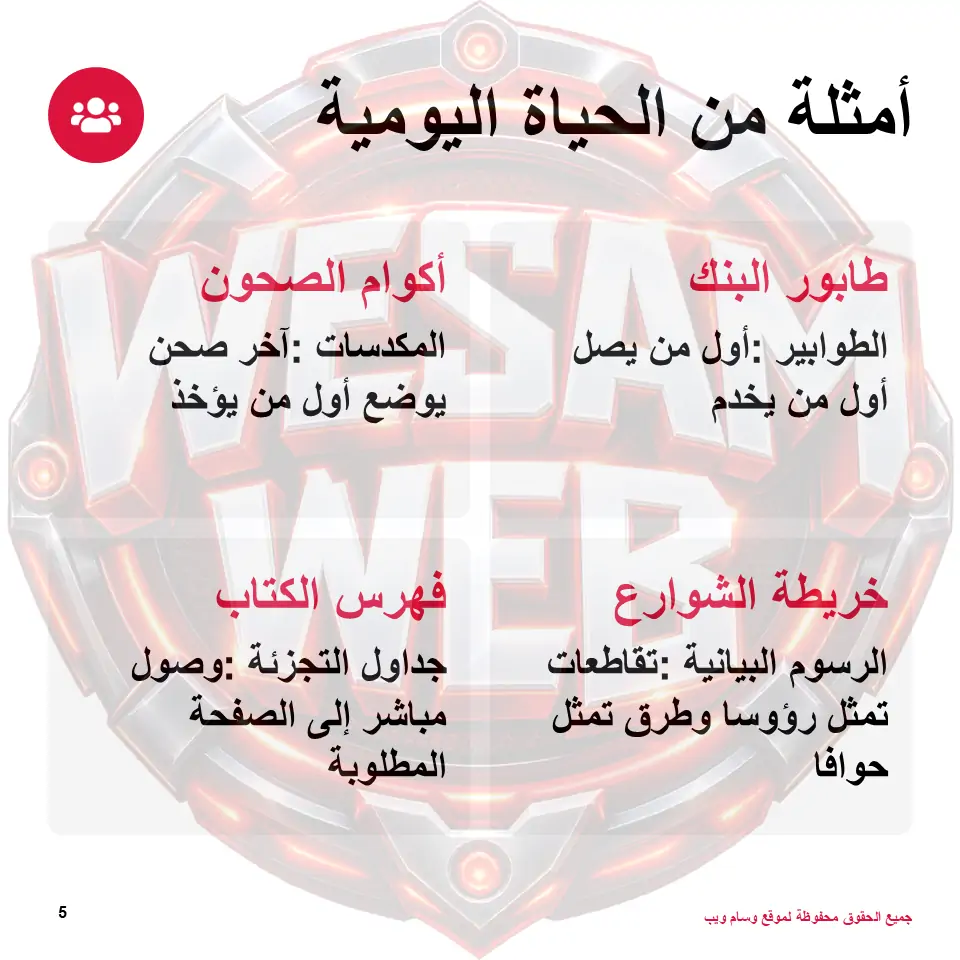
تظهر هياكل البيانات في حياتنا اليومية أكثر مما نتصور، وهي أسهل فهما حين نربطها بمواقف مألوفة. فكل نظام تنظيمي نصادفه في المجتمع يقوم على مبدأ يشبه أحد هذه الهياكل. وقد استلهم علماء الحاسوب كثيرا من تصميماتها من ممارسات بشرية قديمة، لأن البشر واجهوا مشكلات التنظيم قبل الحواسيب بقرون طويلة. وهذا الربط يسهل الحفظ والفهم معا.
وتبرز ثلاثة أمثلة شائعة تعطي تصورا سريعا عن الأنواع الأساسية:
- صف الانتظار في البنك (الطوابير): يخدم العميل الذي وصل أولا قبل غيره، وهذا هو مبدأ FIFO أي أول من يدخل أول من يخرج.
- أكوام الصحون (المكدسات): تضع الصحن الجديد فوق الكومة وتأخذ الصحن العلوي أولا، وهذا هو مبدأ LIFO أي آخر من يدخل أول من يخرج.
- خريطة الشوارع والملاحة (الرسوم البيانية): تمثل التقاطعات كرؤوس والطرق كحواف، وتبحث عن أقصر مسار بين نقطتين.
وتتكرر أمثلة أخرى كثيرة حولنا. فشجرة العائلة تمثل هيكلا شجريا، وفهرس الكتاب يشبه جدول تجزئة يقودك مباشرة إلى الصفحة. وكذلك قائمة التشغيل في تطبيق الموسيقى تشبه قائمة مرتبطة تنتقل من أغنية إلى التي تليها. وكلما تأملت مواقفك اليومية، اكتشفت هيكلا مألوفا يختبئ خلفها.لا مألوفا يختبئ خلفها.
تاريخ هياكل البيانات
| الحقبة الزمنية | الهيكل الأساسي | أبرز المساهمين | التطور والأهمية |
|---|---|---|---|
| الخمسينيات | المصفوفات والقوائم المرتبطة | آلان تورنغ وجون فون نيومان | تأسيس التخزين التسلسلي والديناميكي في الذاكرة |
| الستينيات | الأشجار والرسوم البيانية | إدسخر ديكسترا | تمثيل العلاقات المعقدة وحل مسائل المسارات |
| السبعينيات | جداول التجزئة | هانز بيتر لون | تسريع عمليات البحث والإدراج بشكل كبير |
| الثمانينيات | أكوام الأولوية والأشجار الثنائية | جون ويليامز | تحسين خوارزميات الجدولة والفرز السريع |
| التسعينيات | أشجار بي وأشجار الأحمر والأسود | رودولف باير | دعم قواعد البيانات وأنظمة الملفات المتوازنة |
| العقد الأول من الألفية | الهياكل المتزامنة والموزعة | باحثو الحوسبة الموزعة | تمكين تطبيقات الويب واسعة النطاق |
| العقد الثاني من الألفية | هياكل قواعد بيانات NoSQL | مجتمع المصادر المفتوحة | معالجة البيانات الضخمة وغير المهيكلة |
| حتى الأن | المصفوفات المتجهية وهياكل التنسور | باحثو الذكاء الاصطناعي | تسريع نماذج الذكاء الاصطناعي التوليدي والتعلم العميق |
كيف تعمل هياكل البيانات؟
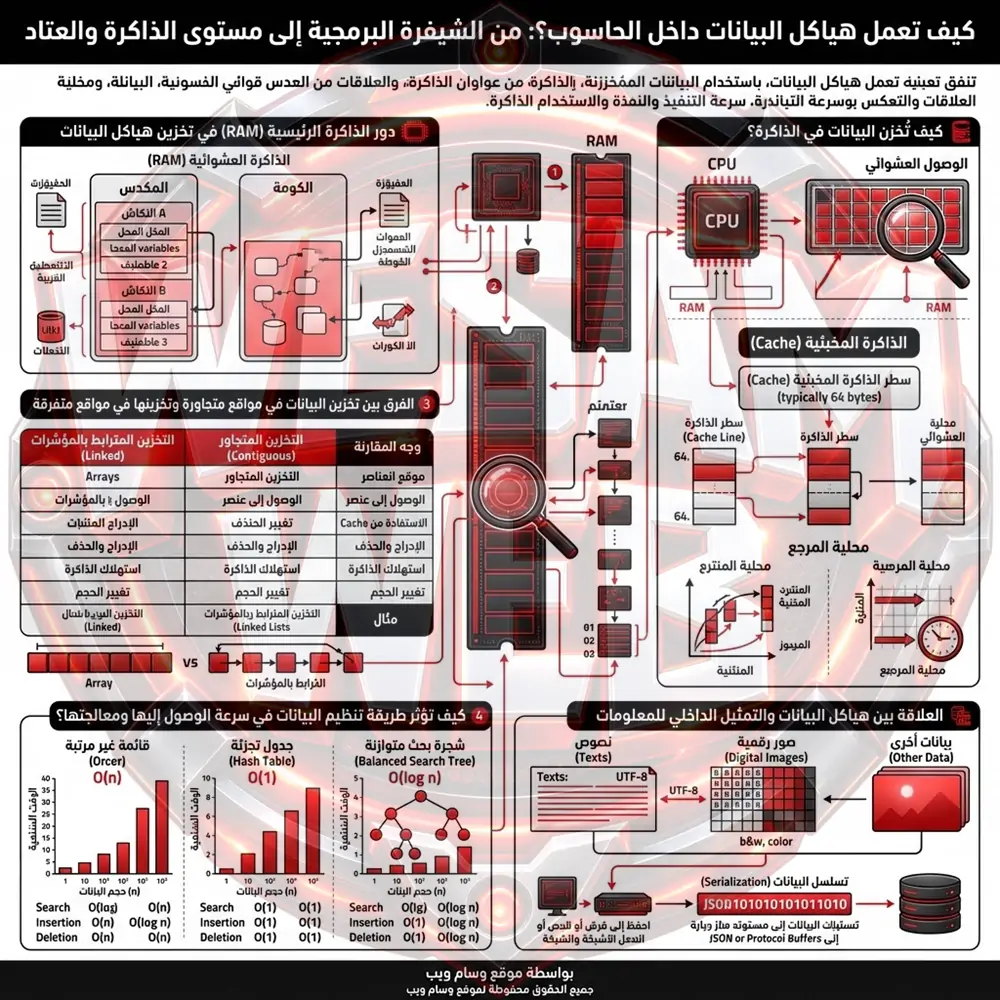
لفهم آلية عمل داتا ستراكشر (Data Structures)، يجب أن ننزل من مستوى الشيفرة إلى مستوى الذاكرة التي تعيش فيها هذه الهياكل فعليا. فالحاسوب لا يرى قوائم ولا أشجارا ولا رسوما بيانية، بل يرى شريطا طويلا من الخلايا الرقمية لكل منها عنوان فريد. وكل هيكل نكتبه في البرنامج هو في الحقيقة طريقة محددة لتوزيع القيم على هذه العناوين، مع قواعد تضبط الانتقال من خلية إلى أخرى. ولذلك فإن الفروق بين الهياكل ليست نظرية فقط، بل تنعكس على سرعة التنفيذ وحجم الذاكرة المستهلكة وسلوك المعالج.
وتمر أي عملية على هيكل البيانات بسلسلة من الخطوات الداخلية لا يراها المبرمج عادة. يطلب البرنامج مساحة من نظام التشغيل، ثم يحجز النظام كتلة من الذاكرة، ثم تكتب القيم في العناوين المحجوزة، وبعدها تحفظ المؤشرات أو الفهارس التي تدل على مواقع العناصر. وعند القراءة، يحسب المعالج العنوان المطلوب ويجلب القيمة من الذاكرة إلى المسجلات. وكلما قلت الخطوات الوسيطة، زادت السرعة. وهذا ما يفسر تفوق هيكل على آخر في عملية بعينها.
وتدخل في هذه الصورة عوامل عتادية مهمة أيضا، مثل الذاكرة المخبئية (Cache) وعرض نطاق الذاكرة وترتيب البايتات. فالمعالج الحديث لا يجلب القيمة الواحدة وحدها، بل يجلب كتلة كاملة من البيانات المجاورة دفعة واحدة. لذلك قد يتفوق هيكل أبسط نظريا على هيكل أذكى نظريا حين يتوافق تخطيطه مع طريقة عمل العتاد. وسنتتبع هذه الفكرة عبر المحاور التالية خطوة بخطوة.
كيف تُخزن البيانات في الذاكرة؟
تنقسم ذاكرة البرنامج عند التشغيل إلى مناطق رئيسية لكل منها وظيفة مختلفة. هناك منطقة المكدس (Stack) التي تحتفظ بالمتغيرات المحلية وسجلات استدعاء الدوال، وتتميز بسرعتها وتنظيمها الصارم. وهناك منطقة الكومة (Heap) التي تخصص منها الذاكرة الديناميكية أثناء التنفيذ، وهي أكبر وأكثر مرونة لكنها أبطأ وتحتاج إلى إدارة أدق. وتوجد كذلك منطقة البيانات الثابتة ومنطقة الشيفرة. ويعتمد مكان تخزين الهيكل على نوعه وعلى اللغة المستخدمة وعلى طريقة إنشائه.
ويتم التخزين عبر حجز عناوين متتابعة أو متفرقة بحسب تصميم الهيكل. فعند إنشاء مصفوفة من عشرة أعداد صحيحة، يحجز النظام كتلة واحدة متصلة تتسع لها جميعا، ويحسب عنوان أي عنصر بمعادلة بسيطة هي عنوان البداية مضافا إليه رقم العنصر مضروبا في حجمه. أما عند إنشاء قائمة مرتبطة، فيحجز النظام كل عقدة على حدة في موقع قد يكون بعيدا عن جارتها، وتحمل كل عقدة مؤشرا يدل على العقدة التالية. ولهذا تختلف تكلفة الوصول اختلافا جذريا بين النوعين.
وتضيف لغات البرمجة طبقة إضافية من التجريد فوق هذا المشهد. ففي لغة C يتحكم المبرمج في الحجز والتحرير يدويا، ويتحمل مسؤولية الأخطاء الناتجة عن التسريب أو الوصول الخاطئ. أما في لغات مثل Python وJava، فيتولى جامع النفايات (Garbage Collector) عملية تحرير الذاكرة تلقائيا. وتخزن هذه اللغات غالبا مراجع (References) إلى الكائنات بدلا من القيم مباشرة، فقائمة بايثون مثلا هي مصفوفة من المراجع تشير إلى كائنات موزعة في الذاكرة. وهذه التفاصيل تؤثر مباشرة في الأداء وفي استهلاك الموارد.
دور الذاكرة الرئيسية (RAM) في تخزين هياكل البيانات
تعد الذاكرة الرئيسية (RAM) البيئة الأساسية التي تعيش فيها هياكل البيانات أثناء تشغيل البرنامج. وهي ذاكرة مؤقتة تفقد محتواها عند انقطاع الكهرباء، لكنها أسرع بكثير من وسائط التخزين الدائمة مثل الأقراص. ولذلك يحمل النظام البيانات التي يحتاجها البرنامج إلى RAM ليتمكن المعالج من الوصول إليها خلال نانوثوان معدودة. وتتميز RAM بخاصية الوصول العشوائي (Random Access)، أي أن زمن الوصول إلى أي عنوان يكاد يكون واحدا مهما كان موقعه.
وتحدد سعة RAM حجم الهياكل التي يمكن للبرنامج أن يبنيها دفعة واحدة. فإذا تجاوز الهيكل السعة المتاحة، يلجأ نظام التشغيل إلى التبديل (Swapping) أو الذاكرة الافتراضية، فتنقل أجزاء من البيانات إلى القرص، وتنخفض السرعة انخفاضا حادا. وهذه من أكثر المشكلات التي تواجه التطبيقات التي تتعامل مع بيانات ضخمة. ولذلك يهتم المطور المحترف بحجم الهيكل وليس بسرعته فقط، ويختار تمثيلات مدمجة عندما تكون الذاكرة محدودة.
وتحتفظ RAM كذلك بعلاقة وثيقة مع الذاكرة المخبئية (Cache) الموجودة داخل المعالج. فعند قراءة عنصر، ينقل العتاد كتلة مجاورة له تسمى سطر الذاكرة المخبئية (Cache Line) وحجمها شائع هو 64 بايت في أغلب المعالجات الحديثة. فإذا كانت العناصر المطلوبة لاحقا داخل الكتلة نفسها، جاء الوصول إليها فوريا. وهذه الظاهرة تسمى محلية المرجع (Locality of Reference)، وهي سبب رئيسي في تفوق المصفوفات عمليا على كثير من الهياكل الأخرى.
مقالة ذات صلة: ما هي الرامات (RAM)؟ وكم تحتاج منها في هاتفك وحاسوبك؟ دليل شامل.
الفرق بين تخزين البيانات في مواقع متجاورة وتخزينها في مواقع متفرقة من الذاكرة
يعد اختيار طريقة التخزين من أهم القرارات التي تميز هيكلا عن آخر. ففي التخزين المتجاور (Contiguous Allocation) توضع العناصر في خلايا متتالية دون فواصل، مما يتيح الوصول المباشر عبر الفهرس ويستفيد استفادة كاملة من الذاكرة المخبئية فتزيد السرعة. وفي التخزين المتفرق (Linked Allocation) توزع العناصر في مواقع مختلفة، وتربط بينها المؤشرات، فيسهل الإدراج والحذف دون نقل باقي العناصر، لكن يظهر عائق التنقل المباشر لأن الوصول إلى العنصر الأخير يتطلب المرور على كل ما قبله. وتوضح المقارنة التالية هذه الفروق بالتفصيل:
| وجه المقارنة | التخزين المتجاور (Contiguous) | التخزين المتفرق (Linked) |
| موقع العناصر | خلايا متتالية في كتلة واحدة | مواقع متفرقة مرتبطة بمؤشرات |
| الوصول إلى عنصر | مباشر عبر الفهرس بزمن $O(1)$ | تسلسلي بزمن $O(n)$ في الغالب |
| الاستفادة من Cache | عالية جدا بسبب التجاور | منخفضة بسبب التشتت |
| الإدراج والحذف | مكلف لأنه يتطلب إزاحة العناصر | سريع عند معرفة الموقع |
| استهلاك الذاكرة | أقل لعدم وجود مؤشرات | أكبر بسبب تخزين المؤشرات |
| تغيير الحجم | صعب وقد يتطلب نسخا كاملا | مرن وسهل التوسع |
| مثال | المصفوفات | القوائم المرتبطة |
كيف تؤثر طريقة تنظيم البيانات في سرعة الوصول إليها ومعالجتها؟
تحدد طريقة التنظيم عدد الخطوات التي يحتاجها الحاسوب للوصول إلى عنصر معين. فعند البحث عن اسم داخل قائمة غير مرتبة من مليون اسم، قد يحتاج النظام إلى فحص مليون عنصر في أسوأ الحالات. أما إذا نظمت الأسماء في جدول تجزئة، فقد يصل إلى الاسم بخطوة واحدة تقريبا. وإذا رتبت في شجرة بحث متوازنة، فسيحتاج إلى نحو عشرين خطوة فقط. وهذا التفاوت الهائل يوضح أن التنظيم ليس ترفا، بل عامل حاسم في الأداء.
ولا تقتصر التأثيرات على البحث وحده، فهي تمتد إلى كل العمليات. فالإدراج في بداية المصفوفة يتطلب إزاحة كل العناصر، بينما يتم بخطوة واحدة في القائمة المرتبطة. والترتيب على مصفوفة يستفيد من الوصول المباشر، في حين يصعب ترتيب قائمة مرتبطة بكفاءة. كما أن استخراج الحد الأدنى يكون فوريا في الكومة الصغرى. ولذلك يجب أن يسأل المبرمج نفسه دائما أي العمليات ستتكرر أكثر في برنامجه.
وتزداد أهمية هذه الأسئلة مع نمو البيانات. فالفرق بين $O(n)$ و$O(\log n)$ لا يلاحظ عند مئة عنصر، لكنه يصبح جوهريا عند مئة مليون عنصر. وقد يعني الفرق بين استجابة فورية وانتظار يمتد إلى دقائق. كما أن الأنظمة الحديثة تخدم آلاف الطلبات في الثانية، فيتضاعف أثر كل خطوة زائدة. ولهذا تقاس جودة التصميم البرمجي بقدرته على الحفاظ على الأداء مع تضخم الحجم.
العلاقة بين هياكل البيانات والتمثيل الداخلي للمعلومات
يقصد بالتمثيل الداخلي الكيفية التي تترجم بها المعلومات من صورتها المفهومة للإنسان إلى صورة ثنائية يعالجها الحاسوب. فالنص يتحول إلى رموز مرقمة وفق ترميز مثل UTF-8، والصورة تتحول إلى شبكة من قيم الألوان، والصوت يتحول إلى سلسلة من العينات. وتأتي هياكل البيانات لتنظم هذه القيم الثنائية في بنى تحفظ المعنى والعلاقات. فالصورة مثلا مصفوفة ثنائية الأبعاد من البكسلات، والنص سلسلة من الرموز.
وتتأثر دقة التمثيل وكفاءته بنوع الهيكل المستخدم. فالعدد الصحيح قد يخزن في أربعة بايتات أو ثمانية بحسب النوع، والمؤشر يحجز حجما ثابتا يعتمد على معمارية النظام سواء كانت 32 بت أو 64 بت. وعندما تتراكم ملايين الكائنات، تتضاعف التكاليف الخفية مثل الترويسات (Headers) والمحاذاة (Alignment) والمؤشرات الإضافية. لذلك يختار المهندسون أحيانا تمثيلات مضغوطة مثل المصفوفات الأحادية أو مصفوفات البت (Bit Arrays) لتوفير الذاكرة.
ويظهر الترابط بين التمثيل الداخلي والهيكل بوضوح في مفهوم التسلسل (Serialization). فعند حفظ هيكل على القرص أو إرساله عبر الشبكة، يجب تحويله إلى تسلسل بايتات يمكن إعادة بنائه منه لاحقا. وتستخدم الصيغ مثل JSON وProtocol Buffers لهذا الغرض. وتبرز هنا حقيقة مهمة، وهي أن الهيكل ليس مجرد فكرة في الذهن، بل كيان له صورة مادية يمكن قياسها ونقلها وتحسينها.
ما أنواع هياكل البيانات؟
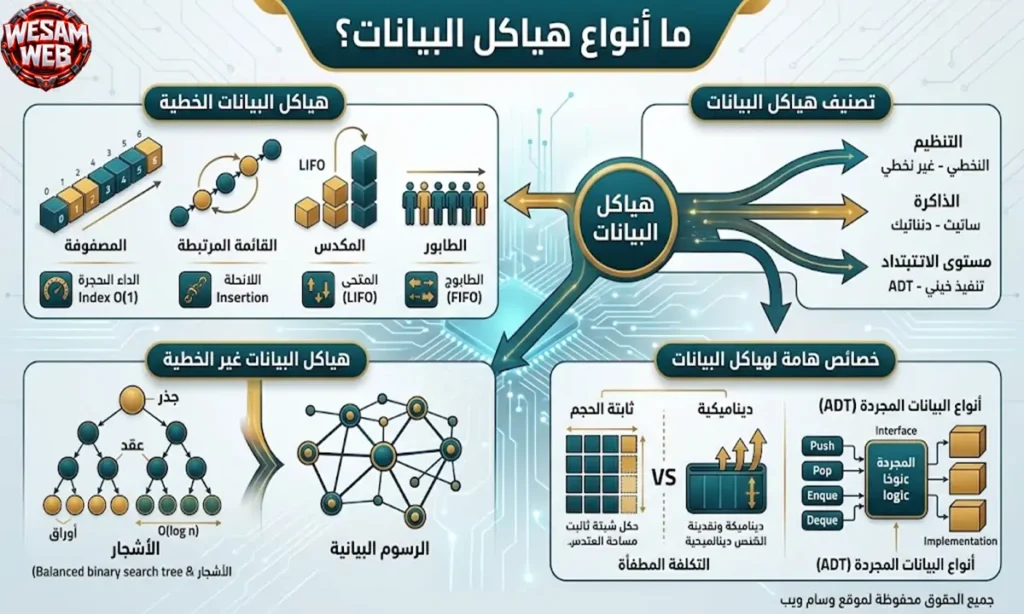
تتعدد أنواع هياكل البيانات بتعدد المشكلات التي صممت لحلها، ولا يوجد هيكل يتفوق في جميع الجوانب. فالمصفوفة تتيح الوصول السريع إلى العناصر بواسطة الفهرس، لكنها قد تكون محدودة الحجم إذا استخدمت مصفوفة ثابتة. أما القائمة المرتبطة فتتيح مرونة في الإضافة والحذف عند معرفة موضع العنصر، لكنها أبطأ في الوصول إلى عنصر محدد اعتمادا على موقعه. وتساعد الأشجار المتوازنة على تنفيذ عمليات البحث والإضافة والحذف بكفاءة، لكنها أكثر تعقيدا في التنفيذ. ولهذا يصنف علماء الحاسوب هياكل البيانات وفق معايير متعددة تساعد على فهم خصائصها والمفاضلة بينها.
تصنيف هياكل البيانات حسب طريقة تنظيمها
يعتمد أحد التصنيفات الشائعة على طبيعة العلاقات بين العناصر. فإذا نظمت العناصر في تسلسل واحد، كان الهيكل خطيا، مثل المصفوفات والقوائم المرتبطة والمكدسات والطوابير. أما إذا اتخذت العلاقات بين العناصر أشكالا متفرعة أو شبكية، كان الهيكل غير خطي، مثل الأشجار والرسوم البيانية. وهناك تصنيف آخر يعتمد على إمكانية تغيير الحجم، فيميز بين الهياكل ثابتة الحجم والهياكل الديناميكية. كما يميز تصنيف ثالث بين أنواع البيانات المجردة (Abstract Data Types – ADT)، التي تحدد السلوك والعمليات، والتنفيذات الفعلية التي تحدد كيفية تنظيم البيانات وإجراء تلك العمليات.
وتتداخل هذه التصنيفات ولا تتعارض، فقد ينتمي الهيكل الواحد إلى أكثر من تصنيف في الوقت نفسه. فالمصفوفة هيكل خطي، وقد تكون ثابتة الحجم أو جزءا من تنفيذ مصفوفة ديناميكية بحسب اللغة وآلية التنفيذ. ويمكن أيضا استخدام المصفوفة لتنفيذ مكدس، وهو نوع بيانات مجرد يحدد طريقة التعامل مع العناصر. أما القائمة المرتبطة فهي هيكل خطي ديناميكي في تنفيذها المعتاد. وتساعد هذه النظرة المتعددة على فهم موقع كل هيكل ضمن الخريطة العامة لهياكل البيانات. وفيما يلي أبرز التصنيفات:
- حسب العلاقة بين العناصر: هياكل خطية مثل المصفوفات والقوائم المرتبطة والمكدسات والطوابير، وهياكل غير خطية مثل الأشجار والرسوم البيانية.
- حسب مرونة الحجم: هياكل ثابتة الحجم لا يتغير حجمها بعد إنشائها، وهياكل ديناميكية يمكن أن يتغير حجمها أثناء التشغيل.
- حسب مستوى التجريد: أنواع بيانات مجردة تصف العمليات والسلوك المتوقع، وتنفيذات فعلية تحدد طريقة تنظيم البيانات وتنفيذ العمليات.
- حسب الغرض الأساسي: هياكل تلائم البحث، وأخرى لإدارة الأولويات، وأخرى لتمثيل العلاقات أو تسهيل الوصول إلى البيانات، وقد يخدم الهيكل الواحد أكثر من غرض.
هياكل البيانات الخطية (Linear Data Structures)
تنظم الهياكل الخطية العناصر في تسلسل واحد، بحيث يمكن تحديد ترتيب العناصر بالنسبة إلى بعضها بعضا. ويمكن المرور عليها وفق هذا التسلسل، وإن اختلفت طريقة الوصول إلى العناصر والعمليات المسموح بها من هيكل إلى آخر. وتشمل المصفوفات والقوائم المرتبطة والمكدسات والطوابير. وتتميز ببساطة الفكرة وسهولة فهمها واستخدامها، ولذلك تعد نقطة بداية مناسبة للمتعلمين. كما يمكن استخدام المصفوفات والقوائم المرتبطة في تنفيذ هياكل أخرى، مثل المكدسات والطوابير، بحسب متطلبات التطبيق.
وتختلف الهياكل الخطية فيما بينها في طريقة الوصول إلى العناصر والقيود المفروضة على العمليات. فالمصفوفة تتيح الوصول المباشر إلى عنصر بواسطة فهرسه، بينما تتطلب القائمة المرتبطة عادة المرور عبر العقد للوصول إلى عنصر معين انطلاقا من بداية القائمة. أما المكدس فيتيح الإضافة والإزالة من طرف واحد وفق مبدأ آخر من يدخل أولا يخرج أخيرا، في حين يتيح الطابور الإضافة من أحد الطرفين والإزالة من الطرف الآخر وفق مبدأ أول من يدخل أولا يخرج. وهذه القيود ليست عيبا بالضرورة، بل تجعل كل هيكل مناسبا لنمط استخدام محدد يتكرر في البرمجيات، مثل التراجع عن العمليات وجدولة المهام.
ومن الناحية العملية، تغطي الهياكل الخطية نسبة كبيرة من احتياجات المبرمج اليومية. فقوائم المهام، وسجلات الأحداث، وقوائم الطلبات، وطوابير الرسائل، كلها أمثلة على استخداماتها. لكن الاعتماد على الهياكل الخطية وحدها قد لا يكون مناسبا عندما تتعدد العلاقات بين البيانات أو تتفرع، كما في الشبكات الاجتماعية والخرائط. عندها تظهر أهمية الهياكل غير الخطية، التي تتيح تمثيل هذه العلاقات بصورة أكثر ملاءمة.
هياكل البيانات غير الخطية (Non-linear Data Structures)
لا تقتصر الهياكل غير الخطية على تنظيم العناصر في تسلسل واحد، بل تمثل علاقات متفرعة أو شبكية تسمح للعنصر بالارتباط بعدة عناصر أخرى. ومن أشهرها الأشجار (Trees)، التي تنظم البيانات في مستويات هرمية من الجذر إلى العقد الأبناء والأوراق، والرسوم البيانية (Graphs)، التي تمثل الكيانات والعلاقات بينها بصورة أكثر مرونة. وتمتاز هذه الهياكل بقدرتها على تمثيل العلاقات المعقدة؛ فشجرة الملفات، وشبكة الطرق، وعلاقات الصداقة في الشبكات الاجتماعية، كلها أمثلة يمكن تمثيلها باستخدام هياكل غير خطية.
وقد توفر الهياكل غير الخطية أداء أفضل في مهام معينة عندما تختار وتنفذ بصورة مناسبة. فشجرة البحث الثنائية المتوازنة تستطيع البحث بين مليون عنصر في نحو عشرين مستوى من المقارنات، لأن ارتفاعها ينمو لوغاريتميا مع عدد العناصر. في المقابل، قد يحتاج البحث الخطي في مليون عنصر إلى فحص ما يصل إلى مليون عنصر في أسوأ الحالات. وتتيح الكومة (Heap) الوصول إلى العنصر ذي الأولوية الأعلى أو الأدنى بسرعة، بحسب نوع الكومة، كما تسمح بإزالته بكفاءة. وتستخدم الرسوم البيانية في مسائل التوجيه والتوصية وتحليل العلاقات واكتشاف المجتمعات. ومع ذلك، قد تتطلب هذه الهياكل تنفيذا أكثر تعقيدا وذاكرة إضافية، كما تحتاج بعض أنواع الأشجار إلى آليات للمحافظة على التوازن حتى تظل عملياتها فعالة.
ويتطلب التعامل مع هذه الهياكل أسلوب تفكير يختلف عن المرور البسيط على تسلسل خطي، لأن العلاقات المتفرعة أو الشبكية تحتاج إلى طرق مناسبة لاجتياز العناصر. فتُجتاز الأشجار بأنماط متعددة، مثل الاجتياز السابق والوسطي واللاحق واجتياز المستويات، بينما تُستخدم في الرسوم البيانية خوارزميات مثل البحث بالعمق (Depth-First Search – DFS) والبحث بالعرض (Breadth-First Search – BFS). كما ينبغي الانتباه إلى خصائص مثل الدورات (Cycles) في الرسوم البيانية، وإمكانية وجود عقد غير متصلة ببقية أجزاء الرسم البياني. وعلى الرغم من أن فهم هذه الهياكل يحتاج إلى ممارسة، فإن إتقانها يساعد المبرمج على معالجة مشكلات أكثر تعقيدا واختيار الحلول المناسبة لها.
هياكل البيانات الثابتة والديناميكية
تحدد الهياكل ثابتة الحجم (Static Data Structures) بحجم معروف عند إنشائها، ولا يمكن تغيير حجمها مباشرة بعد ذلك دون إنشاء مساحة أخرى أو استخدام آلية مختلفة. ومن أبرز أمثلتها المصفوفات ذات الحجم الثابت في لغات مثل C. وتتميز بإمكانية معرفة حجمها مسبقا، ما يساعد على التخطيط لاستهلاك الذاكرة، كما تتيح المصفوفات الوصول المباشر إلى العناصر باستخدام الفهرس. لكنها قد تهدر المساحة إذا كان الحجم المحجوز أكبر من الحاجة، أو لا تكفي لاستيعاب البيانات إذا كان الحجم أصغر من المطلوب. ولذلك تكون مناسبة عندما يكون عدد العناصر معروفا أو محدودا مسبقا.
أما الهياكل الديناميكية (Dynamic Data Structures)، فيمكن أن يتغير حجمها أثناء التشغيل وفقا للحاجة. ومن أمثلتها القوائم المرتبطة والأشجار والرسوم البيانية، وكذلك المصفوفات الديناميكية مثل list في Python وArrayList في Java. وتعمل المصفوفات الديناميكية عادة باستخدام مساحة متجاورة تتسع لعدد من العناصر، وعندما تنفد السعة المتاحة، قد تخصص مساحة أكبر وتنقل إليها العناصر الموجودة. وتُزاد السعة وفق سياسة يحددها التنفيذ، وقد تكون الزيادة مضاعفة أو وفق آلية أخرى. ونتيجة لذلك، يمكن أن تكون تكلفة الإضافة في نهاية المصفوفة الديناميكية ثابتة في المتوسط على سلسلة من العمليات، رغم أن بعض عمليات الإضافة الفردية قد تتطلب نقل العناصر وتكون تكلفتها خطية. ويُعرف تحليل التكلفة عبر سلسلة العمليات باسم التكلفة المطفأة (Amortized Cost).
ويحتاج الاختيار بين النوعين إلى موازنة دقيقة. فالهياكل الديناميكية تمنح مرونة أكبر، لكنها قد تتطلب عمليات إضافية لإدارة الذاكرة، وقد تتأثر طريقة تخصيص الذاكرة بتجزئتها (Fragmentation) وبآلية التنفيذ. أما الهياكل ثابتة الحجم فتتيح معرفة احتياجاتها من المساحة مسبقا، لكنها أقل مرونة عند تغير حجم البيانات. وفي الأنظمة المدمجة والأنظمة الفورية، قد يُفضّل استخدام هياكل ذات حجم ثابت أو ذاكرة محددة مسبقا لتسهيل التنبؤ باستهلاك الموارد وزمن التنفيذ. بينما تستخدم تطبيقات الويب كثيرا من الهياكل الديناميكية لأن حجم البيانات المطلوب معالجتها قد يتغير أثناء التشغيل.
هياكل البيانات المجردة (Abstract Data Types – ADT)
النوع المجرد للبيانات (ADT) هو وصف يحدد مجموعة القيم والعمليات المتاحة عليها والسلوك المتوقع من هذه العمليات، دون فرض طريقة محددة لتمثيل البيانات أو تنفيذ العمليات داخليا. ومن أشهر الأمثلة المكدس (Stack) والطابور (Queue) والقائمة (List) والقاموس (Map) والمجموعة (Set). فعندما نعرّف المكدس بوصفه نوعا مجردا، فإننا نحدد العمليات التي يمكن إجراؤها عليه، مثل إضافة عنصر إلى القمة وإزالة العنصر الموجود في القمة، دون اشتراط استخدام مصفوفة أو قائمة مرتبطة في التنفيذ. وتكمن قيمة هذا المفهوم في أنه يتيح التفكير في المشكلة من حيث السلوك المطلوب، قبل الانشغال بتفاصيل التنفيذ.
ويرتبط التجريد بمبدأ إخفاء تفاصيل التنفيذ (Information Hiding)، إذ يتعامل مستخدم الهيكل مع العمليات التي توفرها واجهته دون الحاجة إلى معرفة جميع التفاصيل الداخلية. ويسمح ذلك بتغيير التنفيذ مع الحفاظ على السلوك المتفق عليه، ما دامت الواجهة والعقود التي تعتمد عليها الشيفرة لم تتغير. فإذا نُفذ طابور باستخدام مصفوفة، ثم ظهرت حاجة إلى تنفيذ آخر يلائم متطلبات التطبيق بصورة أفضل، فيمكن استبدال طريقة التنفيذ مع المحافظة على العمليات المتاحة والسلوك المتوقع. ويساعد هذا الفصل على جعل الشيفرة أسهل في الصيانة والتطوير وإعادة الاستخدام.
وتدعم لغات البرمجة هذا الفصل بين الواجهة والتنفيذ بطرائق مختلفة، من بينها الواجهات (Interfaces) والفئات المجردة (Abstract Classes). ففي Java، تمثل List واجهة تحدد العمليات العامة للقوائم، وتوفر ArrayList وLinkedList تنفيذين مختلفين لها، لكل منهما خصائصه من حيث الوصول إلى العناصر والإضافة والحذف واستهلاك الذاكرة. وفي Python، توفر الأنواع المدمجة مثل list وdict واجهات عمليات واضحة يمكن التعامل معها دون الحاجة إلى معرفة جميع تفاصيل تنفيذها الداخلي. ويساعد فهم العلاقة بين التجريد والتنفيذ على قراءة المكتبات القياسية واختيار الهياكل المناسبة واستخدامها بوعي.
الفرق بين هيكل البيانات المجرد وتنفيذه الفعلي
الفرق الجوهري هو أن ADT يجيب عن سؤال ماذا، بينما يجيب التنفيذ الفعلي عن سؤال كيف. فـالمكدس كنوع مجرد يعد بعمليات Push وPop وفق مبدأ LIFO، ولا يقول شيئا عن مكان التخزين. أما التنفيذ فيقرر هل المكدس يعيش في مصفوفة أم قائمة مرتبطة، وكيف تتم إدارة السعة، وما تكلفة كل عملية. وقد يكون للنوع المجرد الواحد عدة تنفيذات تختلف في الأداء مع الالتزام بالسلوك نفسه. وتلخص المقارنة التالية هذه الفروق:
| وجه المقارنة | النوع المجرد (ADT) | التنفيذ الفعلي (Implementation) |
|---|---|---|
| السؤال الذي يجيب عنه | ماذا يفعل الهيكل؟ | كيف يفعل الهيكل ذلك؟ |
| المستوى | نظري ومنطقي | عملي وفيزيائي |
| المحتوى | العمليات وسلوكها | التخزين والخوارزميات الداخلية |
| الأداء | غير محدد | محدد بتعقيد زمني ومكاني |
| التعدد | تعريف واحد | عدة تنفيذات ممكنة للتعريف نفسه |
| مثال | Stack وQueue وMap | ArrayStack وLinkedQueue وHashMap |
المصفوفات (Arrays) في هياكل البيانات
تعد المصفوفات أقدم هياكل البيانات وأكثرها حضورا في البرمجة، فهي اللبنة الأولى التي يتعلمها كل مبرمج قبل أن ينتقل إلى الهياكل الأعقد. وتقوم فكرتها على حجز كتلة متصلة من الذاكرة وتقسيمها إلى خانات متساوية الحجم، يحمل كل منها رقما يسمى الفهرس (Index). وبفضل هذا التنظيم البسيط، يصل المعالج إلى أي عنصر بخطوة واحدة تقريبا، دون بحث أو مرور على ما قبله. ولذلك تقف المصفوفات خلف كثير من الهياكل الأخرى، فـالمكدسات والطوابير والكومات وجداول التجزئة تبنى في الغالب فوقها.
ما هي المصفوفات (Arrays)؟
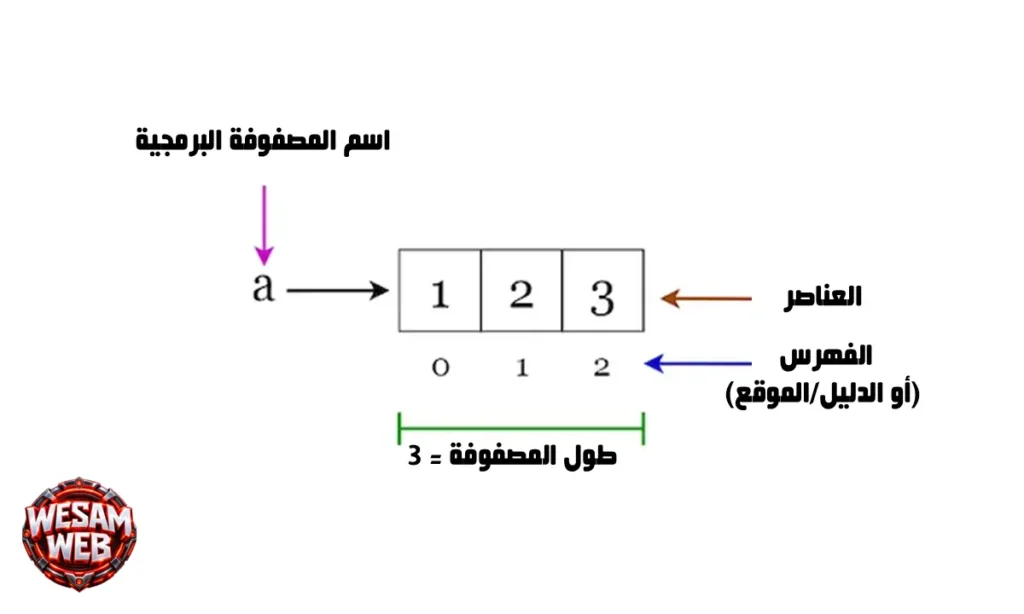
المصفوفة (Array) هي هيكل بيانات خطي يخزن مجموعة من العناصر من النوع نفسه في مواقع متجاورة من الذاكرة. ويتميز كل عنصر فيها برقم موقعه الذي يبدأ في أغلب لغات البرمجة من الصفر. فإذا كانت لديك مصفوفة تضم الأعداد 10 و20 و30، فإن العنصر الأول يقع عند الفهرس 0، والثاني عند الفهرس 1، وهكذا. وتسمح هذه البنية بالوصول المباشر (Direct Access) إلى أي عنصر عبر فهرسه فقط، وهي الميزة الأهم التي تفرد المصفوفة عن القوائم المرتبطة وغيرها.
ويعود سر السرعة في المصفوفات إلى معادلة حسابية بسيطة يستخدمها الحاسوب لتحديد عنوان أي عنصر. فالعنوان يساوي عنوان بداية المصفوفة مضافا إليه حاصل ضرب الفهرس في حجم العنصر الواحد. وتنفذ هذه العملية في زمن ثابت لا يتأثر بحجم المصفوفة، سواء كانت تضم عشرة عناصر أو عشرة ملايين. ولهذا يقال إن الوصول إلى عنصر في المصفوفة له تعقيد زمني من الرتبة $O(1)$. وهذه الخاصية تجعلها الخيار الأول عندما يكون الوصول بالفهرس هو العملية الأكثر تكرارا.
وتظهر المصفوفات في لغات البرمجة بصور مختلفة وبأسماء متعددة. ففي لغة C و Java تكون المصفوفة ثابتة الحجم ومتجانسة النوع، أي أن حجمها يحدد عند الإنشاء وكل عناصرها من نوع واحد. أما في Python فتأتي المصفوفات على شكل قوائم (Lists) ديناميكية تقبل أنواعا مختلفة، وفي JavaScript تسمى Array وتتوسع تلقائيا. وهذه الفروق تخص التنفيذ فقط، أما الفكرة الأساسية القائمة على الفهرسة والتخزين المتجاور فتبقى ثابتة في جميع لغات البرمجة.
كيف تُخزن المصفوفات في الذاكرة؟
عند إنشاء مصفوفة، يطلب البرنامج من نظام التشغيل كتلة متصلة من الذاكرة تكفي لجميع عناصرها. فإذا أنشأت مصفوفة من خمسة أعداد صحيحة وكان حجم العدد الواحد أربعة بايتات، فسيحجز النظام عشرين بايتا متتالية. ثم توضع العناصر واحدا بعد الآخر دون فواصل، فيبدأ الأول عند العنوان الأساسي، ويأتي الثاني بعده بأربعة بايتات، وهكذا حتى النهاية. وهذا التجاور هو الأساس المادي الذي تقوم عليه سرعة الوصول وكفاءة الذاكرة المخبئية (Cache).
وينعكس هذا التخزين المتجاور على الأداء بصورة مباشرة وقابلة للقياس. فعندما يقرأ المعالج عنصرا من المصفوفة، يجلب معه سطرا كاملا يسمى سطر الذاكرة المخبئية (Cache Line) يضم العناصر المجاورة. وعند القراءة التالية، تكون القيمة جاهزة في المخبأ فيتم الوصول إليها فورا. وتسمى هذه الظاهرة محلية المرجع المكانية (Spatial Locality)، وهي السبب الذي يجعل المرور على مصفوفة أسرع بـأضعاف من المرور على قائمة مرتبطة تحوي العدد نفسه من العناصر. ولكن للتجاور ثمنا، فإذا امتلأت المصفوفة وتعذر توسيعها في مكانها، وجب نسخها كلها إلى كتلة أكبر.
وتلخص النقاط التالية أهم خصائص تخزين المصفوفات في الذاكرة:
- حجز كتلة متصلة من الذاكرة عند الإنشاء بحجم العدد الكلي للعناصر.
- تساوي حجم الخانات لأن العناصر من نوع واحد في المصفوفات التقليدية.
- حساب العنوان مباشرة عبر عنوان البداية والفهرس وحجم العنصر.
- استفادة عالية من الذاكرة المخبئية بفضل التجاور المكاني.
- صعوبة التوسع لأن الكتلة قد لا تجد مساحة حرة بعدها.
أنواع المصفوفات: أحادية البعد ومتعددة الأبعاد
المصفوفة أحادية البعد (One-dimensional Array) هي أبسط الأنواع، وتشبه صفا واحدا من الخانات يمر عليه فهرس واحد. وتستخدم لتخزين قائمة بسيطة من القيم مثل درجات الطلاب أو أسعار المنتجات أو قراءات الحساسات. ويكفي في هذا النوع رقم واحد لتحديد أي عنصر، مما يجعل التعامل معه سهلا وسريعا. وتعد المصفوفة الأحادية الأساس الذي تقوم عليه الأنواع الأخرى، فـالنصوص في كثير من اللغات ليست سوى مصفوفات من الرموز.
أما المصفوفة متعددة الأبعاد (Multidimensional Array) فتنظم العناصر في أكثر من اتجاه، وأشهرها المصفوفة ثنائية الأبعاد (2D Array) التي تشبه جدولا من صفوف وأعمدة. ويحتاج الوصول إلى عنصر فيها إلى فهرسين، الأول للصف والثاني للعمود. وتستخدم هذه المصفوفات في تمثيل الصور حيث كل خانة تحمل لون بكسل، وفي الألعاب التي تعتمد لوحات مثل الشطرنج، وفي العمليات الرياضية على المصفوفات (Matrices). وقد تمتد الأبعاد إلى ثلاثة فأكثر، كما في تمثيل الفيديو أو البيانات الحجمية.
ورغم أن المصفوفة متعددة الأبعاد تبدو جدولا، فإن الذاكرة في الواقع خطية بطبيعتها. لذلك تحول اللغات الجدول إلى تسلسل واحد عبر طريقتين، هما الترتيب الصفي (Row-major Order) المعتمد في C وPython، و الترتيب العمودي (Column-major Order) المعتمد في Fortran وMATLAB. ولهذا الاختلاف أثر عملي كبير، فالمرور على الصفوف في لغة تخزنها صفا بصف أسرع من المرور على الأعمدة، لأن الأول يتوافق مع التجاور في الذاكرة. ومن يتجاهل هذه التفصيلة قد يخسر أداء ملحوظا في العمليات الضخمة.
العمليات الأساسية على المصفوفات
تدعم المصفوفات عددا من العمليات الأساسية التي تختلف تكلفتها باختلاف موضعها. فـعملية القراءة والتعديل بالفهرس تتم بزمن ثابت $O(1)$، لأن العنوان يحسب مباشرة. أما عملية البحث عن قيمة معينة في مصفوفة غير مرتبة، فتتطلب المرور على العناصر واحدا تلو الآخر في أسوأ الحالات، فتكون تكلفتها خطية $O(n)$. وإذا كانت المصفوفة مرتبة، أمكن استخدام البحث الثنائي (Binary Search) الذي ينجز المهمة بزمن لوغاريتمي $O(\log n)$، وهو فرق هائل عند البيانات الكبيرة.
وتبدو عمليتا الإدراج والحذف أكثر كلفة في المصفوفات، لأنهما تؤثران في تجاور العناصر. فعند إدراج عنصر في المنتصف، يجب إزاحة كل العناصر اللاحقة خطوة واحدة لفتح خانة له. وعند الحذف، يجب إزاحة العناصر بالاتجاه المعاكس لسد الفراغ. وتبلغ تكلفة هذه العمليات $O(n)$ في أسوأ الحالات، أما الإضافة في نهاية المصفوفة الديناميكية فتكون سريعة في الغالب بفضل التكلفة المطفأة (Amortized Cost). وفيما يلي ملخص لـالعمليات وتكلفتها:
- الوصول بالفهرس (Access): زمن ثابت $O(1)$ لأن العنوان يحسب حسابيا.
- البحث الخطي (Linear Search): زمن خطي $O(n)$ عند عدم الترتيب.
- البحث الثنائي (Binary Search): زمن لوغاريتمي $O(\log n)$ بشرط ترتيب المصفوفة.
- الإدراج (Insertion): زمن خطي $O(n)$ بسبب إزاحة العناصر عند الإدراج في البداية أو المنتصف.
- الحذف (Deletion): زمن خطي $O(n)$ للسبب نفسه، ويكون ثابتا عند الحذف من النهاية.
مزايا المصفوفات وعيوبها
تتفوق المصفوفات على غيرها في الوصول المباشر، فهي الأسرع في قراءة أي عنصر من موقعه. كما أنها تستهلك ذاكرة أقل، لأنها لا تحتاج إلى مؤشرات إضافية بين العناصر كما في القوائم المرتبطة. وتستفيد استفادة قصوى من الذاكرة المخبئية بسبب التجاور، مما يمنحها أداء عمليا ممتازا عند المرور على كل العناصر. وتتميز كذلك ببساطة التنفيذ وسهولة الفهم، وبدعمها المدمج في جميع لغات البرمجة تقريبا، وهو ما يجعلها خيارا آمنا وفعالا في مواقف كثيرة.
وفي المقابل، تعاني المصفوفات من قيود حقيقية يجب معرفتها. فـحجمها ثابت في أغلب التنفيذات التقليدية، وإذا كبرت البيانات عن المتوقع فلا بد من إعادة الحجز والنسخ. كما أن الإدراج والحذف في المنتصف مكلفان بسبب الإزاحة، وقد يتسبب حجز مساحة كبيرة مسبقا في هدر الذاكرة. وتعجز المصفوفة الثابتة عن تخزين أنواع مختلفة من القيم. ويمكن تلخص ذلك كما يلي:
- من المزايا: وصول فوري بالفهرس، وكفاءة ذاكرة عالية، وأداء ممتاز مع الذاكرة المخبئية، وبساطة في الاستخدام.
- من العيوب: حجم ثابت في التنفيذ التقليدي، وتكلفة عالية للإدراج والحذف في المنتصف، واحتمال هدر المساحة، وصعوبة التوسع عند الامتلاء.
متى نستخدم المصفوفات؟
تصلح المصفوفات عندما يكون عدد العناصر معروفا مسبقا أو قريبا من الثبات. فإذا كنت تخزن أيام الأسبوع أو أشهر السنة أو أبعاد صورة معروفة، فالمصفوفة هي الاختيار الطبيعي. كما تناسب الحالات التي تتكرر فيها القراءة بالفهرس أكثر من التعديل البنيوي، مثل جداول البحث (Lookup Tables) والمخازن المؤقتة (Buffers). وفي هذه المواقف، تتفوق المصفوفة على القائمة المرتبطة والشجرة من حيث السرعة واستهلاك الموارد.
وتعد المصفوفات الخيار المفضل كذلك عند المرور المتكرر على كل العناصر، لأن التجاور يمنح المعالج أفضل أداء ممكن. ولهذا تعتمد عليها المعالجة العددية والرسوميات وتعلم الآلة، حيث تجري العمليات على ملايين القيم دفعة واحدة. فمكتبة NumPy في Python مثلا تبنى على مصفوفات متجانسة متجاورة في الذاكرة، وهو سر كونها أسرع بـعشرات المرات من القوائم العادية في الحسابات العلمية. كما تستخدم المصفوفات كـأساس داخلي لـجداول التجزئة والكومات.
وفي المقابل، يجب تجنب المصفوفات عندما تتغير بنية البيانات باستمرار، أي عندما تكثر الإضافات والحذوف في المنتصف أو البداية. وكذلك عندما يستحيل تقدير الحجم مسبقا ويكون الهدر غير مقبول، أو عندما تحتاج إلى علاقات معقدة بين العناصر. في هذه الحالات تبرز بدائل مثل القوائم المرتبطة والأشجار والرسوم البيانية. والقاعدة الذهبية هنا أن تحلل أنماط الاستخدام أولا، ثم تختار الهيكل الذي يخدم العمليات الأكثر تكرارا.
مثال عملي على إنشاء مصفوفة والتعامل مع عناصرها بلغة Python
يوضح المثال التالي العمليات الأساسية على مصفوفة في لغة Python، باستخدام القائمة (List) المدمجة التي تعمل كمصفوفة ديناميكية. ويشمل الإنشاء والقراءة والتعديل والإضافة والحذف والبحث والمرور على العناصر، مع تعليقات توضح تكلفة كل عملية:
# إنشاء مصفوفة من الدرجات
grades = [85, 90, 78, 92, 88]

# الوصول إلى عنصر بالفهرس (زمن ثابت O(1))
print(grades[0])      # 85
print(grades[-1])     # 88 (العنصر الأخير)

# تعديل عنصر (O(1))
grades[2] = 80

# الإضافة في النهاية (O(1) مطفأة)
grades.append(95)

# الإدراج في موضع محدد (O(n) بسبب إزاحة العناصر)
grades.insert(1, 99)

# الحذف بالقيمة (O(n)) وبالفهرس
grades.remove(92)
removed = grades.pop(0)

# البحث عن قيمة (O(n))
if 88 in grades:
    print("القيمة موجودة في الموضع", grades.index(88))

# المرور على جميع العناصر
for index, value in enumerate(grades):
    print(index, value)

# مصفوفة ثنائية الأبعاد (جدول من صفين وثلاثة أعمدة)
table = [[1, 2, 3],
         [4, 5, 6]]
print(table[1][2])    # 6
يبدأ الكود بإنشاء مصفوفة من خمس درجـات، ثم يصل إلى عنصرها الأول والأخير بزمن ثابت. ويستخدم الفهرس السالب -1 للوصول إلى آخر عنصر، وهي ميزة تميز Python. بعد ذلك يعدل العنصر الثالث مباشرة، ثم يضيف درجة جديدة في النهاية بكلفة منخفضة. وعند استخدام insert أو remove أو pop(0)، يعمل النظام على إزاحة العناصر، ولذلك تكون التكلفة خطية. وهذه الملاحظة مهمة جدا عند التعامل مع قوائم كبيرة.
ويختتم المثال بـمصفوفة ثنائية الأبعاد تمثل جدولا من صفين وثلاثة أعمدة، ويتم الوصول إلى عناصرها بـفهرسين متتاليين. ويجب الانتباه إلى أن قائمة Python تخزن مراجع إلى الكائنات وليس القيم نفسها، ولذلك فهي أقل كفاءة في الذاكرة من المصفوفات في لغة C. وعندما تحتاج إلى أداء عال في الحسابات العددية، فالأفضل استخدام وحدة array أو مكتبة NumPy اللتين تخزنان القيم متجاورة ومتجانسة.فاءة في الذاكرة من المصفوفات في لغة C. وعندما تحتاج إلى أداء عال في الحسابات العددية، فالأفضل استخدام وحدة array أو مكتبة NumPy اللتين تخزنان القيم متجاورة ومتجانسة.
القوائم المرتبطة بهياكل البيانات
إذا كانت المصفوفة تقوم على التجاور، فإن القائمة المرتبطة (Linked List) تقوم على الارتباط. فهي تتخلى عن فكرة الكتلة المتصلة، وتسمح لكل عنصر بأن يعيش في أي موضع من الذاكرة، ما دام يعرف عنوان جاره. وتمنح هذه الفلسفة القوائم المرتبطة مرونة كبيرة في الإدراج و الحذف و النمو، لكنها تفرض ثمنا في سرعة الوصول و استهلاك الذاكرة. ولذلك تعد القوائم المرتبطة المثال الأبرز على المقايضة بين الأداء والمرونة، وهي مدخل ضروري لفهم الأشجار و الرسوم البيانية.
ما هي القوائم المرتبطة (Linked Lists)؟
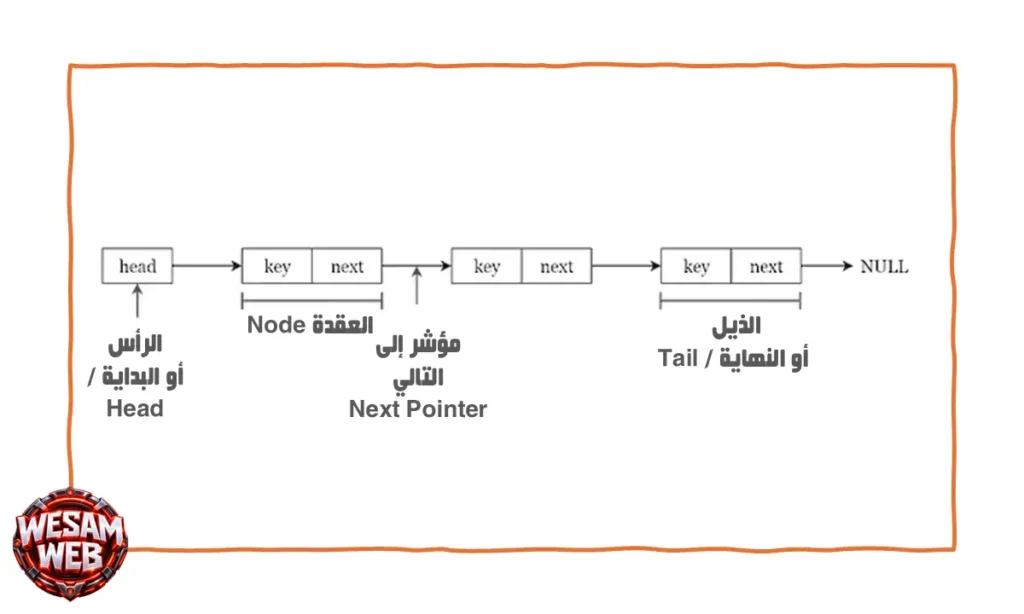
القائمة المرتبطة (Linked List) هي هيكل بيانات خطي يتكون من سلسلة من العقد (Nodes)، تحمل كل عقدة قيمة ومرجعا إلى العقدة التالية. ولا تحتاج العقد إلى التجاور في الذاكرة، فقد تتناثر في مواقع مختلفة تماما. ويرتبط ترتيب العناصر المنطقي بالمؤشرات وليس بالعناوين الفيزيائية. وتبدأ القائمة من عقدة تسمى الرأس (Head)، وتنتهي بعقدة يشير مرجعها إلى لا شيء (Null أو None)، مما يعلن نهاية السلسلة.
وتعمل القائمة المرتبطة بمنطق سلسلة الحلقات أو قطار العربات. فلكي تصل إلى العربة الخامسة، لا بد أن تمر على الأولى والثانية والثالثة والرابعة، فلا يوجد اختصار يقفز بك إليها مباشرة. وهذا هو الفرق الجوهري عن المصفوفة، فالوصول إلى العنصر رقم k يتطلب المرور على k عقدة، وتكلفته خطية O(n)O(n)O(n). ولكن في المقابل، فإن إضافة عربة جديدة بين عربتين لا يتطلب تحريك بقية العربات، بل يكفي تعديل رابطين فقط.
وتستخدم القوائم المرتبطة في حالات يكون حجم البيانات فيها غير معروف مسبقا أو متغيرا باستمرار. فهي تنمو وتتقلص عقدة بعقدة دون حاجة إلى حجز مسبق أو نسخ كامل. كما أنها تشكل الأساس لعدد من التنفيذات، مثل المكدسات و الطوابير وسلاسل التصادم في جداول التجزئة، وكذلك قوائم التشغيل وسجل التصفح. وتتنوع أشكالها بين أحادية الاتجاه وثنائية الاتجاه ودائرية، وسنفصلها تباعا.
كيف تتكون العقد (Nodes) والمؤشرات والمراجع (Pointers and References)؟
العقدة (Node) هي الوحدة الأساسية في القائمة المرتبطة، وتتكون من جزأين رئيسيين. الجزء الأول هو حقل البيانات (Data) الذي يحمل القيمة المخزنة، سواء كانت عددا أو نصا أو كائنا كاملا. الجزء الثاني هو حقل الرابط (Next) الذي يحمل عنوان العقدة التالية. وتتصل العقد ببعضها عبر هذه الروابط، فتشكل سلسلة متتابعة. وإذا فقدت رابطا واحدا في منتصف السلسلة، فقدت الوصول إلى كل ما بعده، ولذلك تتطلب العمليات على القوائم دقة عالية.
ويختلف مفهوم الرابط بحسب اللغة. ففي لغتي C و C++ نتعامل مع مؤشرات (Pointers) تخزن العنوان الفيزيائي المباشر في الذاكرة، ويتحمل المبرمج مسؤولية حجزها وتحريرها، وأي خطأ فيها قد ينتج تسريب ذاكرة أو انهيار البرنامج. أما في Python و Java فنتعامل مع مراجع (References) تدير اللغة تفاصيلها، ويتولى جامع النفايات (Garbage Collector) تحرير العقد غير المستخدمة. والفكرة المنطقية واحدة في الحالتين، لكن درجة الأمان والتحكم تختلف كثيرا.
وتتحمل المؤشرات والمراجع كلفة لا يجب إغفالها. فكل عقدة تستهلك ذاكرة إضافية لتخزين الرابط، وهو عادة ثمانية بايتات في الأنظمة 64 بت. وإذا كانت القيمة نفسها صغيرة كـعدد صحيح، فقد يتجاوز حجم الرابط حجم البيانات نفسها. كما أن تشتت العقد في الذاكرة يضعف كفاءة الذاكرة المخبئية (Cache)، لأن كل انتقال بين عقدتين قد يتطلب جلبا جديدا من الذاكرة الرئيسية. وهذه التكاليف تفسر لماذا تتفوق المصفوفة عمليا في كثير من الحالات.
القائمة المرتبطة أحادية الاتجاه (Singly Linked List)
القائمة المرتبطة أحادية الاتجاه (Singly Linked List) هي أبسط الأشكال، وتحمل كل عقدة فيها رابطا واحدا يشير إلى العقدة التالية فقط. ولذلك يمكن التحرك فيها في اتجاه واحد من الرأس إلى النهاية، ولا يمكن الرجوع إلى عقدة سابقة دون البدء من الرأس من جديد. وتتميز ببساطة التنفيذ وقلة استهلاك الذاكرة مقارنة بـالأنواع الأخرى، لأن كل عقدة تحمل رابطا واحدا فقط. وهي الأنسب عندما يكفي المرور في اتجاه واحد.
وتتسم عمليات القائمة أحادية الاتجاه بتكاليف واضحة. فـالإدراج في بداية القائمة سريع جدا بزمن ثابت O(1)O(1)O(1)، إذ يكفي إنشاء عقدة جديدة وربطها بالرأس القديم ثم جعلها الرأس الجديد. أما الإدراج في النهاية فيحتاج للمرور على القائمة كلها ما لم نحتفظ بمؤشر إلى الذيل (Tail). والحذف يتطلب معرفة العقدة السابقة للعقدة المحذوفة لتعديل رابطها، وهذه المعرفة تقتضي المرور من الرأس. وهنا يظهر عيب غياب الرجوع للخلف.
وتناسب هذه القوائم تطبيقات كثيرة بسيطة. فهي تستخدم في تنفيذ المكدسات حيث تتم الإضافة والحذف دائما عند الرأس، وفي تنفيذ الطوابير إذا احتفظنا بمؤشرين إلى الرأس والذيل. كما تستخدم في سلاسل التصادم داخل جداول التجزئة، وفي تمثيل كثيرات الحدود الرياضية. وتعد أول ما يطلب من المرشحين تنفيذه في المقابلات التقنية، ومنه عكس القائمة وكشف الدورات، لأنها تختبر فهم المؤشرات والحالات الحدية.
القائمة المرتبطة ثنائية الاتجاه (Doubly Linked List)
تضيف القائمة المرتبطة ثنائية الاتجاه (Doubly Linked List) رابطا ثانيا في كل عقدة، فتحمل العقدة مرجعا إلى التالية (Next) ومرجعا إلى السابقة (Prev). وبهذا يمكن التنقل في الاتجاهين، أمامي وخلفي، وهو ما يفتح إمكانيات لا تتيحها القائمة أحادية الاتجاه. فيمكن الحذف من أي موضع بمعرفة العقدة نفسها فقط، لأن العقدة السابقة متاحة عبر الرابط الخلفي. ويحتفظ التنفيذ عادة بمؤشرين، الرأس (Head) والذيل (Tail)، مما يجعل الوصول إلى الطرفين فوريا.
وتأتي هذه المرونة بـثمن واضح في الذاكرة وتعقيد التنفيذ. فكل عقدة تحمل رابطين بدلا من واحد، فيزداد استهلاك الذاكرة بمقدار مؤشر كامل لكل عقدة. كما أن كل عملية إدراج أو حذف تتطلب تحديث عدد أكبر من الروابط، مما يرفع احتمال الخطأ، فنسيان تحديث رابط واحد قد يكسر سلامة القائمة. ولذلك يجب الحرص على ترتيب خطوات التحديث بدقة، وعلى اختبار الحالات الحدية مثل القائمة الفارغة والعقدة الوحيدة.
وتجد القوائم ثنائية الاتجاه استخدامات عملية واسعة. فـخاصية التراجع والإعادة (Undo/Redo) في المحررات تعتمد على التنقل للأمام والخلف بين الحالات، وسجل التصفح في المتصفحات يعمل بالطريقة نفسها. كما تستخدم في تنفيذ ذاكرة التخزين المؤقت LRU Cache حيث تنقل العناصر المستخدمة حديثا إلى المقدمة بسرعة، وفي قوائم تشغيل الموسيقى التي تسمح بالانتقال إلى الأغنية السابقة أو التالية. وتنفذ الفئة LinkedList في Java وdeque في Python بنية مشابهة.
القائمة المرتبطة الدائرية (Circular Linked List)
في القائمة المرتبطة الدائرية (Circular Linked List)، لا تنتهي العقدة الأخيرة بـقيمة فارغة، بل يشير رابطها إلى العقدة الأولى، فتشكل السلسلة حلقة مغلقة. ويمكن تطبيق هذه الفكرة على القوائم أحادية الاتجاه وثنائية الاتجاه على حد سواء. ونتيجة لهذا التصميم، لا يوجد طرف نهائي يمكن الوقوف عنده، فإذا استمررت في التنقل عبر الروابط، عدت إلى نقطة البداية مرارا. ولذلك يجب الانتباه عند المرور إلى شرط التوقف حتى لا تقع في حلقة لا نهائية.
وتتميز القائمة الدائرية بقدرتها على تمثيل العمليات الدورية بصورة طبيعية. فإذا كان لديك مجموعة من المهام يجب تدويرها باستمرار، مثل تقسيم وقت المعالج بين العمليات، فإن الانتقال من العقدة الأخيرة إلى الأولى يحدث تلقائيا دون منطق خاص. كما يمكن الحفاظ على مؤشر واحد إلى الذيل فقط، لأن الرأس هو التالي للذيل مباشرة، فيصبح الإدراج في البداية والنهاية كلاهما بزمن ثابت باستخدام مؤشر واحد.
وتظهر القوائم الدائرية في تطبيقات عملية متنوعة. فـجدولة المهام بأسلوب Round Robin في أنظمة التشغيل تعتمد عليها لمنح كل عملية حصة زمنية متساوية بالتناوب. كما تستخدم في الألعاب متعددة اللاعبين لتحديد دور اللاعب التالي، وفي المخازن الحلقية (Circular Buffers) التي تستخدم في البث الصوتي ومعالجة الإشارات. وعلى الرغم من فائدتها، يجب التعامل بحذر، لأن أخطاء المؤشرات فيها قد تؤدي إلى دورات لا نهائية يصعب تشخيصها.
كيفية إدراج العناصر وحذفها والبحث عنها
تعتمد عمليات القائمة المرتبطة على إعادة توجيه الروابط وليس على نقل البيانات. فعند الإدراج بعد عقدة معينة، تنشأ عقدة جديدة، ثم يربط رابطها بـالعقدة التالية للعقدة المرجعية، وبعد ذلك يحدث رابط العقدة المرجعية ليشير إلى الجديدة. وترتيب هاتين الخطوتين مهم جدا، فلو عدلنا رابط العقدة المرجعية أولا، فقدنا مرجع بقية القائمة. أما الحذف فيتم بـتجاوز العقدة عبر جعل رابط السابقة يشير إلى اللاحقة مباشرة، ثم تحرير العقدة المحذوفة.
أما البحث فهو المرحلة الأضعف في القوائم المرتبطة، إذ لا يتوفر فهرس يقفز بك إلى الموضع المطلوب. يبدأ البحث من الرأس، ويفحص كل عقدة بالتتابع، حتى يعثر على القيمة أو يصل إلى النهاية. وتبلغ تكلفته O(n)O(n)O(n) في أسوأ الحالات حتى لو كانت القائمة مرتبطة بترتيب معين، لأن البحث الثنائي غير ممكن دون وصول عشوائي. ولذلك تؤخذ تكلفة العثور على الموضع في الحسبان عند مقارنة سرعة الإدراج والحذف بـالمصفوفات.
وفيما يلي ملخص لتكلفة العمليات في القائمة أحادية الاتجاه:
- الإدراج في البداية: زمن ثابت O(1) لأنه يتطلب تعديل الرأس فقط.
- الإدراج في النهاية: زمن ثابت O(1) مع وجود مؤشر للذيل، وإلا فهو خطي O(n).
- الإدراج بعد عقدة معلومة: زمن ثابت O(1) بعد الوصول إلى العقدة.
- الحذف: زمن ثابت إذا عرفنا العقدة السابقة، وإلا فهو خطي بسبب البحث عنها.
- البحث والوصول بالموضع: زمن خطي O(n) لأنه يتطلب المرور على العقد تتابعيا.
مزايا القوائم المرتبطة وعيوبها
تتميز القوائم المرتبطة بـمرونة الحجم، فهي تنمو وتتقلص حسب الحاجة دون حجز مسبق أو نسخ إلى كتلة جديدة. كما أن الإدراج والحذف فيها سريعان عند معرفة الموضع، لأنهما لا يتطلبات إزاحة العناصر. ولا تحتاج القائمة إلى ذاكرة متصلة، فيمكنها العمل حتى لو كانت الذاكرة مجزأة. وتصلح أساسا ممتازا لـهياكل أخرى مثل المكدسات و الطوابير. وتتجنب هدر الذاكرة لأنها لا تحجز إلا ما تحتاجه فعلا من العقد.
لكن للقوائم المرتبطة عيوبا مؤثرة تحد من انتشارها. فهي لا تدعم الوصول العشوائي، فالوصول إلى العنصر رقم k يتطلب المرور على k عقدة. كما تستهلك ذاكرة إضافية للمؤشرات في كل عقدة، وتعاني من ضعف الاستفادة من الذاكرة المخبئية بسبب تشتت العقد. وهي أصعب في التنفيذ والتنقيح من المصفوفات، لأن أخطاء المؤشرات قد تؤدي إلى تسريبات أو أعطال. وتلخص النقاط التالية الفكرة:
- من المزايا: حجم ديناميكي مرن، وإدراج وحذف سريعان، وعدم الحاجة إلى ذاكرة متصلة، وصلاحية لبناء هياكل أخرى.
- من العيوب: غياب الوصول العشوائي، واستهلاك ذاكرة إضافي للمؤشرات، وأداء أضعف مع الذاكرة المخبئية، وتعقيد أكبر في التنفيذ.
الفرق بين المصفوفات والقوائم المرتبطة
يلخص الجدول التالي الفروق الجوهرية بين أشهر هيكلين خطيين، وهو مرجع سريع يساعد على اتخاذ القرار عند اختيار الهيكل المناسب. ويجب الانتباه إلى أن الأرقام النظرية لا تعكس دائما الأداء الفعلي، فكثيرا ما تتفوق المصفوفات عمليا حتى في عمليات يفترض أن القوائم أسرع فيها، بسبب التجاور والذاكرة المخبئية.
| وجه المقارنة | المصفوفة (Array) | القائمة المرتبطة (Linked List) |
|---|---|---|
| طريقة التخزين | كتلة متصلة من الذاكرة | عقد متفرقة مرتبطة بمؤشرات |
| الوصول بالفهرس | فوري بزمن O(1) | تتابعي بزمن O(n) |
| الإدراج والحذف في البداية | مكلف O(n) بسبب الإزاحة | سريع O(1) |
| الإدراج والحذف في المنتصف | مكلف O(n) | سريع O(1) بعد الوصول إلى الموضع |
| استهلاك الذاكرة | أقل بلا مؤشرات | أكبر بسبب الروابط |
| الذاكرة المخبئية | ممتازة بفضل التجاور | ضعيفة بسبب التشتت |
| تغيير الحجم | صعب وقد يتطلب نسخا | سهل وبلا نسخ |
| البحث | O(n) أو O(logn) إذا كانت مرتبة | O(n) دائما |
| أفضل استخدام | قراءة متكررة بالفهرس وحجم معروف | تعديلات متكررة وحجم متغير |
مثال عملي على إنشاء قائمة مرتبطة والتعامل مع عناصرها
يوضح المثال التالي تنفيذا كاملا لـقائمة مرتبطة أحادية الاتجاه في لغة Python، ويتضمن فئة العقدة وفئة القائمة مع عمليات الإضافة في البداية والنهاية والحذف والبحث والطباعة. وقد روعيت فيه الحالات الحدية مثل القائمة الفارغة وحذف الرأس:
class Node:
    """عقدة تحمل قيمة ومرجعا إلى العقدة التالية"""
    def __init__(self, data):
        self.data = data
        self.next = None


class LinkedList:
    def __init__(self):
        self.head = None

    def add_first(self, data):
        # الإدراج في البداية: O(1)
        node = Node(data)
        node.next = self.head
        self.head = node

    def add_last(self, data):
        # الإدراج في النهاية: O(n) لأننا نمر على القائمة
        node = Node(data)
        if self.head is None:
            self.head = node
            return
        current = self.head
        while current.next:
            current = current.next
        current.next = node

    def delete(self, data):
        # الحذف بالقيمة: O(n)
        if self.head is None:
            return False
        if self.head.data == data:
            self.head = self.head.next
            return True
        current = self.head
        while current.next:
            if current.next.data == data:
                current.next = current.next.next
                return True
            current = current.next
        return False

    def search(self, data):
        # البحث: O(n)
        current = self.head
        position = 0
        while current:
            if current.data == data:
                return position
            current = current.next
            position += 1
        return -1

    def display(self):
        items = []
        current = self.head
        while current:
            items.append(str(current.data))
            current = current.next
        print(" -> ".join(items) + " -> None")


# التجربة
numbers = LinkedList()
numbers.add_last(20)
numbers.add_last(30)
numbers.add_first(10)
numbers.display()          # 10 -> 20 -> 30 -> None
numbers.delete(20)
numbers.display()          # 10 -> 30 -> None
print(numbers.search(30))  # 1
يعتمد الكود على فئتين، الأولى هي Node التي تمثل العقدة بحقلين هما data وnext، والثانية هي LinkedList التي تحتفظ بمرجع إلى الرأس (head). وتتم الإضافة في البداية بإنشاء عقدة جديدة وربطها بالرأس الحالي ثم جعلها الرأس، وهي عملية ثابتة الزمن O(1). أما الإضافة في النهاية فتتطلب المرور على القائمة حتى آخر عقدة، ولذلك فهي خطية O(n). ويمكن تحسينها بحفظ مؤشر للذيل كما أشرنا سابقا.
وفي دالة الحذف، يعالج الكود حالتين منفصلتين، هما حذف الرأس وحذف عقدة من الوسط أو النهاية. ففي الحالة الأولى يكفي نقل الرأس إلى العقدة التالية، وفي الثانية يتم تجاوز العقدة عبر ربط السابقة باللاحقة. أما دالة البحث فتعيد موضع العنصر أو تنبيهنا بعدم وجوده بزمن خطي O(n).وضع القيمة أو -1 إذا لم توجد. ويجب اختبار هذا التنفيذ على حالات حدية مثل القائمة الفارغة والقيمة غير الموجودة والعنصر الوحيد، فهي المواضع التي تكثر فيها الأخطاء المنطقية في المقابلات والتطبيقات الحقيقية.
المكدسات (Stacks) في هياكل البيانات
يعد المكدس (Stack) من أبسط هياكل البيانات من حيث الفكرة، وأكثرها حضورا في عمل الحاسوب من الداخل. فبينما تمنحك المصفوفة حرية الوصول إلى أي عنصر، يفرض عليك المكدس قيدا صارما، فلا تتعامل إلا مع العنصر الذي يقف في القمة. وهذا القيد ليس عيبا في التصميم، بل ميزة مقصودة تجعل سلوك الهيكل قابلا للتوقع وآمنا وسهل التحليل. ولذلك يعتمد نظام التشغيل والمترجمات والمتصفحات والمحررات النصية على المكدسات في مهام لا يمكن الاستغناء عنها.
ما هو المكدس (Stack)؟
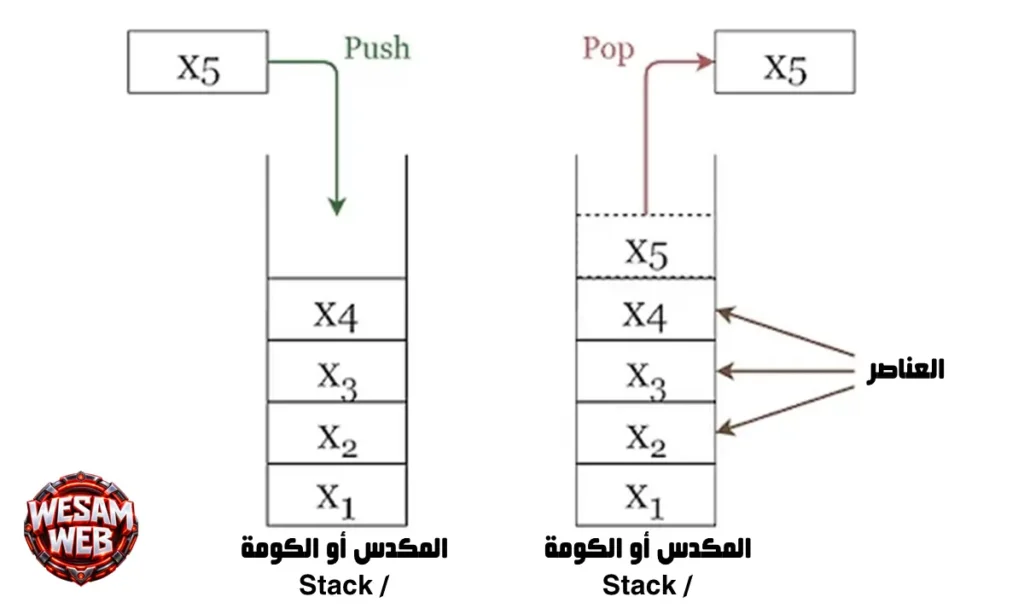
المكدس (Stack) هو هيكل بيانات خطي يسمح بالإضافة والإزالة من طرف واحد فقط، يسمى القمة (Top). ويشبه كومة الكتب الموضوعة فوق المكتب، فلا يمكنك سحب كتاب من منتصف الكومة دون إسقاط ما فوقه، بل تأخذ الكتاب العلوي أولا ثم الذي يليه. وهذا التصور البسيط يلخص جوهر المكدس، فهو وعاء مفتوح من الأعلى ومغلق من الأسفل. وكل عنصر جديد يوضع فوق العناصر السابقة، وكل عنصر يزال يؤخذ من الأعلى حتما.
ويصنف المكدس ضمن أنواع البيانات المجردة (ADT)، لأنه يعرف سلوكا محددا ولا يفرض طريقة تنفيذ معينة. فيمكن بناؤه فوق مصفوفة ديناميكية حيث تمثل نهاية المصفوفة القمة، ويمكن بناؤه فوق قائمة مرتبطة حيث يمثل الرأس القمة. ويتفوق التنفيذ بالمصفوفة في الاستفادة من الذاكرة المخبئية وقلة المؤشرات، بينما يتفوق التنفيذ بالقائمة في المرونة وعدم الحاجة إلى نسخ عند التوسع. وكلا التنفيذين يوفر العمليات الأساسية بزمن ثابت $O(1)$.
ويقودنا هذا التعريف إلى فهم سبب انتشار المكدس في علوم الحاسوب. فكثير من المشكلات تحمل طبيعة متداخلة، أي أن آخر شيء بدأناه يجب أن ننهيه أولا، مثل الدوال التي تستدعي دوالا أخرى، والأقواس التي تفتح داخل أقواس. وهذه البنية المتداخلة تطابق سلوك المكدس تماما، ولهذا يستخدم كلما احتاج البرنامج إلى تذكر المراحل السابقة والعودة إليها بترتيب عكسي.
مبدأ آخر من يدخل أولا يخرج (Last In, First Out, LIFO)
مبدأ LIFO هو القاعدة الأساسية التي يقوم عليها المكدس، ومعناه أن آخر عنصر أضيف هو أول عنصر يخرج. فإذا أضفت الأرقام 1 ثم 2 ثم 3 إلى مكدس فارغ، فسيكون الرقم 3 في القمة، وعند الإزالة تحصل على 3 أولا، ثم 2، ثم 1. وهذا الترتيب العكسي هو الخاصية الأبرز للمكدس، وهو ما يميزه عن الطابور الذي يعمل بالعكس تماما. ويمكن تشبيهه بـ كومة الصحون في المطعم، فالصحن الأخير الذي وضع هو أول من يسحب.
وتكمن أهمية هذا المبدأ في أنه يحافظ على السياق الزمني للعمليات. فعندما يدخل البرنامج في سلسلة استدعاءات متداخلة، يجب أن يعود أولا من آخر دالة استدعيت، ثم التي قبلها، وهكذا حتى الدالة الأصلية. وكذلك عند التراجع في محرر النصوص، يتم إلغاء آخر تعديل أولا، ثم الذي قبله. وفي الحالتين، ترتيب الخروج هو عكس ترتيب الدخول تماما، وهذا بالضبط ما يضمنه LIFO دون حاجة إلى منطق إضافي.
ويجب الانتباه إلى أن المبدأ لا يخص المكدسات وحدها من حيث الفكرة، لكنه يفرض على المكدس قيدا في الوصول. فلا يجوز قراءة العنصر الأوسط أو تعديله مباشرة، ولا المرور على العناصر دون إزالتها، إلا إذا أضيفت عمليات خاصة. وهذا التقييد يحمي البرنامج من أخطاء التلاعب بالترتيب، ويجعل منطق المكدس واضحا وسهل الاختبار، ولذلك يفضله المبرمجون عندما يريدون ضمان الترتيب العكسي.
العمليات الأساسية للمكدس: Push وPop وPeek
تدور العمليات الأساسية للمكدس حول ثلاث عمليات رئيسية. عملية Push تضيف عنصرا جديدا إلى القمة، وتزيد حجم المكدس بواحد. عملية Pop تزيل العنصر الموجود في القمة وتعيده للمستخدم، وتنقص الحجم بواحد. أما عملية Peek (وتسمى أحيانا Top) فتعيد قيمة القمة دون إزالتها، وتستخدم للاطلاع على العنصر التالي دون تغيير المكدس. وتنفذ هذه العمليات الثلاث جميعها بزمن ثابت $O(1)$، لأنها تتعامل مع طرف واحد فقط.
وإلى جانب العمليات الرئيسية، توفر أغلب التنفيذات عمليات مساعدة ضرورية للتحقق من حالة المكدس. ويجب الانتباه إلى حالتين خاصتين تسببان أخطاء شائعة، هما الفيض السفلي (Underflow) عند محاولة Pop من مكدس فارغ، و الفيض العلوي (Overflow) عند محاولة Push في مكدس ممتلئ ذي سعة ثابتة. ولذلك يفحص المبرمج المحترف حالة المكدس قبل كل عملية. وتوضح النقاط التالية العمليات وتكلفتها:
- Push: إضافة عنصر إلى القمة، وتكلفتها ثابتة $O(1)$، وقد تتطلب توسيعا عند الامتلاء في التنفيذ الديناميكي.
- Pop: إزالة عنصر القمة وإعادته، وتكلفتها ثابتة $O(1)$، وتسبب خطأ إذا كان المكدس فارغا.
- Peek: قراءة القمة دون إزالتها، وتكلفتها ثابتة $O(1)$.
- isEmpty: فحص هل المكدس فارغ، وهي عملية وقائية لتفادي الفيض السفلي.
- Size: إرجاع عدد العناصر الحالية في المكدس.
كيف يعمل المكدس في ذاكرة البرامج؟
لا يقتصر المكدس على كونه هيكلا نكتبه في الشيفرة، بل هو جزء أصيل من بنية الذاكرة لكل برنامج قيد التشغيل. فكل خيط تنفيذ (Thread) يحصل على منطقة ذاكرة تسمى مكدس الاستدعاءات (Call Stack)، وتحتفظ بـمعلومات كل دالة يجري تنفيذها. وعند استدعاء دالة، يضاف إلى القمة إطار يسمى إطار المكدس (Stack Frame) يحمل المتغيرات المحلية ووسائط الدالة وعنوان العودة. وعند انتهاء الدالة، يزال هذا الإطار وتعود السيطرة إلى الدالة المستدعية من العنوان المحفوظ.
ويفسر هذا الآلية ظواهر نصادفها في البرمجة. فعندما تستدعي دالة نفسها بصورة متكررة دون شرط توقف صحيح، تتراكم الأطر فوق بعضها حتى تستنفد المساحة المخصصة للمكدس، فيحدث الخطأ المعروف بـ فيض المكدس (Stack Overflow). وهذا ما يحدث في الدوال العودية (Recursion) سيئة التصميم. وسبب سرعة التعامل مع المكدس أن الحجز والتحرير يتمان بـتحريك مؤشر واحد فقط يسمى مؤشر المكدس (Stack Pointer)، دون بحث عن مساحة حرة.
ويختلف مكدس الاستدعاءات عن الكومة (Heap) في جوهر الإدارة. فالمكدس منظم وذو حجم محدود غالبا بحدود ميغابايتات قليلة، ويحرر تلقائيا بمجرد خروج الدالة. أما الكومة فهي أكبر وأكثر مرونة، لكنها تحتاج إلى إدارة يدوية أو جامع نفايات. ولذلك تخزن القيم الصغيرة ذات العمر القصير في المكدس، بينما تخزن الكائنات الكبيرة أو طويلة العمر في الكومة. وفهم هذا الفرق يساعد على تشخيص أخطاء الذاكرة في لغات مثل C و C++.
استخدامات المكدسات في التراجع واستدعاء الدوال والتحقق من الأقواس
تظهر المكدسات بوضوح في ميزة التراجع (Undo) الموجودة في محررات النصوص وبرامج التصميم. ففي كل مرة تجري فيها تعديلا، يحفظ البرنامج الحالة السابقة في مكدس، وعند الضغط على زر التراجع، يخرج آخر تعديل ويعيد الحالة إلى ما قبله. وغالبا يوجد مكدس ثان لـ الإعادة (Redo) يستقبل الحالات التي تم التراجع عنها. ويعمل سجل التصفح في المتصفح بـفكرة مشابهة، فزر الرجوع يعيدك إلى آخر صفحة زرتها أولا.
ويستخدم المكدس كذلك في التحقق من توازن الأقواس في التعبيرات البرمجية والرياضية، وهو مثال كلاسيكي يطرح في المقابلات. وتتلخص الخوارزمية في قراءة التعبير رمزا رمزا، فعند قوس مفتوح يضاف إلى المكدس، وعند قوس مغلق يقارن بـالقمة، فإذا تطابقا يزال القوس من المكدس، وإلا فالتعبير غير متوازن. وفي النهاية يجب أن يكون المكدس فارغا. وتعتمد المترجمات على الفكرة نفسها في تحليل الصياغة (Parsing). وتتعدد تطبيقات المكدس كما يلي:
- التراجع والإعادة (Undo/Redo): حفظ الحالات السابقة وإرجاعها بترتيب عكسي.
- استدعاء الدوال (Call Stack): تتبع الدوال النشطة وعناوين العودة إليها.
- التحقق من الأقواس: مطابقة الأقواس المفتوحة والمغلقة في التعبيرات.
- تقييم التعبيرات الرياضية: تحويل الصيغة الوسيطة إلى لاحقة (Postfix) وتقييمها.
- خوارزمية البحث بالعمق (DFS): تتبع المسار في الرسوم البيانية والأشجار.
مزايا المكدسات وقيودها
تتميز المكدسات بـ البساطة والسرعة، فعملياتها الأساسية جميعا تنفذ في زمن ثابت $O(1)$، ولا تحتاج إلى بحث أو إزاحة. كما أن قيد الوصول من طرف واحد يجعل سلوكها متوقعا ويقلل الأخطاء، ويسهل اختبار البرامج التي تستخدمها. وتتميز بسهولة التنفيذ سواء بالمصفوفة أو بالقائمة المرتبطة، وبكونها أساسا لعدد من الخوارزميات المهمة مثل البحث بالعمق وتقييم التعبيرات. كما أنها تدعم العودية على مستوى النظام نفسه.
وفي المقابل، لها قيود يجب الانتباه إليها. فلا يمكنها الوصول إلى عناصر المنتصف أو القاع دون إزالة ما فوقها، فهي غير مناسبة عندما تحتاج إلى بحث أو وصول عشوائي. كما أن المكدس ذي السعة الثابتة قد يمتلئ ويسبب فيضا علويا، ومكدس الاستدعاءات محدود الحجم مما يعرض الدوال العودية العميقة لـلانهيار. وتلخص النقاط التالية الفكرة:
- من المزايا: عمليات ثابتة الزمن، وبساطة التنفيذ، وسلوك متوقع، وملاءمة المشكلات المتداخلة.
- من القيود: وصول محدود إلى القمة فقط، وخطر الفيض العلوي والسفلي، وسعة محدودة في مكدس الاستدعاءات، وعدم ملاءمة البحث داخل العناصر.
مثال عملي على إنشاء مكدس بلغة Python
يعرض المثال التالي تنفيذا كاملا لـ مكدس باستخدام قائمة Python، مع معالجة حالة الفيض السفلي، ثم تطبيقا عمليا على التحقق من توازن الأقواس. ويظهر المثال كيف تتحول الفكرة النظرية إلى شيفرة قصيرة وواضحة:
class Stack:
    def __init__(self):
        self._items = []

    def push(self, item):
        # إضافة عنصر إلى القمة: O(1) مطفأة
        self._items.append(item)

    def pop(self):
        # إزالة عنصر القمة وإعادته: O(1)
        if self.is_empty():
            raise IndexError("المكدس فارغ")
        return self._items.pop()

    def peek(self):
        # قراءة القمة دون إزالتها: O(1)
        if self.is_empty():
            raise IndexError("المكدس فارغ")
        return self._items[-1]

    def is_empty(self):
        return len(self._items) == 0

    def size(self):
        return len(self._items)


def is_balanced(expression):
    pairs = {')': '(', ']': '[', '}': '{'}
    stack = Stack()
    for char in expression:
        if char in "([{":
            stack.push(char)
        elif char in ")]}":
            if stack.is_empty() or stack.pop() != pairs[char]:
                return False
    return stack.is_empty()


s = Stack()
s.push(1)
s.push(2)
s.push(3)
print(s.pop())    # 3 (آخر من دخل أول من يخرج)
print(s.peek())   # 2
print(is_balanced("{[()]}"))   # True
print(is_balanced("{[(])}"))   # False
تبني الفئة Stack المكدس فوق قائمة Python حيث تمثل نهاية القائمة القمة، وهو الاختيار الأمثل لأن الإضافة والإزالة من النهاية تتمان بزمن ثابت $O(1)$. وتغلف الفئة القائمة الداخلية وتخفيها، فلا يستطيع المستخدم الوصول إلى عناصر المنتصف، وهذا تطبيق عملي لمبدأ إخفاء التفاصيل. وتطلق دالتا pop وpeek استثناء واضحا عند المكدس الفارغ، بدلا من الفشل الصامت الذي يصعب اكتشافه لاحقا.
أما دالة is_balanced فتبين قوة المكدس في حل مشكلة عملية. فهي تدفع كل قوس مفتوح إلى المكدس، وعند القوس المغلق تسحب القمة وتتحقق من تطابقها، وتعيد False إذا وجدت عدم تطابق أو قوسا مغلقا بلا مقابل، وتتحقق في النهاية من أن المكدس فارغ تماما لتكتشف أي أقواس مفتوحة لم تغلق.واس المفتوحة غير المغلقة. ويظهر التعبير الثاني {[(])} غير متوازن رغم تساوي عدد الأقواس، لأن ترتيبها غير صحيح، وهو ما لا يكشفه مجرد العد.
الطوابير (Queues)
إذا كان المكدس يعمل بمنطق الأحدث أولا، فإن الطابور (Queue) يعمل بمنطق الأقدم أولا، وهو المنطق الذي نألفه في حياتنا اليومية حين ننتظر دورنا. وتعد الطوابير حجر الأساس في كل نظام يتعامل مع طلبات متتابعة، مثل أنظمة التشغيل و خوادم الويب و أنظمة الرسائل و الطابعات. وتكمن قيمتها في ضمان العدالة و عدم تجاوز طلب لآخر سبقه. وتتفرع الفكرة الأساسية إلى أنواع متعددة، منها الطابور الدائري و طابور الأولوية و الطابور مزدوج النهاية.
ما هو الطابور (Queue)؟
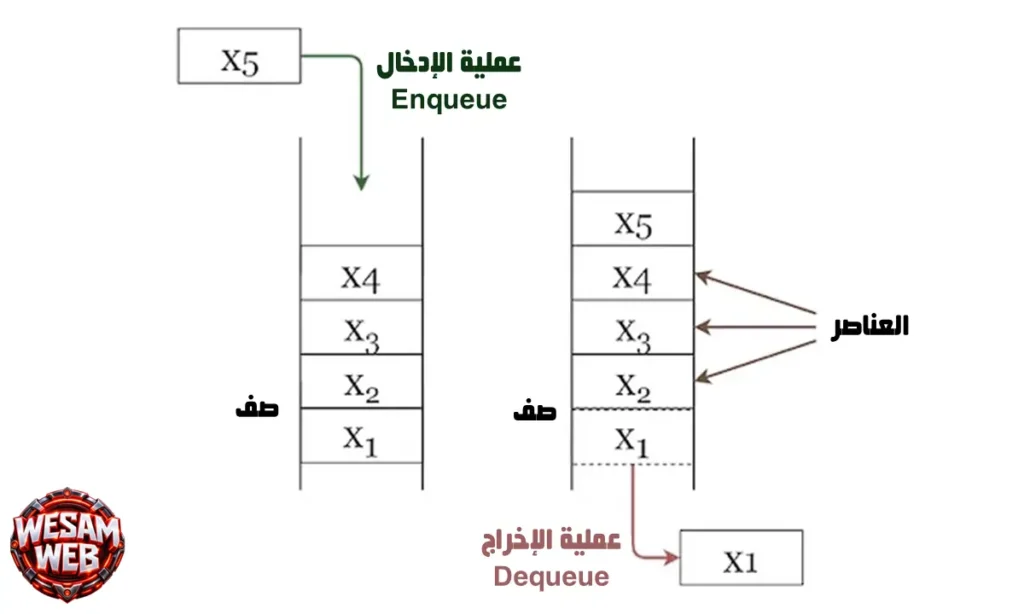
الطابور (Queue) هو هيكل بيانات خطي تضاف عناصره من طرف يسمى الخلف (Rear) وتزال من طرف آخر يسمى الأمام (Front). وهو نموذج مباشر لـ طابور الانتظار أمام شباك البنك، حيث يقف القادم الجديد في آخر الصف، ويخدم الواقف في المقدمة أولا. وبهذا يتحدد ترتيب الخدمة بـ ترتيب الوصول تماما، ولا يسمح لأحد بالقفز فوق غيره. وهذه العدالة في المعالجة هي السمة الجوهرية التي تميز الطابور.
ويصنف الطابور مثل المكدس ضمن أنواع البيانات المجردة (ADT)، فهو يحدد السلوك ويترك التنفيذ للمبرمج. ويمكن تنفيذه بـ مصفوفة تحتفظ بمؤشرين إلى الأمام والخلف، أو بـ قائمة مرتبطة تحتفظ بمؤشرين إلى الرأس والذيل. وينبغي الحذر من تنفيذ الطابور بقائمة عادية في Python مع إزالة العنصر الأول عبر pop(0)، لأنها عملية $O(n)$ بسبب إزاحة باقي العناصر. والحل الأفضل هو استخدام collections.deque الذي يوفر العمليات من الطرفين بزمن ثابت.
وتتجلى أهمية الطوابير في الأنظمة التي تعالج الطلبات بمعدل يختلف عن معدل وصولها. فعندما تصل الطلبات أسرع من قدرة الخادم، يحتفظ الطابور بها بترتيب وصولها إلى أن يحين دورها. ويعمل الطابور هنا كـ وسيط يمتص الاندفاعات المفاجئة ويحافظ على استقرار النظام. ولهذا تعد أنظمة الرسائل مثل RabbitMQ و Kafka تطبيقات ضخمة لـفكرة الطابور على مستوى البنية التحتية.
مبدأ أول من يدخل أولا يخرج (First In, First Out, FIFO)
مبدأ FIFO هو القاعدة الحاكمة للطابور، ومعناه أن العنصر الأقدم في الطابور هو أول من يخرج. فإذا أضفت العناصر A ثم B ثم C، فسيكون A في المقدمة، وعند الإزالة تحصل على A ثم B ثم C، أي بنفس ترتيب الدخول. وهذا عكس سلوك المكدس تماما، فبينما يعكس المكدس الترتيب، يحافظ الطابور عليه. ويجعل هذا السلوك الطابور الأنسب للمهام التي يجب تنفيذها بحسب أسبقية الوصول.
وتتضح قيمة المبدأ في المعالجة المتزامنة، حيث تتنافس عمليات كثيرة على مورد مشترك. فـ الطابعة مثلا تستقبل عشرات المستندات من مستخدمين مختلفين، وتطبعها بحسب ترتيب إرسالها. وكذلك تعالج الخوادم طلبات المستخدمين بالتتابع، ويمنع FIFO ظاهرة التجويع (Starvation) التي يتأخر فيها طلب بلا نهاية لأن طلبات أحدث تتجاوزه. وهذا ضمان للعدالة لا يتوفر في كل الهياكل.
ويجب التمييز بين FIFO كـمبدأ عام وبين الطابور كـهيكل. فكثير من الأنظمة تطبق FIFO في سياسات أخرى، مثل سياسة الإخلاء في الذاكرة المخبئية، حيث يزال العنصر الأقدم عند الامتلاء. وتستخدم أنظمة المحاسبة FIFO في تقييم المخزون. غير أن الطابور يظل الأداة الأوضح لتنفيذ هذا المبدأ في البرمجة، لأنه يفرضه بنيويا ولا يترك مجالا لتجاوزه بالخطأ.
العمليات الأساسية للطابور: Enqueue وDequeue وFront
تدور عمليات الطابور الأساسية حول ثلاث عمليات. عملية Enqueue تضيف عنصرا جديدا إلى الخلف، وعملية Dequeue تزيل العنصر الموجود في الأمام وتعيده، أما عملية Front (وتسمى Peek أحيانا) فتعيد العنصر الأمامي دون إزالته. وفي التنفيذ الجيد، تتم العمليات الثلاث بزمن ثابت $O(1)$. ويتطلب ذلك الاحتفاظ بـمؤشرين يتتبعان الطرفين، وإلا اضطر النظام إلى المرور على الطابور كله في كل عملية.
وتنشأ في الطابور حالتان حديتان كما في المكدس، هما الفيض السفلي عند محاولة Dequeue من طابور فارغ، و الفيض العلوي عند Enqueue في طابور ممتلئ ذي سعة ثابتة. كما يظهر عيب في التنفيذ البدائي بالمصفوفة، حيث تتحرك مؤشرات الأمام إلى الأمام باستمرار فتترك خانات فارغة غير مستغلة في البداية. وهذه المشكلة هي سبب ابتكار الطابور الدائري الذي سنشرحه تاليا. وفيما يلي ملخص العمليات:
- Enqueue: إضافة عنصر إلى الخلف، وتكلفتها ثابتة $O(1)$.
- Dequeue: إزالة العنصر الأمامي وإعادته، وتكلفتها ثابتة $O(1)$ مع التنفيذ الصحيح.
- Front: قراءة العنصر الأمامي دون إزالته.
- isEmpty: فحص ما إذا كان الطابور فارغا.
- isFull: فحص الامتلاء في الطوابير ذات السعة الثابتة.
الطابور الدائري (Circular Queue)
الطابور الدائري (Circular Queue) هو تحسين للطابور البسيط المبني على مصفوفة، ويعالج مشكلة هدر الخانات. ففي التنفيذ العادي تتحرك مؤشرات الأمام والخلف نحو النهاية ولا ترجع، فتبقى الخانات التي حرر منها العناصر غير قابلة لإعادة الاستخدام. أما في الطابور الدائري، فعندما يصل المؤشر إلى نهاية المصفوفة، يعود إلى بدايتها إذا كانت خالية، فتتحول المصفوفة منطقيا إلى حلقة مغلقة.
وتعتمد آلية الالتفاف على عملية الباقي (Modulo). فبدلا من زيادة المؤشر بواحد فقط، يحسب الموضع التالي بالمعادلة (index + 1) % capacity. وبهذا يعود المؤشر تلقائيا إلى الصفر عند بلوغ آخر خانة. ويتميز هذا التنفيذ بحجم ثابت واستهلاك ذاكرة متوقع، وبعمليات ثابتة الزمن. ويجب التفريق بين حالة الامتلاء وحالة الفراغ، لأن تساوي المؤشرين قد يعني أيا منهما، ويحل ذلك إما بعداد للعناصر أو بترك خانة فارغة دائما.
وتستخدم الطوابير الدائرية في تطبيقات حساسة للأداء والذاكرة. فـ المخازن الحلقية (Ring Buffers) تستخدم في معالجة الصوت والفيديو والإشارات وتعريفات الأجهزة، حيث تتدفق البيانات باستمرار وتحتاج إلى ذاكرة ثابتة دون تخصيص مستمر. وتستخدم كذلك في أنظمة السجلات التي تحتفظ بآخر $N$ حدثا فقط، وتكتب الجديد فوق الأقدم. ولهذا يعد الطابور الدائري خيارا مثاليا للأنظمة المدمجة والفورية.
طابور الأولوية (Priority Queue)
طابور الأولوية (Priority Queue) هو نوع مجرد يخالف قاعدة FIFO الصارمة، إذ يرتبط بكل عنصر قيمة أولوية، ويخرج العنصر الأعلى أولوية أولا، بغض النظر عن ترتيب دخوله. وإذا تساوت الأولويات، يمكن الرجوع إلى FIFO لفض التعادل. ويشبه ذلك غرفة الطوارئ في المستشفى، حيث تعالج الحالة الحرجة قبل الحالة البسيطة حتى لو وصلت متأخرة. وهذا السلوك ضروري في أنظمة تتفاوت فيها أهمية المهام.
وتنفذ طوابير الأولوية بطرق متعددة تختلف في الكفاءة. فـالتنفيذ بمصفوفة غير مرتبة يجعل الإدراج $O(1)$ والاستخراج $O(n)$، والتنفيذ بمصفوفة مرتبة يعكس المعادلة. أما التنفيذ الأمثل والأشهر فيعتمد على الكومة (Heap)، حيث تتم عمليتا الإدراج والاستخراج بزمن لوغاريتمي $O(\log n)$. ولهذا تستخدم أغلب اللغات الكومة داخليا، كوحدة heapq في Python وفئة PriorityQueue في Java.
وتعد طوابير الأولوية أساسا لخوارزميات مهمة وتطبيقات واسعة. فـ خوارزمية ديكسترا (Dijkstra) لإيجاد أقصر مسار تعتمد عليها لاختيار العقدة الأقرب في كل خطوة، وخوارزمية هوفمان (Huffman) للضغط تستخدمها لدمج الرموز الأقل تكرارا. كما تعتمد عليها أنظمة التشغيل في جدولة العمليات بحسب الأولوية، ومحاكاة الأحداث المتقطعة. وهكذا تتحول فكرة بسيطة إلى أداة قوية في الخوارزميات.
الطابور مزدوج النهاية (Deque)
الطابور مزدوج النهاية (Deque) وينطق “ديك” اختصارا لـ Double-Ended Queue، هو هيكل يسمح بالإضافة والإزالة من الطرفين معا. فهو يجمع خصائص المكدس والطابور في هيكل واحد، فإذا استخدمت طرفا واحدا للإضافة والإزالة عمل كمكدس، وإذا أضفت من طرف وأزلت من الآخر عمل كطابور. ولهذا يعد الهيكل الأكثر مرونة بين الهياكل الخطية المقيدة. ويوفر هذه المرونة بتكلفة ثابتة الزمن $O(1)$ لجميع عمليات الطرفين.
ويمكن تنفيذ Deque بقائمة مرتبطة ثنائية الاتجاه، حيث يتيح الرابطان الوصول إلى الطرفين بسهولة، أو بمصفوفة دائرية تتحرك فيها المؤشرات في الاتجاهين. وتوفر Python هذا الهيكل جاهزا عبر collections.deque, وتوفره Java عبر واجهة Deque والفئة ArrayDeque, وتوفره C++ عبر std::deque. وتعد هذه التنفيذات الخيار الأفضل لبناء المكدسات والطوابير في الإنتاج.
وتظهر Deque في مسائل عملية عدة. فمن أشهرها خوارزمية النافذة المنزلقة (Sliding Window) لإيجاد القيمة العظمى في كل نافذة، حيث يحتفظ Deque بالفهارس المرشحة بترتيب تنازلي. كما تستخدم في التحقق من المتناظرات (Palindromes) بمقارنة الطرفين، وفي خوارزمية سرقة العمل (Work Stealing) المستخدمة في جدولة الخيوط المتوازية. وبذلك يغطي هذا الهيكل مساحة واسعة من الاستخدامات.
استخدامات الطوابير في أنظمة التشغيل والشبكات ومعالجة المهام
تعتمد أنظمة التشغيل على الطوابير في إدارة العمليات. فـ طابور الجاهزية (Ready Queue) يحتفظ بالعمليات المنتظرة لحصتها من المعالج، و طابور الأجهزة (Device Queue) ينظم الطلبات الموجهة إلى القرص أو الطابعة. وتستخدم خوارزمية Round Robin طابورا دائريا لمنح كل عملية حصة زمنية متساوية. وبدون هذه الطوابير ستتصارع العمليات على الموارد بلا نظام مما يؤدي إلى الفوضى وضياع الأداء.
وفي الشبكات والاتصالات، تمر الحزم (Packets) عبر الموجهات (Routers) التي تخزنها في طوابير مؤقتة قبل إرسالها، ويحدد حجم الطابور وسياسته جودة الخدمة (QoS). وفي معالجة المهام الخلفية، تستخدم أنظمة مثل Celery و RabbitMQ و Kafka و Amazon SQS طوابير لتوزيع الأعمال بين عدة عمال، وتضمن عدم ضياع المهمة عند تعطل أحدهم. وتتعدد الاستخدامات كما يلي:
- جدولة العمليات: طابور الجاهزية وRound Robin في أنظمة التشغيل.
- الشبكات: تخزين الحزم مؤقتا في الموجهات وتنظيم إرسالها.
- طوابير المهام الخلفية: توزيع الأعمال الثقيلة على عمال متعددين.
- أنظمة الرسائل: نقل الأحداث بين الخدمات المصغرة (Microservices).
- البحث بالعرض (BFS): استكشاف الرسوم البيانية مستوى بعد مستوى.
الفرق بين المكدسات والطوابير
يشترك المكدس والطابور في كونهما هيكلين خطيين مقيدين، لكنهما يختلفان في ترتيب الخروج، وهذا الاختلاف يحدد مجال استخدام كل منهما. فالمكدس يعكس ترتيب الدخول ويناسب المشكلات المتداخلة والتراجع، بينما يحافظ الطابور على الترتيب ويناسب الخدمة العادلة والمعالجة التتابعية. وكلاهما يوفر عملياته الأساسية بزمن ثابت، ويمكن تنفيذ أحدهما بالآخر. ويوضح الجدول التالي الفروق:
| وجه المقارنة | المكدس (Stack) | الطابور (Queue) |
| المبدأ | آخر من يدخل أول من يخرج (LIFO) | أول من يدخل أول من يخرج (FIFO) |
| نقاط الوصول | طرف واحد هو القمة | طرفان، الأمام والخلف |
| عملية الإضافة | Push عند القمة | Enqueue عند الخلف |
| عملية الإزالة | Pop من القمة | Dequeue من الأمام |
| ترتيب الخروج | عكس ترتيب الدخول | نفس ترتيب الدخول |
| التكلفة | $O(1)$ لجميع العمليات | $O(1)$ لجميع العمليات مع التنفيذ الصحيح |
| أمثلة الاستخدام | التراجع واستدعاء الدوال وDFS | جدولة المهام والشبكات وBFS |
| مثال واقعي | كومة الصحون | طابور الانتظار في البنك |
مثال عملي على إنشاء طابور بلغة Python
يعرض المثال التالي تنفيذين للطابور. الأول مبني يدويا فوق قائمة مرتبطة لإظهار الفكرة، والثاني يستخدم collections.deque وheapq للتطبيق العملي السريع على الطابور العادي وطابور الأولوية.
from collections import deque
import heapq


class Node:
    def __init__(self, data):
        self.data = data
        self.next = None


class Queue:
    def __init__(self):
        self.front = None
        self.rear = None
        self._size = 0

    def enqueue(self, item):
        # الإضافة إلى الخلف: O(1)
        node = Node(item)
        if self.rear is None:
            self.front = self.rear = node
        else:
            self.rear.next = node
            self.rear = node
        self._size += 1

    def dequeue(self):
        # الإزالة من الأمام: O(1)
        if self.front is None:
            raise IndexError("الطابور فارغ")
        value = self.front.data
        self.front = self.front.next
        if self.front is None:
            self.rear = None
        self._size -= 1
        return value

    def peek(self):
        if self.front is None:
            raise IndexError("الطابور فارغ")
        return self.front.data

    def is_empty(self):
        return self.front is None

    def size(self):
        return self._size


q = Queue()
q.enqueue("A")
q.enqueue("B")
q.enqueue("C")
print(q.dequeue())   # A (أول من دخل أول من يخرج)
print(q.peek())      # B

# التنفيذ الجاهز بواسطة deque
tasks = deque()
tasks.append("مهمة 1")
tasks.append("مهمة 2")
print(tasks.popleft())   # مهمة 1

# طابور أولوية بواسطة heapq (الرقم الأصغر أعلى أولوية)
pq = []
heapq.heappush(pq, (2, "مهمة عادية"))
heapq.heappush(pq, (1, "مهمة عاجلة"))
heapq.heappush(pq, (3, "مهمة مؤجلة"))
print(heapq.heappop(pq))  # (1, 'مهمة عاجلة')
يبني الجزء الأول من الكود طابورا فوق قائمة مرتبطة بمؤشرين، front للأمام وrear للخلف. وتضيف دالة enqueue العقدة الجديدة بعد الذيل مباشرة، وتزيل دالة dequeue الرأس وتنقل المؤشر إلى التالي، وكلتاهما بزمن ثابت. وينبغي الانتباه إلى الحالة الحدية المهمة، وهي أن إزالة آخر عنصر تستلزم تصفير مؤشر الخلف أيضا، وإلا بقي يشير إلى عقدة محذوفة وتسبب في أخطاء خفية.
أما الجزء الثاني فيوضح الأدوات الجاهزة التي يفضلها المطورون في الإنتاج. فـdeque يوفر append وpopleft بزمن ثابت، وهو أفضل بكثير من استخدام list.pop(0) الذي يزيح جميع العناصر. وheapq يبني طابور أولوية فوق كومة صغرى، فيخرج العنصر ذو الرقم الأصغر أولا، كما يظهر في المثال حيث تتقدم المهمة العاجلة على غيرها رغم إضافتها بعد الأولى. ويمكن تغليف هذه الأدوات في فئة خاصة عند الحاجة إلى واجهة أنظف.
جداول التجزئة (Hash Tables) في هياكل البيانات
إذا كانت المصفوفة تصل إلى العنصر عبر رقمه، فإن جدول التجزئة (Hash Table) يصل إليه عبر اسمه أو مفتاحه، وبسرعة تقترب من سرعة المصفوفة نفسها. وهذه الفكرة تبدو سحرية لأول وهلة، فكيف يعرف الحاسوب مكان القيمة من مفتاح نصي دون بحث؟ والجواب أن جدول التجزئة يحول المفتاح إلى رقم عبر معادلة رياضية، ثم يستخدم هذا الرقم فهرسا داخل مصفوفة. ولهذا يعد من أهم الهياكل في البرمجة الحديثة، فهو القلب الذي يعمل داخل القواميس والذاكرة المخبئية وقواعد البيانات والمترجمات.
ما هي جداول التجزئة؟
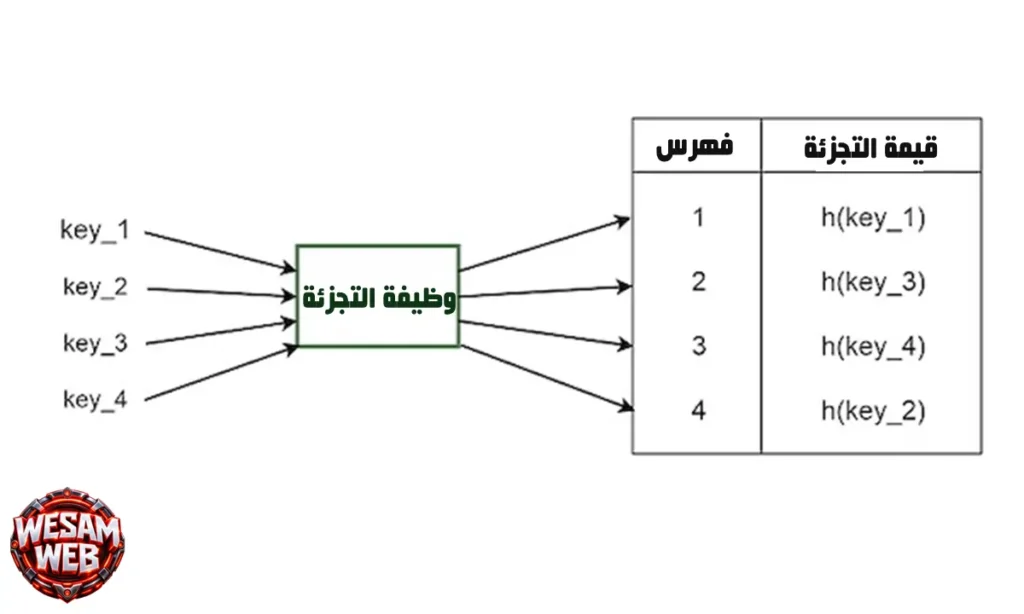
جدول التجزئة (Hash Table) هو هيكل بيانات يخزن أزواجا من المفاتيح (Keys) و القيم (Values)، ويحتوي على وصول إلى القيمة عبر مفتاحها بزمن متوسط ثابت O(1)O(1)O(1). ويتكون الجدول داخليا من مصفوفة تسمى الحاويات (Buckets)، تمثل كل حاوية موضعا محتملا لـزوج أو أكثر. وعندما تضيف زوجا جديدا، يحسب النظام موضعه من المفتاح مباشرة، ثم يضعه هناك. وعند البحث، يعيد حساب الموضع نفسه ويقرأ القيمة فورا، دون المرور على باقي العناصر.
وتتجلى قوة هذا الهيكل عند مقارنته بالبدائل. فالبحث في قائمة غير مرتبة عن مفتاح يتطلب المرور على العناصر واحدا بعد الآخر بتكلفة خطية O(n)O(n)O(n)، والبحث في شجرة متوازنة يتطلب تكلفة لوغاريتمية O(logn)O(\log n)O(logn). أما جدول التجزئة فيصل في المتوسط إلى القيمة بخطوة واحدة تقريبا، وهو فارق هائل عند التعامل مع ملايين السجلات. ولذلك يلجأ إليه المبرمجون كلما كان البحث بالمفتاح هو العملية الأكثر تكرارا.
غير أن هذه السرعة مشروطة بـ جودة التصميم، ولا تعد مضمونة في كل الأحوال. فالتكلفة الثابتة هي المتوسط المتوقع، لكنها قد تتدهور إلى خطية O(n)O(n)O(n) في أسوأ الحالات إذا تجمعت عناصر كثيرة في حاوية واحدة. وتتحكم ثلاثة عوامل في الأداء، هي دالة التجزئة المستخدمة، وطريقة معالجة التصادم، ونسبة امتلاء الجدول. وسنفصل كل عامل في الأقسام التالية.
كيف تعمل دالة التجزئة (Hash Function)؟
دالة التجزئة (Hash Function) هي القلب النابض لجدول التجزئة، وهي دالة رياضية تحول أي مفتاح، سواء كان نصا أو رقما أو كائنا، إلى عدد صحيح ثابت الحجم يسمى قيمة التجزئة (Hash Value). ثم يحول هذا العدد إلى فهرس صالح ضمن حدود الجدول عادة بعملية الباقي (Modulo)، أي الفهرس يساوي قيمة التجزئة مقسومة على سعة الجدول والباقي هو الموضع. وبهذا يتحول أي مفتاح مهما كان نوعه إلى موضع محدد في المصفوفة الداخلية.
ولكي تكون دالة التجزئة جيدة، يجب أن تحقق عدة خصائص أساسية:
- الحتمية (Determinism): المفتاح نفسه يجب أن ينتج القيمة نفسها دائما، وإلا ضاع الوصول إلى العنصر.
- التوزيع المنتظم (Uniform Distribution): بحيث تتوزع المفاتيح على جميع الحاويات بالتساوي تقريبا.
- السرعة: الدالة تنفذ في كل عملية، وإذا كانت بطيئة فقدت ميزة الهيكل.
- التأثير الانهياري (Avalanche Effect): حيث يغير تعديل صغير في المفتاح ناتج التجزئة تغييرا كبيرا.
وتختلف دوال التجزئة المستخدمة في جداول البيانات عن دوال التجزئة التشفيرية مثل SHA-256. فالأولى تركز على السرعة والتوزيع ولا تهتم بالأمان، ومن أمثلتها MurmurHash و SipHash المستخدمة في Python. أما الثانية فتصمم لتكون غير قابلة للعكس ومقاومة للتصادم المتعمد، وتستخدم في التوقيعات الرقمية وكلمات المرور. ويحدث الخلط بينهما كثيرا، لذلك ينبغي اختيار الدالة بحسب الغرض.
ما هو التصادم (Collision) في جداول التجزئة؟
التصادم (Collision) هو الحالة التي تنتج فيها دالة التجزئة الفهرس نفسه لمفتاحين مختلفين، فيتنافسان على الحاوية الواحدة. وهو أمر حتمي رياضيا لا يمكن تجنبه بالكامل، لأن عدد المفاتيح الممكنة أكبر بكثير من عدد الحاويات المتاحة. ويوضح ذلك مبدأ عش الحمام (Pigeonhole Principle)، فإذا وضعت عشر حمامات في تسعة أعشاش، فلا بد أن يضم عش واحد على الأقل حمامتين. وتزداد احتمالات التصادم مع امتلاء الجدول.
وتشير مفارقة عيد الميلاد (Birthday Paradox) إلى أن التصادم يحدث أبكر مما يتوقع الحدس. فبين 23 شخصا فقط تزيد احتمالية اشتراك اثنين في يوم الميلاد عن 50%، رغم وجود 365 يوما. وبالطريقة نفسها، يظهر أول تصادم في جدول تجزئة قبل أن يمتلئ بوقت طويل. ولهذا يجب تصميم الجدول على أساس أن التصادم سيقع فعلا، وأن المسألة هي كيفية معالجته بكفاءة.
ويؤثر التصادم مباشرة في الأداء. فإذا اجتمعت مفاتيح كثيرة في حاوية واحدة، اضطر النظام إلى فحصها جميعا بحثا عن المفتاح المطلوب، فتنهار التكلفة من الثابتة إلى الخطية. وقد يستغل المهاجمون هذه النقطة فيما يسمى هجمات التصادم (Hash Flooding)، إذ يرسلون مفاتيح مصممة عمدا لتتصادم فتتعطل الخوادم. ولهذا تستخدم لغات حديثة دوال عشوائية البذرة مثل SipHash.
طرق معالجة التصادم: التسلسل المنفصل والعنونة المفتوحة
تعتمد معظم جداول التجزئة على طريقتين رئيسيتين لمعالجة التصادم:
- التسلسل المنفصل (Separate Chaining): تحتفظ كل حاوية بقائمة مرتبطة أو مصفوفة صغيرة تضم جميع المفاتيح التي تجزأت إلى موضعها. فعند حدوث تصادم، يضاف الزوج الجديد إلى قائمة الحاوية ببساطة. وعند البحث، يحسب النظام الفهرس ثم يمر على قائمة الحاوية القصيرة فقط. وتتميز هذه الطريقة بالبساطة وبقدرتها على تحمل امتلاء يتجاوز السعة.
- العنونة المفتوحة (Open Addressing): تخزن جميع العناصر داخل المصفوفة نفسها دون قوائم خارجية. فإذا كانت الحاوية المطلوبة مشغولة، يبحث النظام عن حاوية أخرى فارغة وفق نمط محدد يسمى التحري (Probing). ومن أنماطه التحري الخطي (Linear Probing) الذي يجرب الخانة التالية ثم التي بعدها، و التحري التربيعي (Quadratic Probing) الذي يزيد الخطوة تربيعيا، و التجزئة المزدوجة (Double Hashing) التي تستخدم دالة ثانية لتحديد الخطوة. وتتفوق هذه الطريقة في الاستفادة من الذاكرة المخبئية.
وتختلف الطريقتان في المفاضلة. فالتسلسل المنفصل يستهلك ذاكرة إضافية للمؤشرات لكنه أسهل في الحذف وأقل حساسية لارتفاع نسبة الامتلاء. أما العنونة المفتوحة فتوفر الذاكرة وتتميز بسرعة عملية بفضل التجاور، لكنها تعاني من ظاهرة التكتل (Clustering) حيث تتجمع العناصر في كتل متصلة تبطئ البحث، وتحتاج إلى علامات خاصة للحذف تسمى شواهد القبور (Tombstones). وتستخدم Java التسلسل في HashMap، بينما تعتمد Python العنونة المفتوحة في القواميس.
عوامل التحميل (Load Factor) وإعادة بناء الجدول (Rehashing)
عامل التحميل (Load Factor) هو نسبة عدد العناصر المخزنة إلى عدد الحاويات الكلي، ويعبر عن مدى امتلاء الجدول. فإذا كان الجدول يضم سبعة عناصر في عشر حاويات، فعامل التحميل يساوي 0.7. وكلما ارتفع هذا العامل، زادت احتمالات التصادم وتباطأت العمليات. ولذلك تحدد كل لغة حدا أقصى له، ففي Java تبلغ القيمة الافتراضية 0.75، وفي Python يقارب الحد ثلثين تقريبا، وعند تجاوزه يبدأ الجدول بالتوسع.
وتسمى عملية التوسع إعادة التجزئة (Rehashing)، وفيها يحجز النظام مصفوفة أكبر عادة بضعف السعة السابقة، ثم يعيد حساب موضع كل عنصر بالمعادلة الجديدة وينقله إليها. ولا يمكن نسخ العناصر كما هي، لأن الفهرس يعتمد على السعة التي تغيرت. وتتكلف العملية الواحدة زمنا خطيا O(n)O(n)O(n)، لكنها نادرة الحدوث، ولذلك تبقى التكلفة المطفأة لعملية الإدراج ثابتة تقريبا O(1)O(1)O(1).
ويتطلب اختيار عامل التحميل موازنة بين الذاكرة والسرعة. فعامل منخفض يقلل التصادم لكنه يهدر مساحة كبيرة، وعامل مرتفع يوفر الذاكرة لكنه يبطئ العمليات. ويفيد ضبط السعة الابتدائية عند معرفة العدد التقريبي للعناصر، فإنشاء الجدول بالحجم المناسب من البداية يتجنب عمليات إعادة التجزئة المتكررة. ويعد هذا من أبسط التحسينات العملية وأكثرها أثرا في التطبيقات التي تعالج بيانات ضخمة.
مزايا جداول التجزئة وعيوبها
تتميز جداول التجزئة بسرعة استثنائية في الإدراج والبحث والحذف، إذ تنفذ جميعها بزمن متوسط ثابت O(1)O(1)O(1)، وهي مناسبة جدا لتخزين البيانات المعرفة بمفاتيح فريدة. لكنها في المقابل لا تحتفظ بترتيب العناصر بحسب المفتاح، ولا تدعم بشكل مباشر الاستعلامات على النطاقات مثل إيجاد كل المفاتيح بين قيمتين. كما تستهلك ذاكرة أكبر من المصفوفة بسبب الحاويات الفارغة، وقد تتدهور إلى O(n)O(n)O(n) عند سوء اختيار الدالة أو كثرة التصادم، وتتطلب إعادة تجزئة مكلفة عند النمو. ويمكن تلخيص المزايا والعيوب فيما يلي:
- من المزايا: بحث وإدراج وحذف سريعة بزمن متوسط ثابت، ومرونة في أنواع المفاتيح، وبساطة الاستخدام عبر القواميس الجاهزة.
- من العيوب: غياب الترتيب، وضعف الاستعلام على النطاقات، واستهلاك ذاكرة إضافي، واحتمال التدهور عند التصادم الكثيف.
استخدامات جداول التجزئة في البحث السريع والتخزين المؤقت
تظهر جداول التجزئة في أنظمة كثيرة تعتمد على البحث السريع بالمفتاح. فالقواميس في Python وكائنات JavaScript وHashMap في Java كلها تطبيقات لها. وتستخدم المترجمات ما يسمى جدول الرموز (Symbol Table) لتخزين أسماء المتغيرات والدوال وخصائصها. وتعتمد قواعد البيانات على فهارس التجزئة (Hash Indexes) للبحث بالمساواة. كما تستخدم في عد التكرارات وإيجاد العناصر المكررة وحل مسائل المقابلات التقنية الشهيرة مثل مجموع عددين.
وفي التخزين المؤقت (Caching)، تعد جداول التجزئة الأساس الذي تبنى عليه الأنظمة مثل Redis وMemcached، حيث يخزن ناتج العملية المكلفة مع مفتاحها للرجوع إليه سريعا لاحقا. وتستخدم تقنية الحفظ المؤقت للنتائج (Memoization) في الخوارزميات لتفادي إعادة الحساب. وتتعدد الاستخدامات كما يلي:
- القواميس والخرائط: تخزين أزواج مفتاح وقيمة في كل لغات البرمجة تقريبا.
- التخزين المؤقت: حفظ نتائج الاستعلامات والصفحات لتسريع الاستجابة.
- المترجمات: جداول الرموز لتتبع المتغيرات والدوال.
- فهارس قواعد البيانات: البحث بالمساواة في زمن شبه ثابت.
- كشف التكرار: اكتشاف العناصر المتكررة وعدها بكفاءة.
مثال عملي على استخدام القواميس في Python بوصفها تطبيقا لجداول التجزئة
يعرض المثال التالي أولا تنفيذا مبسطا لجدول تجزئة بالتسلسل المنفصل لتوضيح الآلية الداخلية، ثم الاستخدام العملي للقاموس المدمج في Python في عد تكرار الكلمات:
class HashTable:
    def __init__(self, capacity=8):
        self.capacity = capacity
        self.size = 0
        self.buckets = [[] for _ in range(capacity)]

    def _index(self, key):
        return hash(key) % self.capacity

    def put(self, key, value):
        bucket = self.buckets[self._index(key)]
        for i, (k, v) in enumerate(bucket):
            if k == key:
                bucket[i] = (key, value)   # تحديث قيمة موجودة
                return
        bucket.append((key, value))        # إضافة زوج جديد
        self.size += 1
        if self.size / self.capacity > 0.75:
            self._rehash()

    def get(self, key, default=None):
        for k, v in self.buckets[self._index(key)]:
            if k == key:
                return v
        return default

    def remove(self, key):
        bucket = self.buckets[self._index(key)]
        for i, (k, v) in enumerate(bucket):
            if k == key:
                del bucket[i]
                self.size -= 1
                return True
        return False

    def _rehash(self):
        old = self.buckets
        self.capacity *= 2
        self.buckets = [[] for _ in range(self.capacity)]
        self.size = 0
        for bucket in old:
            for k, v in bucket:
                self.put(k, v)


table = HashTable()
table.put("python", 1991)
table.put("java", 1995)
print(table.get("python"))   # 1991

# القاموس المدمج في Python
text = "data structures make data fast"
counts = {}
for word in text.split():
    counts[word] = counts.get(word, 0) + 1
print(counts)   # {'data': 2, 'structures': 1, 'make': 1, 'fast': 1}
يحسب الكود الفهرس بدالة hash المدمجة ثم عملية الباقي، ويخزن كل حاوية قائمة من الأزواج لمعالجة التصادم بالتسلسل. وتحدث دالة put الزوج إذا كان المفتاح موجودا، وإلا أضافته ثم فحصت عامل التحميل، فإذا تجاوز 0.75 استدعت _rehash التي تضاعف السعة وتعيد توزيع كل العناصر. وتتم العمليات جميعها بزمن متوسط ثابت ما دامت الحاويات قصيرة.
أما الجزء الأخير من المثال فيوضح كيف يختصر القاموس المدمج كل هذا العمل. فهو يعد تكرار الكلمات بحلقة واحدة، ويستخدم get بقيمة افتراضية صفر لتفادي الخطأ عند غياب المفتاح. وينبغي التذكر أن المفاتيح في Python يجب أن تكون قابلة للتجزئة (Hashable).(Hashable) أي غير قابلة للتغيير مثل النصوص والأرقام والصفوف (Tuples)، ولا تصلح القوائم مفاتيح. وتحافظ القواميس منذ Python 3.7 على ترتيب الإدراج، وهي ميزة إضافية لا تتوفر في كل اللغات.
هياكل البيانات: المجموعات والقواميس (Sets & Maps)
تقوم المجموعات والقواميس على فكرة جداول التجزئة (Hash Tables)، لكنها تقدمها للمبرمج في صورة أبسط وأقرب إلى الاستخدام اليومي. فبدلا من التعامل مع الحاويات والتصادم، تتعامل مع مفاهيم مألوفة مثل العضوية و التفرد و البحث بالاسم. وهذه الهياكل هي الأكثر استخداما في الشيفرة الحقيقية بعد القوائم، فلا يكاد يخلو برنامج من قاموس أو مجموعة. وفهم الفرق بينها يوفر على المبرمج كثيرا من الوقت والأخطاء.
ما هي المجموعات (Sets) في البرمجة؟
المجموعة (Set) هي هيكل بيانات يخزن عناصر فريدة غير مكررة دون ترتيب محدد. فإذا حاولت إضافة عنصر موجود مسبقا، تتجاهل المجموعة العملية ولا يتغير محتواها. وهي تحاكي المجموعات الرياضية في علم الرياضيات، ولذلك تدعم العمليات المعروفة عليها مثل الاتحاد (Union) و التقاطع (Intersection) و الفرق (Difference) و الفرق المتناظر (Symmetric Difference). وتنفذ غالبا فوق جدول تجزئة يحتفظ بالمفاتيح فقط دون قيم.
وتتميز المجموعة بسرعة التحقق من العضوية (Membership Test)، أي معرفة هل العنصر موجود أم لا، وهي عملية تنفذ بزمن متوسط ثابت O(1)O(1)O(1) مقارنة بالزمن الخطي O(n)O(n)O(n) في القائمة. وهذا الفرق يتضخم مع زيادة الحجم، فالبحث عن عنصر في قائمة تضم مليون عنصر قد يتطلب مليون مقارنة، بينما يتطلب في المجموعة مقارنة واحدة تقريبا. ولذلك يحول المحترفون القوائم الكبيرة إلى مجموعات عندما يكثر البحث فيها.
وللمجموعات قيود ينبغي معرفتها. فهي لا تحافظ على ترتيب العناصر في أغلب التنفيذات، ولا تدعم الوصول بالفهرس، ويجب أن تكون عناصرها قابلة للتجزئة. وتوجد أنواع مرتبة منها مثل TreeSet في Java تبنى فوق شجرة متوازنة وتحفظ الترتيب بتكلفة لوغاريتمية O(logn)O(\log n)O(logn)، وأنواع تحفظ ترتيب الإدراج مثل LinkedHashSet. ويعتمد الاختيار بينها على حاجة التطبيق إلى الترتيب أو السرعة.
ما هي الخرائط والقواميس (Maps and Dictionaries)؟
الخريطة (Map) أو القاموس (Dictionary) هي هيكل بيانات يربط كل مفتاح فريد بقيمة محددة، ويتيح استرجاع القيمة بمجرد معرفة مفتاحها. وتختلف التسمية بحسب اللغة، فهي dict في Python، و HashMap في Java، و unordered_map في C++، و Object أو Map في JavaScript. وتشبه القاموس الورقي حيث تبحث عن الكلمة فتجد معناها مباشرة، دون قراءة كل الصفحات بالترتيب.
وتحافظ الخريطة على قاعدة جوهرية هي تفرد المفاتيح. فإذا أضفت مفتاحا موجودا بقيمة جديدة، حلت القيمة الجديدة محل القديمة. أما القيم فيمكن أن تتكرر دون قيد، ويمكن أن تكون من أي نوع حتى قوائم أو قواميس أخرى، مما يتيح بناء هياكل متداخلة معقدة مثل ملفات JSON. وتنفذ الخرائط عادة فوق جداول التجزئة، أو فوق الأشجار المتوازنة عندما يلزم الترتيب بحسب المفتاح.
وتستخدم القواميس في نمذجة السجلات والكائنات والإعدادات. فبيانات المستخدم مثلا تخزن في قاموس مفاتيحه الاسم والبريد والعمر. وتستخدم كذلك في العد والتجميع وبناء الفهارس المعكوسة (Inverted Index) في محركات البحث. ويعد إتقانها من أهم المهارات العملية، فهي الأداة التي يلجأ إليها المبرمج أولا كلما احتاج إلى ربط شيء بشيء آخر.
الفرق بين المجموعات والقواميس والمصفوفات
يوضح الجدول التالي الفروق العملية بين الهياكل الثلاثة، وهو مرجع سريع عند اتخاذ قرار التخزين. ويلاحظ أن المجموعة والقاموس يتشاركان الأساس التجزئي، بينما تختلف المصفوفة في فلسفتها القائمة على الترتيب والفهرس:
| وجه المقارنة | المصفوفة (Array) | المجموعة (Set) | القاموس (Map) |
|---|---|---|---|
| ما يخزنه | عناصر مرتبة بالفهرس | عناصر فريدة | أزواج مفتاح وقيمة |
| التكرار | مسموح | ممنوع | المفاتيح فريدة والقيم قد تتكرر |
| الترتيب | محفوظ بالفهرس | غير محفوظ غالبا | غير محفوظ غالبا أو بحسب الإدراج |
| الوصول | بالفهرس O(1) | لا يوجد وصول مباشر | بالمفتاح O(1) متوسطا |
| اختبار الوجود | O(n) | O(1) متوسطا | O(1) متوسطا للمفتاح |
| البنية الداخلية | كتلة متصلة | جدول تجزئة للمفاتيح | جدول تجزئة للأزواج |
| أفضل استخدام | تسلسلات مرتبة ووصول بالموضع | إزالة التكرار والعضوية | الربط والبحث بالاسم والعد |
كيف تساعد المجموعات في إزالة العناصر المكررة والتحقق من العضوية؟
تعد إزالة التكرار من أشهر استخدامات المجموعات. فبدلا من كتابة حلقة متداخلة تقارن كل عنصر بكل ما قبله بتكلفة تربيعية O(n2)O(n^2)O(n2)، يكفي تحويل القائمة إلى مجموعة بسطر واحد، فتتخلص تلقائيا من المكررات بتكلفة خطية O(n)O(n)O(n). وتعمل الآلية لأن المجموعة تتجاهل أي عنصر موجود مسبقا عند الإضافة. ويفيد ذلك في تنظيف البيانات وإحصاء القيم المختلفة ومعالجة سجلات المستخدمين.
أما التحقق من العضوية فهو الميزة الثانية الكبرى. فعندما تريد معرفة هل اسم المستخدم محجوز أو هل عنوان IP مدرج في القائمة السوداء، تكون المجموعة هي الخيار الأمثل بفضل زمن البحث الثابت. وتتعاظم الفائدة في الأنظمة التي تفحص ملايين الطلبات، حيث يمثل كل جزء من الثانية فارقا. ولهذا تستخدم المجموعات في المرشحات الأمنية وأنظمة منع التكرار في الرسائل.
وتفيد عمليات المجموعات الرياضية في حل مسائل المقارنة بين قوائم. فـ التقاطع يعطي العناصر المشتركة بين قائمتين، كالأصدقاء المشتركين بين مستخدمين، و الاتحاد يجمع العناصر من المصدرين دون تكرار، و الفرق يكشف ما وجد في الأولى ولم يوجد في الثانية، كالملفات المضافة بين نسختين من مشروع. وتنفذ هذه العمليات بكفاءة عالية لأنها تعتمد على البحث الثابت داخل كل مجموعة.
متى نستخدم المجموعات والقواميس؟
تستخدم المجموعة عندما يهمك وجود العنصر وليس موضعه. فإذا كنت تريد إزالة التكرار أو اختبار الوجود بسرعة أو إجراء عمليات الاتحاد والتقاطع، فهي الأنسب. أما القاموس فيستخدم عندما تريد ربط قيمة بمفتاح والوصول إليها بسرعة، كالبحث عن سعر منتج من اسمه أو عد تكرار الكلمات أو تخزين إعدادات التطبيق. ويحل كلاهما مشكلات كانت تحتاج إلى حلقات بحث مكلفة في القوائم، فيجعلان الشيفرة أقصر وأسرع وأوضح.
وفي المقابل، لا تناسب هذه الهياكل كل الحالات. فإذا كان الترتيب مهما أو احتجت إلى الوصول بالفهرس أو قبول التكرار، فالقائمة أو المصفوفة أنسب. وإذا كانت عناصرك غير قابلة للتجزئة كالقوائم، فلا يمكن وضعها في مجموعة أو كمفاتيح قاموس مباشرة. كما أن الذاكرة المستهلكة أكبر من القوائم، فلا تلجأ إليها عند تخزين ملايين القيم البسيطة إلا إذا كانت السرعة أولوية. ويلخص ما يلي القاعدة:
- استخدم المجموعة عند: إزالة التكرار، أو اختبار الوجود المتكرر، أو مقارنة قوائم بالتقاطع والفرق.
- استخدم القاموس عند: الربط بين مفتاح وقيمة، أو العد والتجميع، أو بناء فهارس البحث.
- تجنبهما عند: الحاجة إلى الترتيب بالفهرس، أو قبول التكرار، أو ضيق الذاكرة الشديد.
أمثلة عملية على المجموعات والقواميس في Python
يجمع المثال التالي أبرز الاستخدامات العملية للمجموعات والقواميس في لغة Python، ويشمل إزالة التكرار وعمليات المجموعات وبناء قاموس وتجميع البيانات:
# إزالة التكرار
numbers = [3, 1, 2, 3, 2, 1, 5]
unique = set(numbers)
print(unique)                 # {1, 2, 3, 5}

# اختبار العضوية بزمن ثابت متوسط
blocked = {"10.0.0.1", "10.0.0.7"}
print("10.0.0.7" in blocked)  # True

# عمليات المجموعات
a = {1, 2, 3, 4}
b = {3, 4, 5}
print(a | b)    # الاتحاد {1, 2, 3, 4, 5}
print(a & b)    # التقاطع {3, 4}
print(a - b)    # الفرق {1, 2}

# القاموس: الربط بين مفتاح وقيمة
student = {"name": "Sara", "age": 21, "major": "CS"}
student["gpa"] = 3.8
print(student.get("age"))               # 21
print(student.get("phone", "غير متوفر"))  # قيمة افتراضية

# التجميع باستخدام قاموس من القوائم
orders = [("Ali", 50), ("Sara", 30), ("Ali", 20)]
totals = {}
for name, amount in orders:
    totals[name] = totals.get(name, 0) + amount
print(totals)   # {'Ali': 70, 'Sara': 30}

# مسألة شهيرة: مجموع عددين باستخدام قاموس
def two_sum(nums, target):
    seen = {}
    for i, n in enumerate(nums):
        if target - n in seen:
            return seen[target - n], i
        seen[n] = i
    return None

print(two_sum([2, 7, 11, 15], 9))   # (0, 1)
يبدأ الكود بتحويل قائمة مكررة إلى مجموعة فتختفي التكرارات فورا، ثم يبين سرعة اختبار العضوية في قائمة سوداء لعناوين IP. وبعدها يطبق عمليات الاتحاد والتقاطع والفرق بالرموز المختصرة | و & و -. ويلاحظ أن ترتيب عناصر المجموعة عند الطباعة قد يختلف عما كتب هنا، لأن المجموعة لا تضمن ترتيبا معينا، وهذه نقطة مهمة يجب ألا يبني عليها المبرمج منطق برنامجه.
ويتابع المثال باستخدام القاموس في ثلاث صور: الأولى تخزين سجل طالب وقراءة حقوله بالدالة get مع قيمة افتراضية تمنع الخطأ، والثانية تجميع مبالغ الطلبات حسب اسم العميل، والثالثة مسألة مجموع عددين الشهيرة التي تحل بتكلفة خطية O(n)O(n)O(n) بدلا من التربيعية O(n2)O(n^2)O(n2)، إذ يحتفظ القاموس بما مر من أعداد ومواضعها ويبحث عن المكمل بزمن ثابت O(1)O(1)O(1). وهذا النمط من استبدال الحلقة الداخلية ببحث في قاموس هو من أكثر الحيل تكرارا في الخوارزميات. صور. الأولى تخزين سجل طالب وقراءة حقوله بالدالة get مع قيمة افتراضية تمنع الخطأ. الثانية تجميع مبالغ الطلبات حسب اسم العميل. والثالثة مسألة مجموع عددين الشهيرة، التي تحل بتكلفة خطية O(n) بدلا من التربيعية O(n²)، إذ يحتفظ القاموس بما مر من أعداد ومواضعها ويبحث عن المكمل بزمن ثابت. وهذا النمط من استبدال الحلقة الداخلية ببحث في قاموس هو من أكثر الحيل تكرارا في الخوارزميات.
هياكل البيانات الشجرية (Tree Data Structures)
حين نبتعد عن الهياكل الخطية، نجد أن العالم الحقيقي لا يرتب معلوماته في صف واحد. فـ المجلدات تحتوي مجلدات فرعية، و الهيكل الإداري للشركة يتفرع من المدير العام، و العبارة البرمجية تتكون من تعبيرات داخل تعبيرات. وهذه العلاقات الهرمية هي المجال الطبيعي لـ الأشجار (Trees)، وهي من أقوى الهياكل غير الخطية وأوسعها استخداما. وتجمع الشجرة بين مرونة القوائم المرتبطة وسرعة البحث في المصفوفات المرتبة، فتحقق البحث والإدراج والحذف بزمن لوغاريتمي $O(\log n)$ عندما تكون متوازنة. ولهذا تقف الأشجار خلف أنظمة الملفات وقواعد البيانات ومحركات البحث والمترجمات.
ما هي هياكل البيانات الشجرية؟
الشجرة (Tree) هي هيكل بيانات هرمي يتكون من مجموعة عقد (Nodes) ترتبط ببعضها عبر حواف (Edges)، بحيث توجد عقدة واحدة في القمة تسمى الجذر (Root)، ويتفرع منها عقد أبناء (Children)، ويتفرع من كل ابن أبناء آخرون وهكذا. ويشترط في الشجرة أن تخلو من الدورات (Cycles)، أي أن المسار بين أي عقدتين فريد وواحد. وبهذا الشرط تختلف الشجرة عن الرسم البياني العام (Graph) الذي يسمح بـدورات وروابط حرة. ويمكن تعريف الشجرة تعريفا عودياً أيضا، فهي جذر مرتبط بـ مجموعة أشجار فرعية (Subtrees) كل منها شجرة كاملة بحد ذاتها.
وتنبع قوة الشجرة من قدرتها على تقسيم المشكلة إلى أجزاء أصغر في كل خطوة. فعندما تبحث عن قيمة في شجرة بحث مرتبة، تستبعد نصف العناصر تقريبا بمقارنة واحدة مع الجذر، ثم نصف الباقي بمقارنة ثانية، وهكذا. وبهذه الطريقة يمكن البحث بين مليون عنصر في نحو عشرين خطوة فقط. وتشبه هذه الفكرة البحث الثنائي على المصفوفة، لكن الشجرة تضيف ميزة أساسية، وهي سهولة الإدراج والحذف دون إزاحة كتلة من العناصر.
وتتعدد أنواع الأشجار بحسب القيود المفروضة على عدد الأبناء وترتيب القيم وشروط التوازن. فهناك الأشجار العامة التي يملك فيها كل عقدة عددا غير محدد من الأبناء، و الأشجار الثنائية التي يقتصر فيها العدد على اثنين، و أشجار البحث التي ترتب القيم لتسريع الوصول، و الأشجار المتوازنة التي تحافظ على ارتفاع صغير. وسنستعرض هذه الأنواع تباعا، بدءا من مكونات الشجرة الأساسية التي يشترك فيها الجميع.
مكونات الشجرة: الجذر والعقد والأبناء والأوراق والمستويات والارتفاع
تتكون كل شجرة من مجموعة مصطلحات ثابتة يجب حفظها قبل الخوض في تفاصيل الأنواع:
| المكون | التعريف | مثال |
| الجذر (Root) | العقدة العليا التي لا أب لها | مجلد الجذر في نظام الملفات |
| العقدة (Node) | وحدة تحمل قيمة وروابط للأبناء | ملف أو مجلد |
| الأب (Parent) | العقدة التي تقع مباشرة فوق عقدة أخرى | المجلد الحاوي لملف |
| الابن (Child) | العقدة التي تقع مباشرة تحت عقدة أخرى | الملفات داخل مجلد |
| الأخوة (Siblings) | عقد تشترك في الأب نفسه | ملفات المجلد الواحد |
| الورقة (Leaf) | عقدة بلا أبناء | ملف غير مجلد |
| الحافة (Edge) | الرابط بين أب وابن | علاقة الاحتواء |
| المستوى (Level) | عدد العقد على المسار من الجذر إلى العقدة | الجذر في المستوى الأول |
| الارتفاع (Height) | عدد الحواف في أطول مسار من الجذر إلى ورقة | أعمق مستوى في الشجرة |
| الشجرة الفرعية (Subtree) | عقدة مع كل نسلها | مجلد مع محتوياته |
الشجرة الثنائية (Binary Tree)
الشجرة الثنائية (Binary Tree) هي شجرة يملك فيها كل عقدة ابنين على الأكثر، يسميان الابن الأيسر (Left Child) و الابن الأيمن (Right Child). وهذا القيد البسيط يجعلها أسهل تنفيذا وتحليلا من الأشجار العامة، إذ تحتاج كل عقدة إلى مؤشرين فقط. وتبنى عليها أغلب الأشجار المتخصصة مثل أشجار البحث والكومات وأشجار التعبيرات. ويمكن تخزينها بعقد ومؤشرات، أو داخل مصفوفة حيث يقع ابنا العقدة ذات الفهرس $i$ عند الموضعين $2i+1$ و $2i+2$.
وتصنف الأشجار الثنائية بحسب شكلها. فـ الشجرة الثنائية الكاملة (Full) هي التي لكل عقدة فيها صفر أو اثنان من الأبناء، و الشجرة المكتملة (Complete) هي التي تمتلئ مستوياتها كلها عدا الأخير الذي يمتلئ من اليسار، و الشجرة المثالية (Perfect) هي التي تمتلئ جميع مستوياتها تماما. أما الشجرة المنحلة (Degenerate) فهي التي لكل عقدة فيها ابن واحد، فتتحول عمليا إلى قائمة مرتبطة وتفقد ميزة اللوغاريتم.
ويرتبط ارتفاع الشجرة الثنائية ارتباطا مباشرا بأدائها. فالشجرة المثالية التي تضم $n$ عقدة يبلغ ارتفاعها نحو $\log_2(n)$، بينما يصل ارتفاع الشجرة المنحلة إلى $n$. وهذا الفارق هو ما يفسر أهمية الحفاظ على توازن الشجرة، وهو الموضوع الذي تعالجه أشجار AVL وRed-Black لاحقا. كما تستخدم الأشجار الثنائية في تمثيل التعبيرات الحسابية، حيث تمثل العمليات عقدا داخلية والأعداد أوراقا.
شجرة البحث الثنائية (Binary Search Tree – BST)
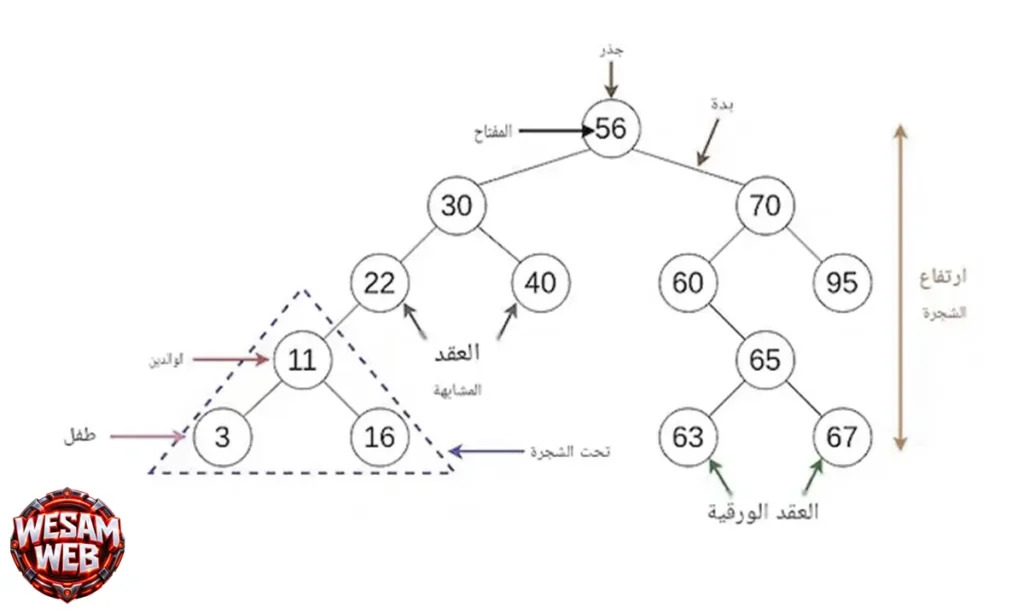
شجرة البحث الثنائية (BST) هي شجرة ثنائية تلتزم بقاعدة ترتيب صارمة، وهي أن كل القيم في الشجرة الفرعية اليسرى لأي عقدة أصغر من قيمة العقدة، وكل القيم في الشجرة الفرعية اليمنى أكبر منها. وتطبق هذه القاعدة على كل عقدة في الشجرة وليس على الجذر وحده. وتمنح هذه الخاصية الهيكل قدرة على البحث السريع، إذ تحدد المقارنة مع أي عقدة الاتجاه الصحيح للمتابعة يمينا أو يسارا.
وتتفوق شجرة البحث الثنائية على المصفوفة المرتبة في الإدراج والحذف، لأنهما لا يتطلبان إزاحة العناصر، بل مجرد تعديل بعض المؤشرات. وتتفوق على جدول التجزئة في أنها تحتفظ بالترتيب، فيمكنها إيجاد أصغر عنصر وأكبر عنصر والعنصر التالي والسابق والعناصر ضمن نطاق محدد، وهي عمليات لا يدعمها جدول التجزئة بكفاءة. ويكفي الاجتياز الوسيط (Inorder) لاستخراج كل القيم مرتبة تصاعديا.
لكن لهذه الشجرة نقطة ضعف قاتلة إذا تركت دون توازن. فإذا أدخلنا القيم مرتبة تصاعديا مثل 1 ثم 2 ثم 3 ثم 4، فستتجه كل قيمة جديدة إلى اليمين وتتحول الشجرة إلى سلسلة طويلة تشبه القائمة المرتبطة، فتنهار تكلفة العمليات من $O(\log n)$ إلى $O(n)$. وهذه المشكلة هي الدافع التاريخي لابتكار الأشجار المتوازنة ذاتيا.
كيفية البحث والإدراج والحذف في شجرة البحث الثنائية
يبدأ البحث من الجذر ويقارن القيمة المطلوبة بقيمة العقدة الحالية. فإذا تساوتا انتهى البحث بنجاح، وإذا كانت المطلوبة أصغر انتقل إلى الابن الأيسر، وإذا كانت أكبر انتقل إلى الأيمن، ويستمر ذلك حتى الوصول إلى القيمة أو إلى مؤشر فارغ يعني أنها غير موجودة. ويتبع الإدراج المسار نفسه تماما، فإذا وصل إلى موضع فارغ وضع العقدة الجديدة فيه. وتبلغ تكلفة العمليتين $O(h)$ حيث $h$ هو ارتفاع الشجرة.
تعد عملية الحذف أكثر العمليات تعقيدا، وتصنف ضمن ثلاث حالات:
- الحالة الأولى (ورقة): إذا كانت العقدة ورقة، أي لا تملك أبناء، يتم حذفها ببساطة عن طريق إلغاء المؤشر القادم من عقدتها الأب.
- الحالة الثانية (ابن واحد): إذا كانت العقدة تملك ابنا واحدا، يتم ربط عقدتها الأب مباشرة بذلك الابن، مما يؤدي فعليا إلى تجاوز العقدة المراد حذفها.
- الحالة الثالثة (ابنان): إذا كانت العقدة تملك ابنين، فيتم استبدال قيمتها بقيمة اللاحق في الترتيب (in-order successor)، وهي أصغر قيمة في شجرتها الفرعية اليمنى، ثم يحذف ذلك اللاحق من موقعه الأصلي، ويضمن هذا الإجراء بقاء خاصية الترتيب محفوظة.
- البحث: مقارنة مع كل عقدة واختيار اليسار أو اليمين، بتكلفة $O(h)$.
- الإدراج: السير في مسار البحث حتى الموضع الفارغ ثم وضع العقدة الجديدة.
- حذف ورقة: إزالتها وتفريغ مؤشر أبيها مباشرة.
- حذف عقدة بابن واحد: ربط الأب بالابن مباشرة وتجاوز العقدة.
- حذف عقدة بابنين: استبدال قيمتها بالخليفة الوسيط ثم حذف الخليفة.
الأشجار المتوازنة وأهميتها
الشجرة المتوازنة (Balanced Tree) هي شجرة يحافظ تصميمها على فارق صغير في الارتفاع بين فروعها المختلفة، فلا يسمح لفرع أن يطول كثيرا على حساب غيره. وتتحقق هذه الخاصية تلقائيا عبر عمليات تصحيح تنفذ بعد كل إدراج أو حذف، وأشهرها عمليات التدوير (Rotations) التي تعيد ترتيب العقد المجاورة دون الإخلال بقاعدة الترتيب. ولهذا تسمى هذه الأشجار بالأشجار المتوازنة ذاتيا (Self-balancing).
وتكمن أهمية التوازن في أنه يضمن الحد الأعلى للتكلفة في أسوأ الحالات، وليس في المتوسط فقط. فشجرة البحث العادية قد تكون ممتازة مع بيانات عشوائية وكارثية مع بيانات مرتبة، أما الشجرة المتوازنة فتضمن $O(\log n)$ مهما كان ترتيب الإدخال. وهذا الضمان حيوي في الأنظمة الإنتاجية التي لا تتحمل تذبذب الأداء، كقواعد البيانات وأنظمة الوقت الحقيقي.
شجرة AVL
شجرة AVL هي أول شجرة بحث متوازنة ذاتيا تم ابتكارها عام 1962. وتعتمد على مفهوم معامل التوازن (Balance Factor) لكل عقدة، وهو الفرق بين ارتفاع شجرتها الفرعية اليسرى واليمنى. ويشترط أن يكون هذا المعامل -1 أو 0 أو 1 فقط في كل عقدة، وإذا تجاوز ذلك بعد أي عملية اعتبرت الشجرة مختلة ووجب إصلاحها فورا.
ويتم الإصلاح بأربع حالات من التدوير:
- تدوير أيسر-أيسر: تدوير أيمن مفرد.
- تدوير أيمن-أيمن: تدوير أيسر مفرد.
- الحالتان المزدوجتان (Left-Right و Right-Left): تحتاجان إلى تدويرين متتاليين.
وتتميز شجرة AVL بأنها الأكثر صرامة في التوازن، فارتفاعها لا يتجاوز نحو $1.44 \log_2(n)$، وهو ما يجعل البحث فيها أسرع من غيرها من الأشجار المتوازنة.
شجرة الأحمر والأسود (Red-Black Tree)
شجرة الأحمر والأسود (Red-Black Tree) هي شجرة بحث ثنائية متوازنة تلون كل عقدة فيها بالأحمر أو بالأسود، وتستخدم هذه الألوان لتطبيق قواعد تضمن توازنا تقريبيا:
- الجذر أسود.
- العقدة الحمراء لا يكون لها ابن أحمر.
- كل مسار من أي عقدة إلى أوراقها التابعة يحتوي العدد نفسه من العقد السوداء.
وينتج عن هذه القواعد أن أطول مسار في الشجرة لا يزيد عن ضعف أقصر مسار. وتتم إعادة التوازن بعمليتي إعادة التلوين (Recoloring) و التدوير (Rotation). ونتيجة لهذا التوازن بين الأداء وبساطة الصيانة، صارت Red-Black الخيار المفضل في المكتبات القياسية (مثل TreeMap في Java و std::map في C++ ونواة Linux).
أشجار B و B+
شجرة B (B-Tree) هي شجرة بحث متوازنة متعددة الأبناء صممت خصيصا للتعامل مع وسائط التخزين البطيئة كالأقراص. فبدلا من عقدة تحمل مفتاحا واحدا وابنين، تحمل العقدة في شجرة B عدة مفاتيح مرتبة ولها عدد أبناء يزيد بواحد على عدد المفاتيح. فتصبح الشجرة عريضة وقليلة الارتفاع، وهذا يقلل عدد عمليات القراءة من القرص التي هي الأغلى زمنا.
أما شجرة B+ فهي نسخة محسنة تخزن جميع البيانات الفعلية في الأوراق فقط، وتخصص العقد الداخلية للمفاتيح الموجهة للبحث. وترتبط الأوراق ببعضها بقائمة مرتبطة، مما يجعل الاستعلام على النطاقات والمرور المتسلسل سريعا جدا. وتعتمد عليها أغلب قواعد البيانات العلائقية مثل MySQL (InnoDB) و PostgreSQL.
شجرة Trie للبحث عن الكلمات والبادئات
شجرة Trie (وتسمى أيضا الشجرة البادئية – Prefix Tree) هي شجرة متخصصة في تخزين النصوص والبحث عنها. ويمثل كل مسار من الجذر كلمة أو جزءا من كلمة، وتحمل كل حافة حرفا واحدا. وتتميز Trie بأن تكلفة البحث فيها تعتمد على طول الكلمة المطلوبة $O(m)$ وليس على عدد الكلمات المخزنة. وهي الأساس في خاصية الإكمال التلقائي (Autocomplete) والمدقق الإملائي.
اجتياز الأشجار: Preorder و Inorder و Postorder و Level Order
الاجتياز (Traversal) هو زيارة كل عقد الشجرة مرة واحدة بترتيب محدد:
- Preorder (جذر، يسار، يمين): لنسخ الشجرة وتسلسلها.
- Inorder (يسار، جذر، يمين): يعطي عناصر شجرة البحث مرتبة تصاعديا.
- Postorder (يسار، يمين، جذر): لحذف الشجرة وتقييم التعبيرات الحسابية.
- Level Order (مستوى بمستوى): يستخدم طابور (Queue) ويفيد في إيجاد أقصر مسار.
مثال عملي على إنشاء شجرة بحث ثنائية والتعامل معها
from collections import deque


class TreeNode:
    def __init__(self, key):
        self.key = key
        self.left = None
        self.right = None


class BST:
    def __init__(self):
        self.root = None

    def insert(self, key):
        self.root = self._insert(self.root, key)

    def _insert(self, node, key):
        if node is None:
            return TreeNode(key)
        if key < node.key:
            node.left = self._insert(node.left, key)
        elif key > node.key:
            node.right = self._insert(node.right, key)
        return node

    def search(self, key):
        node = self.root
        while node:
            if key == node.key:
                return True
            node = node.left if key < node.key else node.right
        return False

    def delete(self, key):
        self.root = self._delete(self.root, key)

    def _delete(self, node, key):
        if node is None:
            return None
        if key < node.key:
            node.left = self._delete(node.left, key)
        elif key > node.key:
            node.right = self._delete(node.right, key)
        else:
            if node.left is None:
                return node.right
            if node.right is None:
                return node.left
            successor = node.right
            while successor.left:
                successor = successor.left
            node.key = successor.key
            node.right = self._delete(node.right, successor.key)
        return node

    def inorder(self):
        result = []

        def walk(node):
            if node:
                walk(node.left)
                result.append(node.key)
                walk(node.right)

        walk(self.root)
        return result

    def level_order(self):
        result, queue = [], deque([self.root]) if self.root else deque()
        while queue:
            node = queue.popleft()
            result.append(node.key)
            if node.left:
                queue.append(node.left)
            if node.right:
                queue.append(node.right)
        return result

    def height(self, node="root"):
        if node == "root":
            node = self.root
        if node is None:
            return -1
        return 1 + max(self.height(node.left), self.height(node.right))


tree = BST()
for value in [50, 30, 70, 20, 40, 60, 80]:
    tree.insert(value)

print(tree.inorder())      # [20, 30, 40, 50, 60, 70, 80]
print(tree.level_order())  # [50, 30, 70, 20, 40, 60, 80]
print(tree.search(60))     # True
print(tree.height())       # 2
tree.delete(50)
print(tree.inorder())      # [20, 30, 40, 60, 70, 80]
يعرف الكود فئة TreeNode تحمل المفتاح ومؤشري الابنين، وفئة BST تحتفظ بالجذر وتنفذ العمليات عوديا. وتتجاهل دالة الإدراج القيم المكررة للحفاظ على تفرد المفاتيح، وتعيد الدالة العقدة نفسها في كل مستوى ليحدث الأب مؤشره تلقائيا، وهو أسلوب أنيق يغني عن تتبع الأب صراحة. أما البحث فمنفذ بحلقة بدلا من العودية لتوفير مساحة المكدس، وهي ممارسة جيدة مع الأشجار العميقة.
وتعالج دالة الحذف الحالات الثلاث بوضوح. فإذا كان أحد الابنين فارغا أعادت الابن الآخر ليحل محل العقدة، وهذا يغطي حالتي الورقة والابن الواحد معا. وإذا وجد الابنان، بحثت عن أصغر قيمة في الشجرة الفرعية اليمنى وهي الخليفة الوسيط، ونسخت قيمته إلى العقدة ثم حذفته من موضعه. ويظهر الاجتياز الوسيط القيم مرتبة بعد كل عملية، بينما يظهر الاجتياز بالمستويات شكل الشجرة الفعلي. ويجب تذكر أن هذا التنفيذ غير متوازن، فإدخال قيم مرتبة سيحوله إلى سلسلة، ولهذا تستخدم الإنتاجية أشجار AVL أو Red-Black الجاهزة.
هيكل البيانات Heap: الأكوام في البرمجة
يختلف هيكل Heap عن الأشجار التي ناقشناها قبل قليل في غايته، فهو لا يسعى إلى ترتيب كل العناصر بل إلى إبقاء أهمها في متناول اليد دائما. فعندما تحتاج إلى أصغر قيمة أو أعلى أولوية مرارا وتكرارا، يصبح ترتيب البيانات كاملة إهدارا للجهد. وهنا تأتي الكومة لتقدم حلا وسطا ذكيا، إذ تضمن أن العنصر الأهم يقع دائما عند الجذر، وتكتفي بترتيب جزئي لما عداه. ولهذا تقف الكومة خلف طوابير الأولوية وجدولة المهام وخوارزمية ترتيب الكومة (Heap Sort) وخوارزمية ديكسترا لأقصر المسارات.
ما هو هيكل البيانات Heap؟
الكومة (Heap) هي شجرة ثنائية مكتملة (Complete Binary Tree) تحقق خاصية ترتيب محددة بين كل عقدة وأبنائها. وكلمة مكتملة هنا تعني أن جميع المستويات ممتلئة عدا الأخير الذي يمتلئ من اليسار إلى اليمين دون فراغات. وتمنح هذه الخاصية الكومة شكلا مضغوطا وثابتا، فلا تتحول أبدا إلى سلسلة طويلة كما يحدث لشجرة البحث الثنائية غير المتوازنة. ويبقى ارتفاعها دائما قريبا من $\log_2(n)$، وهو ما يضمن أداء لوغاريتميا لعملياتها الأساسية.
ويجب التمييز هنا بين مفهومين يحملان الاسم نفسه وكثيرا ما يختلط أمرهما على المبتدئين. فـ الكومة كهيكل بيانات (Heap Data Structure) هي الشجرة التي نتحدث عنها، أما الكومة كمنطقة ذاكرة (Heap Memory) فهي المنطقة التي تخصص منها الذاكرة الديناميكية وناقشناها في قسم الذاكرة. ولا علاقة تقنية مباشرة بين المفهومين، وإنما تشاركا الاسم لأسباب تاريخية. ولذلك يحرص الكتاب المحترفون على ذكر السياق عند الحديث عن أي منهما.
وتتميز الكومة بأنها لا تدعم البحث العام بكفاءة، فإيجاد قيمة عشوائية داخلها يتطلب فحص العناصر بالتتابع بتكلفة خطية $O(n)$. لكنها تتفوق في مهمتين محددتين، هما قراءة العنصر الأعلى أولوية بزمن ثابت $O(1)$، واستخراجه أو إدراج عنصر جديد بزمن لوغاريتمي $O(\log n)$. وهذا التخصص هو سر قوتها، فهي تتخلى عن الترتيب الكامل مقابل سرعة في العملية التي تتكرر أكثر من غيرها.
الكومة الصغرى (Min-Heap) والكومة الكبرى (Max-Heap)
الكومة الصغرى (Min-Heap) هي كومة تكون فيها قيمة كل عقدة أصغر من أو تساوي قيم أبنائها. ونتيجة لذلك يقع أصغر عنصر في الجذر دائما، وتستخدم عندما تريد الوصول إلى القيمة الدنيا بسرعة، مثل اختيار المهمة الأقرب موعدا أو العقدة الأقل تكلفة في خوارزمية ديكسترا. أما الكومة الكبرى (Max-Heap) فتعكس القاعدة، فتكون كل عقدة أكبر من أو تساوي أبنائها، ويقع أكبر عنصر في الجذر.
ويجب الانتباه إلى أن العلاقة تخص الأب وأبناءه المباشرين فقط، ولا تحدد ترتيبا بين الأخوة أو بين عقد الفروع المختلفة. فقد يكون الابن الأيسر أكبر من الأيمن أو العكس، وقد تكون عقدة في مستوى أدنى في فرع أصغر من عقدة في مستوى أعلى في فرع آخر. وهذا الفرق الجوهري يميز الكومة عن شجرة البحث الثنائية، التي تفرض ترتيبا كاملا بين اليسار واليمين، ويفسر سبب عدم صلاحية الكومة للبحث العام.
وتتحول الكومة الصغرى إلى كبرى والعكس بسهولة عمليا. فيكفي عكس إشارة القيم عند الإدراج، أو عكس دالة المقارنة. ولهذا توفر بعض اللغات نوعا واحدا فقط، فمكتبة heapq في Python تنفذ كومة صغرى فقط، ويحاكي المبرمجون الكبرى بتخزين القيم السالبة. بينما توفر Java فئة PriorityQueue التي تقبل مقارنا مخصصا لتحديد الاتجاه.
كيف تُنظم العناصر داخل الكومة؟
تخزن الكومة عادة داخل مصفوفة عادية (Array) دون أي مؤشرات، وهذا من أجمل جوانب تصميمها. فبما أنها شجرة مكتملة، يمكن ترتيب عقدها في المصفوفة مستوى بعد مستوى من اليسار إلى اليمين، فيقع الجذر في الفهرس 0. ثم تحسب مواقع الأقارب بمعادلات بسيطة، فابنا العقدة ذات الفهرس $i$ يقعان عند $2i+1$ و $2i+2$، وأبوها يقع عند الفهرس $(i-1)//2$. وبذلك يتحول التنقل في الشجرة إلى عمليات حسابية سريعة.
ويعطي هذا التمثيل المصفوفي ميزات عملية مهمة. فهو يوفر الذاكرة لعدم الحاجة إلى مؤشرات الأبناء، ويستفيد من التجاور في الذاكرة المخبئية لأن العقد القريبة منطقيا متقاربة فيزيائيا، ويبسط التنفيذ كثيرا. كما يضمن أن الشجرة تبقى مكتملة دائما، فكل إدراج جديد يوضع في أول خانة فارغة في نهاية المصفوفة، وكل حذف يخلي الخانة الأخيرة فقط.
وتعتمد المحافظة على الترتيب على عمليتين داخليتين. الأولى هي الصعود (Sift Up أو Heapify Up)، وفيها تقارن العقدة المضافة حديثا بأبيها وتتبادل معه المكان إذا خالفت القاعدة، وتستمر صعودا حتى تستقر. والثانية هي النزول (Sift Down أو Heapify Down)، وفيها تقارن العقدة التي وضعت في الجذر بأبنائها وتتبادل مع الأصغر منهما في الكومة الصغرى، وتستمر نزولا حتى تستقر. وتبلغ تكلفة كل منهما $O(\log n)$ لأنها تقطع ارتفاع الشجرة على الأكثر.
العمليات الأساسية: الإدراج واستخراج العنصر الأعلى أولوية
يتم الإدراج (Insert) في الكومة بثلاث خطوات متتابعة. تضاف القيمة الجديدة أولا في أول خانة فارغة في نهاية المصفوفة لتحافظ الشجرة على اكتمالها، ثم تقارن بأبيها فإذا كانت أصغر منه في الكومة الصغرى تبادلا المكان، وتتكرر المقارنة صعودا حتى تستقر القيمة في موضعها الصحيح أو تصل إلى الجذر. وتتطلب العملية في أسوأ الحالات عددا من التبادلات يساوي ارتفاع الشجرة، أي $O(\log n)$، أما في المتوسط فتكون أقل من ذلك بكثير.
أما استخراج العنصر الأعلى أولوية (Extract-Min أو Extract-Max) فتنفذ كما يلي. يؤخذ الجذر ليعاد للمستخدم، ثم ينقل آخر عنصر في المصفوفة إلى موضع الجذر ليحافظ الهيكل على اكتماله، وبعدها ينزل هذا العنصر بالمقارنة مع أبنائه ويتبادل مع الأصغر منهم حتى تتحقق القاعدة من جديد. وتبلغ تكلفتها $O(\log n)$ أيضا. وتسمح هذه العمليات بإنجاز ترتيب الكومة (Heap Sort) بتكلفة $O(n \log n)$ وبذاكرة إضافية ثابتة. وفيما يلي ملخص العمليات:
- Peek: قراءة الجذر دون إزالته بتكلفة ثابتة $O(1)$.
- Insert: إضافة عنصر في النهاية ثم صعوده بتكلفة $O(\log n)$.
- Extract: إزالة الجذر ونقل آخر عنصر إليه ثم نزوله بتكلفة $O(\log n)$.
- Heapify: بناء كومة من مصفوفة كاملة بتكلفة خطية $O(n)$ وليس $O(n \log n)$.
- Delete: حذف عنصر معين بعد معرفة موضعه بتكلفة $O(\log n)$.
الفرق بين الكومة وشجرة البحث الثنائية
تبدو الكومة وشجرة البحث الثنائية متشابهتين في الشكل، فكلاهما شجرة ثنائية تضبط العلاقة بين العقدة وأبنائها. لكنهما تختلفان جذريا في الغاية والقاعدة، فشجرة البحث تهدف إلى البحث عن أي قيمة بسرعة عبر ترتيب كامل، بينما تهدف الكومة إلى الوصول السريع إلى القيمة القصوى أو الدنيا فقط عبر ترتيب جزئي. ولذلك يختلف استخدام كل منهما تماما، ويوضح الجدول التالي أهم الفروق:
| وجه المقارنة | الكومة (Heap) | شجرة البحث الثنائية (BST) |
| الغاية | الوصول السريع للأصغر أو الأكبر | البحث السريع عن أي قيمة |
| قاعدة الترتيب | الأب أصغر من أبنائه أو أكبر | اليسار أصغر والعقدة أصغر من اليمين |
| الشكل | مكتملة دائما | قد تكون غير متوازنة |
| التخزين | مصفوفة بلا مؤشرات | عقد ومؤشرات |
| قراءة الأصغر أو الأكبر | $O(1)$ للقيمة عند الجذر | $O(h)$ بالنزول لأقصى اليسار أو اليمين |
| البحث عن قيمة عشوائية | $O(n)$ | $O(\log n)$ متوازنة |
| الإدراج | $O(\log n)$ | $O(\log n)$ متوسطا و $O(n)$ أسوأ حالة |
| الاجتياز المرتب | غير مدعوم مباشرة | متاح بالاجتياز الوسيط |
| أفضل استخدام | طوابير الأولوية والجدولة | القواميس المرتبطة والاستعلام على النطاقات |
استخدامات الأكوام في جدولة المهام وإدارة الأولويات
تعد جدولة المهام أبرز تطبيقات الكومة، فنظام التشغيل يحتاج إلى اختيار العملية التالية ذات الأولوية الأعلى من بين مئات العمليات الجاهزة. وتتيح الكومة هذا الاختيار بزمن لوغاريتمي مهما كثر العدد، مع إمكانية إضافة عمليات جديدة في أي لحظة. وتستخدم الفكرة نفسها في مجدولات المهام الخلفية وأنظمة المؤقتات حيث تحتفظ كومة صغرى بالمهام مرتبة بحسب موعد التنفيذ، فيعرف النظام المهمة الأقرب موعدا بقراءة الجذر فقط.
وتدخل الكومة في قلب عدد من الخوارزميات المهمة. فخوارزمية ديكسترا لأقصر المسارات تستخدم كومة صغرى لاختيار العقدة الأقرب في كل خطوة، وخوارزمية برايم (Prim) للشجرة الممتدة الصغرى تفعل الأمر نفسه، وخوارزمية هوفمان لضغط البيانات تدمج الرموز الأقل تكرارا باستخدامها. كما تستخدم في إيجاد أكبر $k$ عنصرا في تدفق بيانات ضخم بالاحتفاظ بكومة صغرى بحجم $k$ فقط، وهي حيلة شهيرة توفر الذاكرة بدرجة كبيرة.
وتبرز الكومة كذلك في حساب الوسيط (Median) لتدفق بيانات متجدد. فتستخدم كومتان إحداهما كبرى للنصف الأصغر من القيم والأخرى صغرى للنصف الأكبر، ويقع الوسيط عند جذر إحداهما أو بينهما. وتستخدم المحاكاة الحدثية (Event Simulation) في الألعاب والأنظمة العلمية كومة لمعالجة الأحداث بترتيب زمنها. وكل هذه التطبيقات تشترك في حاجة متكررة إلى استخراج الأفضل من مجموعة متغيرة، وهي المهمة التي صممت الكومة لأجلها.
مثال عملي على استخدام Heap في Python
يعرض المثال التالي استخدام مكتبة heapq الجاهزة كومة صغرى، ومحاكاة الكومة الكبرى بالقيم السالبة، ثم تنفيذا يدويا لكومة صغرى يوضح عمليتي الصعود والنزول، وأخيرا تطبيقا عمليا لإيجاد أكبر ثلاثة عناصر.
import heapq

# كومة صغرى جاهزة
heap = []
for value in [5, 3, 8, 1, 9, 2]:
    heapq.heappush(heap, value)

print(heap[0])                 # 1 (الجذر هو الأصغر)
print(heapq.heappop(heap))     # 1
print(heapq.heappop(heap))     # 2

# بناء كومة من قائمة كاملة بتكلفة خطية
data = [7, 2, 9, 4, 1]
heapq.heapify(data)
print(data[0])                 # 1

# محاكاة كومة كبرى بالقيم السالبة
max_heap = []
for value in [5, 3, 8]:
    heapq.heappush(max_heap, -value)
print(-heapq.heappop(max_heap))   # 8

# أكبر ثلاثة عناصر
print(heapq.nlargest(3, [4, 10, 7, 1, 9]))   # [10, 9, 7]


class MinHeap:
    def __init__(self):
        self.items = []

    def push(self, value):
        self.items.append(value)
        self._sift_up(len(self.items) - 1)

    def pop(self):
        if not self.items:
            raise IndexError("الكومة فارغة")
        root = self.items[0]
        last = self.items.pop()
        if self.items:
            self.items[0] = last
            self._sift_down(0)
        return root

    def _sift_up(self, i):
        while i > 0:
            parent = (i - 1) // 2
            if self.items[i] < self.items[parent]:
                self.items[i], self.items[parent] = self.items[parent], self.items[i]
                i = parent
            else:
                break

    def _sift_down(self, i):
        n = len(self.items)
        while True:
            smallest = i
            left, right = 2 * i + 1, 2 * i + 2
            if left < n and self.items[left] < self.items[smallest]:
                smallest = left
            if right < n and self.items[right] < self.items[smallest]:
                smallest = right
            if smallest == i:
                break
            self.items[i], self.items[smallest] = self.items[smallest], self.items[i]
            i = smallest


h = MinHeap()
for v in [9, 4, 7, 1, 6]:
    h.push(v)
print([h.pop() for _ in range(5)])   # [1, 4, 6, 7, 9]
يبدأ الكود بالاستخدام المباشر لمكتبة heapq، فتضيف heappush القيمة وتحافظ على الخاصية، وتزيل heappop الأصغر دائما. وتبني دالة heapify كومة كاملة من قائمة جاهزة بتكلفة خطية $O(n)$ وهي أسرع من إدراج العناصر واحدا تلو الآخر. وتحاكي القيم السالبة كومة كبرى لأن أصغر قيمة سالبة تقابل أكبر قيمة موجبة. وتوفر دالة nlargest حلا جاهزا لأكبر $k$ عنصرا بكفاءة تفوق ترتيب القائمة كاملة عندما يكون $k$ صغيرا.
أما الفئة MinHeap فتوضح الآلية الداخلية كاملة. فدالة push تضيف العنصر في النهاية ثم تصعده عبر _sift_up مقارنة بالأب الذي يحسب فهرسه بالمعادلة (i-1)//2. ودالة pop تنقل آخر عنصر إلى الجذر ثم تنزله عبر _sift_down مختارة في كل خطوة الأصغر بين العقدة وابنيها. ويظهر السطر الأخير أن الاستخراج المتكرر يعيد القيم مرتبة تصاعديا، وهذا هو أساس ترتيب الكومة. وينبغي اختبار الحالات الحدية كالكومة الفارغة والعنصر الوحيد والقيم المكررة.ة. وينبغي اختبار الحالات الحدية كالكومة الفارغة والعنصر الوحيد والقيم المكررة.
هياكل البيانات البيانية (Graph Data Structures)
إذا كانت الأشجار تمثل العلاقات الهرمية ذات الاتجاه الواحد من الأب إلى الابن، فإن الرسوم البيانية (Graphs) تمثل العلاقات الحرة بين الكيانات دون قيد على الشكل. وهي الهيكل الأقرب إلى تعقيد العالم الحقيقي، فشبكات الطرق والصداقات والإنترنت والاعتماديات بين الحزم البرمجية كلها رسوم بيانية. وتعد نظرية الرسوم البيانية فرعا كاملا من الرياضيات المتقطعة بدأ بحل ليونهارد أويلر لمسألة جسور كونيغسبرغ عام 1736. وتقف اليوم خلف تطبيقات الملاحة والتوصية وتحليل الشبكات الاجتماعية وقواعد بيانات الرسوم.
ما هي الرسوم البيانية في الداتا ستركشر؟
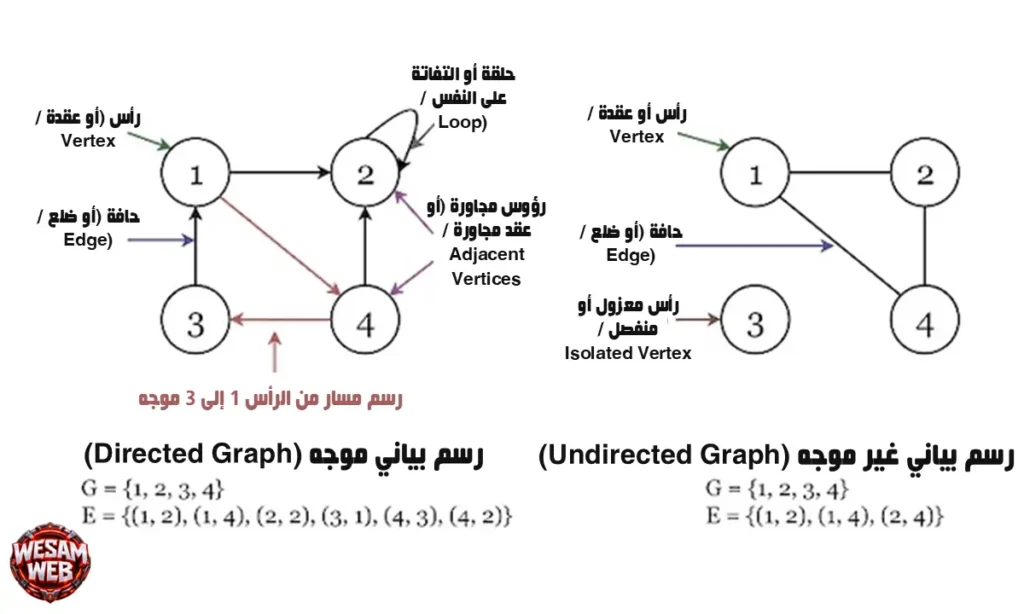
الرسم البياني (Graph) هو هيكل بيانات يتكون من مجموعة من الرؤوس (Vertices) ومجموعة من الحواف (Edges) التي تصل بين أزواج من تلك الرؤوس. ويرمز له رياضيا بـ $G = (V, E)$. وتمثل الرؤوس الكيانات كالأشخاص أو المدن أو الصفحات، وتمثل الحواف العلاقات بينها كالصداقة أو الطريق أو الرابط. ويختلف الرسم البياني عن الشجرة في أنه يسمح بوجود دورات وبأكثر من مسار بين عقدتين، كما لا يشترط وجود جذر أو تسلسل هرمي.
وتتجلى قوة الرسوم البيانية في قدرتها على نمذجة المشكلات التي تتمحور حول العلاقات. فبدلا من السؤال عن قيمة كل عنصر، تسأل عن كيفية ارتباط العناصر ببعضها. ومن أمثلة هذه الأسئلة: ما هو أقصر طريق بين نقطتين، وهل يمكن الوصول من جهاز إلى آخر في الشبكة، ومن هم الأصدقاء المشتركون بين مستخدمين، وما ترتيب تنفيذ المهام المترابطة بالاعتماد. وتجيب خوارزميات متخصصة عن كل سؤال من هذه الأسئلة.
ويمثل الرسم البياني عمليا أعم الهياكل التي عرضناها. فالقائمة المرتبطة رسم بياني مبسط ذو مسار واحد، والشجرة رسم بياني متصل بلا دورات، والمصفوفة ثنائية الأبعاد يمكن أن ينظر إليها كرسم شبكي. ولذلك يعد فهم الرسوم البيانية مدخلا لحل مسائل متقدمة كثيرة في الخوارزميات، ويحتل مكانة ثابتة في المقابلات التقنية للشركات الكبرى.
الرؤوس (Vertices) والحواف (Edges)
الرأس (Vertex أو Node) هو الوحدة الأساسية في الرسم البياني، ويمثل كيانا منفردا قد يحمل بيانات مرافقة كاسم المدينة أو معرف المستخدم. ويعرف عدد الحواف المتصلة بالرأس بـ درجته (Degree)، فالرأس ذو الدرجة العالية يعد مركزا في الشبكة، ويسمى أحيانا محورا (Hub). وتعد هذه الخاصية أساسية في تحليل الشبكات الاجتماعية، حيث يمثل الشخص ذو الدرجة الأعلى أكثر المستخدمين اتصالا. ويسمى الرأس الذي لا حواف له رأسا معزولا (Isolated Vertex).
أما الحافة (Edge) فهي الرابط الذي يصل بين رأسين، وتمثل علاقة بينهما. وقد تحمل الحافة بدورها معلومات إضافية كالمسافة أو التكلفة أو زمن الرحلة. ويسمى الرأسان المتصلان بحافة واحدة متجاورين (Adjacent). وقد توجد حافة تصل الرأس بنفسه وتسمى حلقة ذاتية (Self-loop)، وقد توجد حافتان أو أكثر بين الرأسين نفسيهما وتسمى حوافا متوازية (Parallel Edges)، ويعمل كثير من الخوارزميات على رسوم بسيطة تخلو منهما.
ويرتبط عدد الحواف بعدد الرؤوس بعلاقة تحدد كثافة الرسم. فالرسم غير الموجه البسيط الذي يضم $V$ رأسا قد يحتوي على $V(V-1)/2$ حافة كحد أقصى. ويسمى الرسم كثيفا (Dense) إذا اقترب عدد حوافه من هذا الحد، ومتناثرا (Sparse) إذا كان أقل منه بكثير. وتؤثر هذه الكثافة مباشرة في اختيار طريقة التمثيل في الذاكرة، فالرسوم المتناثرة تناسب قوائم التجاور، والكثيفة تناسب مصفوفات التجاور.
الرسوم البيانية الموجهة وغير الموجهة
في الرسم البياني غير الموجه (Undirected Graph) تكون العلاقة بين الرأسين متبادلة في الاتجاهين. فإذا كان أحمد صديقا لسارة فسارة أيضا صديقة لأحمد، وتمثل هذه العلاقة بحافة واحدة بلا اتجاه. ويناسب هذا النوع الشبكات الاجتماعية القائمة على الصداقة المتبادلة وخرائط الطرق ثنائية الاتجاه وشبكات الحواسيب المتصلة بكابلات متبادلة. ويمكن التنقل عبر كل حافة ذهابا وإيابا دون قيد.
أما الرسم البياني الموجه (Directed Graph أو Digraph) فتكون لكل حافة فيه وجهة محددة من رأس مصدر إلى رأس هدف، ولا يلزم أن توجد علاقة في الاتجاه المعاكس. فمتابعة حساب على منصة اجتماعية علاقة موجهة، فقد تتابع شخصا دون أن يتابعك. وكذلك الروابط بين صفحات الويب، فصفحة تشير إلى أخرى دون عكس، وتعتمد خوارزمية PageRank على هذا الرسم الموجه. وتستخدم الرسوم الموجهة كذلك في الشوارع ذات الاتجاه الواحد.
ويجب التمييز بين درجة الدخول (In-degree) وهي عدد الحواف الداخلة إلى الرأس، ودرجة الخروج (Out-degree) وهي عدد الحواف الخارجة منه في الرسوم الموجهة. ويهم هذا التمييز في عدة خوارزميات، منها الترتيب الطوبولوجي (Topological Sort) الذي يرتب الرؤوس بحيث يسبق كل رأس الرؤوس التي يشير إليها، ويستخدم في جدولة المهام المعتمدة على بعضها وحل اعتماديات الحزم البرمجية. ويشترط لإمكانه ألا يحتوي الرسم على دورة، أي أن يكون رسما موجها غير دوري (DAG).
الرسوم البيانية الموزونة وغير الموزونة
الرسم البياني غير الموزون (Unweighted Graph) هو الذي تتساوى فيه كل الحواف في القيمة، فالمهم وجود الاتصال وليس كلفته. ويستخدم في المشكلات التي يهم فيها عدد الخطوات فقط، كمعرفة درجة القرابة بين شخصين في شبكة اجتماعية. ويكفي البحث بالعرض (BFS) لإيجاد أقصر مسار فيه، لأنه يستكشف الرؤوس مستوى بعد مستوى من المصدر، فأول وصول إلى الهدف هو بأقل عدد من الحواف.
أما الرسم الموزون (Weighted Graph) فتحمل كل حافة فيه رقما يسمى الوزن (Weight) يعبر عن المسافة أو التكلفة أو الزمن أو السعة. وفي هذه الحالة لا يكون أقصر مسار من حيث عدد الحواف هو بالضرورة الأرخص، فطريق من ثلاث حواف صغيرة الوزن قد يتفوق على طريق من حافة واحدة كبيرة الوزن. ولذلك تستخدم خوارزميات خاصة مثل ديكسترا للأوزان غير السالبة، وبيلمان فورد (Bellman-Ford) التي تدعم الأوزان السالبة، وفلويد وارشال لكل الأزواج.
وتظهر الرسوم الموزونة في أغلب التطبيقات العملية. فتطبيقات الملاحة تعتمد على رسم موزون حيث تمثل الأوزان أزمنة الرحلة المتغيرة بحسب الازدحام، وشركات الطيران تستخدمه لأسعار الرحلات، وشبكات الحاسوب تستخدمه لزمن التأخير بين الموجهات. ويستخدم في إيجاد الشجرة الممتدة الصغرى (Minimum Spanning Tree) التي تصل كل الرؤوس بأقل تكلفة إجمالية، كما في تصميم شبكات الكهرباء والاتصالات بأقل كلفة ممكنة.
الرسوم البيانية المتصلة وغير المتصلة
يسمى الرسم البياني غير الموجه متصلا (Connected) إذا وجد مسار بين كل زوج من رؤوسه، أي أنه يمكن الوصول من أي رأس إلى أي رأس آخر عبر حواف الرسم. ويمثل ذلك شبكة سليمة يستطيع فيها كل جهاز التواصل مع الباقي. أما الرسم غير المتصل (Disconnected) فينقسم إلى عدة أجزاء منفصلة تسمى المكونات المتصلة (Connected Components)، ولا يوجد مسار بين رأسين يقعان في مكونين مختلفين.
ويحتاج المبرمج غالبا إلى تحديد المكونات المتصلة، وهي مهمة تنجز بالبحث بالعمق (DFS) أو بالعرض (BFS) أو بهيكل المجموعات المنفصلة (DSU). فتبدأ من رأس غير مزار وتزور كل ما يمكن الوصول إليه منه فتكون مكونا، ثم تنتقل إلى رأس غير مزار آخر وتكرر العملية. ويستخدم هذا في اكتشاف المجتمعات المنعزلة في الشبكات الاجتماعية، وفي معالجة الصور لتحديد المناطق المتجاورة المتشابهة، وفي كشف الأعطال التي تفصل الشبكة إلى أجزاء.
وفي الرسوم الموجهة يتعقد مفهوم الاتصال قليلا. فيسمى الرسم قوي الاتصال (Strongly Connected) إذا أمكن الوصول من كل رأس إلى كل رأس آخر باتباع اتجاه الحواف، ويسمى ضعيف الاتصال (Weakly Connected) إذا كان متصلا عند تجاهل الاتجاهات فقط. وتستخدم خوارزميات مثل كوساراجو وتارجان لإيجاد المكونات قوية الاتصال. ويفيد ذلك في تحليل بنية الويب واكتشاف الاعتماديات الدائرية بين الوحدات البرمجية.
تمثيل الرسوم البيانية باستخدام قائمة التجاور ومصفوفة التجاور
تعد مصفوفة التجاور (Adjacency Matrix) أبسط طريقة لتمثيل الرسم البياني، وهي مصفوفة مربعة ثنائية الأبعاد أبعادها $V \times V$. تدل الخانة عند الصف $i$ والعمود $j$ على وجود حافة من الرأس $i$ إلى الرأس $j$، فتحمل القيمة 1 عند وجودها و0 عند غيابها، أو تحمل الوزن نفسه في الرسوم الموزونة. وتمنح هذه الطريقة اختبارا فوريا لوجود حافة بين أي رأسين بزمن ثابت $O(1)$، لكنها تستهلك ذاكرة من الرتبة $O(V^2)$ مهما قل عدد الحواف.
أما قائمة التجاور (Adjacency List) فتخزن لكل رأس قائمة بالرؤوس المجاورة له فقط، وتنفذ عادة بقاموس أو مصفوفة من القوائم. ولا تستهلك سوى ذاكرة من الرتبة $O(V + E)$، أي تتناسب مع حجم الرسم الفعلي، فهي الخيار الأمثل للرسوم المتناثرة التي تغلب في العالم الحقيقي. كما تسهل الوصول إلى جيران أي رأس بسرعة تتناسب مع عددهم، وهي العملية الأكثر تكرارا في خوارزميات الاجتياز. وفي المقابل يتطلب اختبار وجود حافة محددة فحص قائمة الرأس بتكلفة تتناسب مع درجته.
وتوجد طرق أخرى أقل شيوعا لتمثيل الرسوم. فقائمة الحواف (Edge List) تخزن كل حافة كزوج من الرؤوس وهي مناسبة لخوارزميات تعمل على الحواف مباشرة كخوارزمية كروسكال. ومصفوفة الوقوع (Incidence Matrix) تربط الرؤوس بالحواف وتستخدم في حالات نظرية خاصة. ويعتمد الاختيار بين كل هذه الطرق على كثافة الرسم وعلى العمليات المطلوبة، ويفضل أغلب المطورين قوائم التجاور لأنها توازن بين الكفاءة والبساطة.
الفرق بين قائمة التجاور ومصفوفة التجاور
يلخص الجدول التالي المقارنة بين أشهر طريقتين لتمثيل الرسوم البيانية، وهو مرجع سريع عند اختيار التمثيل المناسب لمشكلتك:
| وجه المقارنة | مصفوفة التجاور (Adjacency Matrix) | قائمة التجاور (Adjacency List) |
| البنية | مصفوفة ثنائية $V \times V$ | قائمة جيران لكل رأس |
| استهلاك الذاكرة | $O(V^2)$ | $O(V + E)$ |
| فحص وجود حافة | $O(1)$ | $O(\text{درجة الرأس})$ |
| إيجاد جيران رأس | $O(V)$ | $O(\text{درجة الرأس})$ |
| إضافة حافة | $O(1)$ | $O(1)$ |
| حذف حافة | $O(1)$ | $O(\text{درجة الرأس})$ |
| إضافة رأس | مكلفة لأنها تعيد بناء المصفوفة | سهلة وسريعة |
| الأنسب لـ | الرسوم الكثيفة وفحص الحواف المتكرر | الرسوم المتناثرة والاجتياز المتكرر |
| الاستخدام الشائع | خوارزمية فلويد وارشال | BFS وDFS وديكسترا |
استخدامات الرسوم البيانية في الشبكات والخرائط والعلاقات الاجتماعية
- الشبكات والاتصالات: التوجيه وأقصر المسارات وتحليل اتصال الشبكة واكتشاف الأعطال.
- الخرائط والملاحة: إيجاد أسرع طريق وتقدير زمن الوصول وتخطيط الرحلات متعددة المحطات.
- الشبكات الاجتماعية: اقتراح الأصدقاء وتحليل المجتمعات وقياس التأثير.
- التوصية والرسوم المعرفية: ربط المستخدمين بالمحتوى وبناء قواعد المعرفة.
- جدولة المهام والاعتماديات: الترتيب الطوبولوجي لبناء المشاريع وحل اعتماديات الحزم.
تعتمد الشبكات الحاسوبية على الرسوم البيانية في تمثيل الأجهزة والروابط بينها. فتمثل الموجهات والخوادم رؤوسا، وتمثل الكابلات والاتصالات حوافا موزونة بزمن التأخير أو عرض النطاق. وتستخدم بروتوكولات التوجيه مثل OSPF خوارزمية ديكسترا لحساب أقصر مسار لكل حزمة. وفي الخرائط تعمل تطبيقات الملاحة على رسم ضخم تمثل فيه التقاطعات رؤوسا والطرق حوافا موزونة بالزمن، وتستخدم خوارزميات مثل A* لتسريع البحث عن أفضل طريق.
وفي الشبكات الاجتماعية تمثل الرسوم البيانية العلاقات بين المستخدمين، فتقترح المنصات أصدقاء جددا بإيجاد أصدقاء الأصدقاء، وتحلل المجتمعات والمؤثرين عبر مقاييس المركزية (Centrality). وتقوم محركات التوصية على رسوم ثنائية تربط المستخدمين بالمنتجات. كما تعتمد قواعد بيانات الرسوم مثل Neo4j عليها كليا في تخزين البيانات المترابطة والاستعلام عنها، وتستخدم الرسوم المعرفية (Knowledge Graphs) في محركات البحث والذكاء الاصطناعي.
مثال عملي على تمثيل رسم بياني بلغة Python
يعرض المثال التالي فئة لرسم بياني غير موجه بقائمة تجاور مبنية على قاموس، مع البحث بالعرض والبحث بالعمق وإيجاد أقصر مسار في رسم غير موزون، ثم مثالا لخوارزمية ديكسترا على رسم موزون باستخدام الكومة:
from collections import deque
import heapq


class Graph:
    def __init__(self):
        self.adj = {}

    def add_edge(self, u, v):
        self.adj.setdefault(u, []).append(v)
        self.adj.setdefault(v, []).append(u)   # غير موجه

    def bfs(self, start):
        visited, order = {start}, []
        queue = deque([start])
        while queue:
            node = queue.popleft()
            order.append(node)
            for neighbor in self.adj.get(node, []):
                if neighbor not in visited:
                    visited.add(neighbor)
                    queue.append(neighbor)
        return order

    def dfs(self, start):
        visited, order = set(), []

        def visit(node):
            visited.add(node)
            order.append(node)
            for neighbor in self.adj.get(node, []):
                if neighbor not in visited:
                    visit(neighbor)

        visit(start)
        return order

    def shortest_path(self, start, goal):
        parent = {start: None}
        queue = deque([start])
        while queue:
            node = queue.popleft()
            if node == goal:
                path = []
                while node is not None:
                    path.append(node)
                    node = parent[node]
                return path[::-1]
            for neighbor in self.adj.get(node, []):
                if neighbor not in parent:
                    parent[neighbor] = node
                    queue.append(neighbor)
        return None


g = Graph()
for u, v in [("A", "B"), ("A", "C"), ("B", "D"), ("C", "D"), ("D", "E")]:
    g.add_edge(u, v)

print(g.bfs("A"))                  # ['A', 'B', 'C', 'D', 'E']
print(g.dfs("A"))                  # ['A', 'B', 'D', 'C', 'E']
print(g.shortest_path("A", "E"))   # ['A', 'B', 'D', 'E']


def dijkstra(graph, source):
    dist = {node: float("inf") for node in graph}
    dist[source] = 0
    heap = [(0, source)]
    while heap:
        d, node = heapq.heappop(heap)
        if d > dist[node]:
            continue
        for neighbor, weight in graph[node]:
            new_dist = d + weight
            if new_dist < dist[neighbor]:
                dist[neighbor] = new_dist
                heapq.heappush(heap, (new_dist, neighbor))
    return dist


weighted = {
    "A": [("B", 4), ("C", 1)],
    "B": [("D", 1)],
    "C": [("B", 2), ("D", 5)],
    "D": [],
}
print(dijkstra(weighted, "A"))   # {'A': 0, 'B': 3, 'C': 1, 'D': 4}
شرح وتنفيذ الشيفرة البرمجية للرسم البياني
تعتمد الفئة Graph على قاموس يربط كل رأس بقائمة جيرانه، وتضيف دالة add_edge الحافة في الاتجاهين لأن الرسم غير موجه. وينفذ البحث بالعرض بطابور deque ويزور الرؤوس مستوى بعد مستوى، بينما ينفذ البحث بالعمق عوديا ويتعمق في كل فرع قبل الرجوع، ويحتفظ كلاهما بمجموعة visited لتفادي الدوران في الدورات. وتعيد دالة shortest_path أقصر مسار من حيث عدد الحواف بتتبع الآباء ثم عكس المسار المبني، وهي تعتمد على خاصية البحث بالعرض في الرسوم غير الموزونة.
أما دالة dijkstra فتطبق الخوارزمية على رسم موزون باستخدام كومة صغرى تعيد دائما الرأس ذا أقل مسافة معروفة. ويتجاهل الشرط d > dist[node] الإدخالات القديمة التي فقدت صلاحيتها بعد إيجاد مسار أقصر، وهي تقنية عملية تغني عن تحديث القيم داخل الكومة. ويظهر الناتج أن أقصر طريق من A إلى D يمر عبر C ثم B بتكلفة 4، وهو أرخص من المسار المباشر عبر B بتكلفة 5. وتبلغ التكلفة الكلية $O((V + E) \log V)$. وتفشل هذه الخوارزمية مع الأوزان السالبة، فيجب حينها استخدام بيلمان فورد.شر عبر B بتكلفة 5. وتبلغ التكلفة الكلية O((V + E) log V). وتفشل هذه الخوارزمية مع الأوزان السالبة، فيجب حينها استخدام بيلمان فورد.
هياكل البيانات المتقدمة
عندما تكبر المشكلات وتتعقد متطلبات الأداء، لا تكفي الهياكل الأساسية مهما أتقنا استخدامها. فمصفوفة المجاميع التراكمية تجيب عن استعلام المجموع بسرعة، لكنها تنهار عند تعديل العناصر باستمرار. وجدول التجزئة يجيب عن سؤال الوجود بدقة، لكنه يستهلك ذاكرة ضخمة عند المليارات من المفاتيح. وهنا تظهر الهياكل المتقدمة، وهي تصميمات متخصصة صنعت لـ حل مشكلة محددة بكفاءة استثنائية، وغالبا بتقديم مقايضة ذكية بين السرعة والذاكرة والدقة. ولا يحتاج كل مبرمج إلى بنائها يدويا، لكن فهم فكرتها يوسع أدوات التفكير ويمكنك من اختيار المكتبة المناسبة بوعي.
شجرة المقاطع (Segment Tree)
شجرة المقاطع (Segment Tree) هي شجرة ثنائية تقسم مصفوفة إلى مقاطع متتالية، وتخزن في كل عقدة ناتج دالة تجميعية على المقطع الذي تمثله، مثل المجموع أو أصغر قيمة أو أكبر قيمة أو القاسم المشترك الأكبر. فالجذر يمثل المصفوفة كاملة، وابناه يمثلان نصفيها، وهكذا حتى تصل الأوراق التي تمثل عناصر مفردة. وبهذا التصميم تصبح الإجابة عن سؤال مثل ما مجموع العناصر من الموضع 3 إلى الموضع 90؟ عملية تجمع عددا صغيرا من العقد الجاهزة بدلا من المرور على كل العناصر.
وتتفوق هذه الشجرة في المشكلات التي تجمع بين استعلامات النطاق (Range Queries) وتعديل العناصر. فبناؤها يتم مرة واحدة بتكلفة خطية $O(n)$، ثم يتم كل استعلام على نطاق وكل تعديل على عنصر بتكلفة لوغاريتمية $O(\log n)$. أما البدائل الأبسط فتضطر إلى التضحية بإحدى العمليتين. فـالمصفوفة العادية تجيب عن المجموع بتكلفة $O(n)$ وتعدل بتكلفة $O(1)$، ومصفوفة المجاميع التراكمية تجيب بتكلفة $O(1)$ وتعدل بتكلفة $O(n)$. وتحقق شجرة المقاطع توازنا بين الاثنين.
وتخزن الشجرة عادة داخل مصفوفة بحجم يقارب أربعة أضعاف عدد العناصر لضمان كفاية المساحة، وتحسب مواقع الأبناء بالمعادلات نفسها المستخدمة في الكومة. وتمتد فكرتها إلى التحديث الكسول (Lazy Propagation) الذي يؤجل نشر التعديلات على نطاقات كاملة إلى حين الحاجة، فيتيح تعديل نطاق بتكلفة لوغاريتمية أيضا. وتستخدم شجرة المقاطع في البرمجة التنافسية وأنظمة التحليلات التي تحسب إحصاءات على فترات زمنية والرسوميات الحاسوبية وقواعد البيانات الجغرافية.
شجرة فهرس فينويك (Fenwick Tree أو Binary Indexed Tree)
شجرة فينويك (Fenwick Tree) وتسمى أيضا الشجرة المفهرسة ثنائيا (Binary Indexed Tree – BIT)، هي هيكل مدمج اقترحه بيتر فينويك عام 1994 لحساب المجاميع التراكمية مع التعديلات. وهي تحل المشكلة التي تحلها شجرة المقاطع تقريبا، لكن بشيفرة أقصر وذاكرة أقل، إذ تستخدم مصفوفة واحدة بحجم $n$ فقط. وتكمن الحيلة في أن كل خانة في المصفوفة لا تخزن قيمة عنصر واحد، بل مجموع نطاق محدد من العناصر يتحدد طوله بـ أقل بت مضيء في فهرس الخانة.
وتعتمد الآلية على عملية بتية بسيطة هي i & -i تعزل أقل بت مضيء في العدد. فعند تعديل عنصر، تبدأ من فهرسه وتضيف القيمة إلى الخانة، ثم تنتقل إلى الخانة التالية بإضافة أقل بت مضيء إلى الفهرس، وتكرر العملية حتى تتجاوز الحجم. وعند حساب المجموع التراكمي، تبدأ من الفهرس المطلوب وتجمع الخانات بطرح أقل بت مضيء في كل خطوة حتى الصفر. وتتم العمليتان بتكلفة لوغاريتمية $O(\log n)$، ويحسب مجموع أي نطاق بطرح مجموعين تراكميين.
ويفضل المطورون شجرة فينويك عندما تكون العمليات جمعا أو ما شابهه مما يقبل العكس كـ الطرح، لأن بساطتها وسرعتها العملية تتفوق على شجرة المقاطع. لكنها أقل مرونة، فلا تدعم بسهولة العمليات غير القابلة للعكس كـ الحد الأدنى والأقصى، ولا التحديثات الكسولة المعقدة. وتستخدم في حساب التكرارات التراكمية وعد المقلوبات (Inversions) في المصفوفة وأنظمة الترتيب والتوزيعات الاحتمالية المتجددة، فهي أداة عملية صغيرة ذات أثر كبير.
هيكل المجموعات المنفصلة (Disjoint Set Union – DSU)
هيكل المجموعات المنفصلة (DSU) ويسمى أيضا Union-Find، هو هيكل يدير مجموعة من العناصر مقسمة إلى مجموعات لا تتقاطع، ويجيب عن سؤالين فقط بسرعة فائقة. السؤال الأول هو إلى أي مجموعة ينتمي هذا العنصر؟ وتجيب عنه عملية Find، والسؤال الثاني هو كيف ندمج مجموعتين في مجموعة واحدة؟ وتجيب عنه عملية Union. وتمثل كل مجموعة شجرة يشير فيها كل عنصر إلى أبيه، ويعد جذر الشجرة ممثل المجموعة، فيتساوى عنصران في المجموعة إذا كان جذرهما واحدا.
ويعتمد أداء DSU على تحسينين أساسيين متكاملين:
- ضغط المسار (Path Compression): في كل عملية
Findيربط كل عنصر على المسار مباشرة بالجذر، فتقصر المسارات في الاستعلامات اللاحقة. - الدمج بالرتبة أو بالحجم (Union by Rank/Size): عند دمج شجرتين تعلق الشجرة الأصغر تحت جذر الأكبر، فيبقى الارتفاع صغيرا.
وعند تطبيق التحسينين معا، تصبح التكلفة المطفأة لكل عملية شبه ثابتة، وتساوي معكوس دالة أكرمان $\alpha(n)$ التي لا تتجاوز 4 لأي حجم عملي.
وتظهر قوة DSU في مشكلات الاتصال الديناميكي. فهي الأساس في خوارزمية كروسكال (Kruskal) لإيجاد الشجرة الممتدة الصغرى، إذ تفحص هل ستشكل الحافة الجديدة دورة بمقارنة جذري طرفيها. وتستخدم في كشف الدورات في الرسوم غير الموجهة، وإيجاد المكونات المتصلة أثناء إضافة الحواف، ومعالجة الصور لتحديد المناطق المتجاورة، ومسائل الشبكات التي تتغير باستمرار. وتعد من أكثر الهياكل أناقة في علوم الحاسوب لأن فكرتها بسيطة وأداءها شبه مثالي.
مرشح بلوم (Bloom Filter)
مرشح بلوم (Bloom Filter) هو هيكل بيانات احتمالي ابتكره بيرتون بلوم عام 1970 للإجابة عن سؤال هل هذا العنصر موجود في المجموعة؟ باستهلاك ذاكرة ضئيلة جدا. ويتكون من مصفوفة بتات طولها $m$ تبدأ كلها أصفارا، ومن $k$ من دوال التجزئة المستقلة. وعند إضافة عنصر، تحسب دوال التجزئة $k$ موضعا وتضيء البتات المقابلة. وعند السؤال عن عنصر، تحسب المواضع نفسها وتفحصها، فإذا كان أي بت منها صفرا، فالعنصر غير موجود قطعا.
وتكمن خصوصية المرشح في طبيعة إجاباته. فهو لا ينتج سلبيات كاذبة (False Negatives) أبدا، أي إذا قال غير موجود فهو كذلك يقينا. لكنه قد ينتج إيجابيات كاذبة (False Positives)، فقد يقول ربما موجود لعنصر لم يضف أبدا لأن بتاته أضيئت بفعل عناصر أخرى. ويمكن التحكم في نسبة الخطأ بضبط $m$ و$k$، فمثلا تعطي نحو 10 بتات لكل عنصر مع 7 دوال تجزئة نسبة خطأ تقارب 1%. ولا يدعم المرشح التقليدي الحذف، لكن نسخة العداد (Counting Bloom Filter) تعالج ذلك بتكلفة ذاكرة أكبر.
وتستخدم المرشحات في أنظمة تقيس فيها التكلفة بعمليات القرص أو الشبكة. فقواعد البيانات الموزعة مثل Cassandra وHBase وBigtable تسأل المرشح أولا هل يحتوي هذا الملف على المفتاح؟ فتتجنب قراءة ملفات كثيرة غير ضرورية. وتستخدم المتصفحات وأنظمة الأمان المرشحات لفحص قوائم الروابط الخبيثة بسرعة، وتستخدمها الذاكرات المخبئية لتفادي تخزين عناصر تطلب مرة واحدة. وهي مثال ممتاز على أن التنازل عن الدقة المطلقة قد يمنح كفاءة هائلة.
قائمة التخطي (Skip List)
قائمة التخطي (Skip List) هي هيكل احتمالي قدمه ويليام بيو (William Pugh) عام 1990 كبديل أبسط للأشجار المتوازنة. وتبنى من عدة مستويات من القوائم المرتبطة المرتبة، فالمستوى الأدنى يحتوي كل العناصر، وكل مستوى أعلى يحتوي عينة عشوائية من المستوى الذي تحته. وتعمل المستويات العليا كـ طرق سريعة تتخطى أعدادا كبيرة من العناصر، بينما يتيح المستوى الأدنى الوصول الدقيق. وهذا يشبه شبكة المترو التي تجمع بين الخطوط السريعة والمحلية.
ويبدأ البحث من أعلى مستوى في أقصى اليسار، فيتقدم أفقيا ما دام العنصر التالي أصغر من أو يساوي المطلوب، وإذا تجاوزه نزل إلى المستوى الأدنى وتابع. وعند الإدراج، يحدد ارتفاع العنصر الجديد بقذف عملة افتراضية متكررة، فيرتفع مستوى إضافيا باحتمال ثابت مثل النصف أو الربع. وبهذه العشوائية تتحقق تكلفة لوغاريتمية متوقعة $O(\log n)$ للبحث والإدراج والحذف دون أي تدويرات أو إعادة توازن معقدة.
وتتميز قوائم التخطي ببساطة التنفيذ مقارنة بشجرتي AVL وRed-Black، وبسهولة تحويلها إلى نسخ متزامنة (Concurrent)، لأن تعديل الإدراج يمس عددا محدودا من المؤشرات المحلية. ولهذا تستخدم في أنظمة تتطلب تزامنا عاليا، فقواعد بيانات مثل Redis تعتمدها في المجموعات المرتبة (Sorted Sets)، ومحركات التخزين مثل LevelDB وRocksDB تستخدمها في الجداول الذاكرية (MemTable). وتتمثل عيوبها في استهلاك ذاكرة إضافي للمؤشرات المتعددة، وفي أن ضمان الأداء احتمالي وليس حتميا.
متى تحتاج التطبيقات إلى هياكل البيانات المتقدمة؟
تحتاج التطبيقات إلى الهياكل المتقدمة عندما يصبح الهيكل الأساسي عنق زجاجة حقيقيا يمكن قياسه، لا عندما تبدو الفكرة جذابة نظريا. فمعظم التطبيقات تعمل جيدا بالقوائم والقواميس والمجموعات، ولا يستحق التعقيد الإضافي العناء إلا حين يكبر الحجم أو تشتد متطلبات الاستجابة. ومن علامات الحاجة استعلامات نطاق متكررة على بيانات متغيرة، أو ملايين عمليات الدمج والاستعلام عن الاتصال، أو ذاكرة لا تكفي لتخزين المفاتيح كاملة، أو حاجة إلى ترتيب مع تزامن عال.
وينبغي تقييم الخيار بميزان الكلفة والعائد. فالهيكل المتقدم يضيف تعقيدا في الصيانة وصعوبة في التنقيح والحاجة إلى فريق يفهمه، كما أن مكتبات ناضجة توفر كثيرا منها جاهزا ومختبرا، فلا حاجة لتنفيذه من الصفر في الإنتاج. والقاعدة العملية أن تبدأ بأبسط هيكل يلبي المتطلبات، ثم تقيس الأداء الفعلي، ولا تنتقل إلى هيكل متقدم إلا بدليل قياسي. وتلخص النقاط التالية الحالات:
- استعلامات النطاق مع التعديل: شجرة المقاطع أو شجرة فينويك حسب نوع العملية.
- الاتصال الديناميكي ودمج المجموعات: هيكل DSU في خوارزميات الرسوم وكروسكال.
- اختبار الوجود على نطاق ضخم بذاكرة محدودة: مرشح بلوم مع قبول إيجابيات كاذبة نادرة.
- ترتيب مرن مع تزامن عال: قائمة التخطي كبديل عن الأشجار المتوازنة.
مقارنة بين الهياكل المتقدمة واستخداماتها
يلخص الجدول التالي الهياكل المتقدمة الخمسة من حيث الغرض والتكلفة والاستخدام. ويلاحظ أن لكل هيكل مجالا ضيقا يتفوق فيه، ولا يوجد هيكل يغني عن الباقي، وهذا يؤكد أن الاختيار الصحيح يبدأ من فهم المشكلة قبل الأداة:
| الهيكل | الغرض الأساسي | التعقيد الزمني | الذاكرة | أبرز الاستخدامات |
| شجرة المقاطع | استعلامات النطاق مع تعديل العناصر | بناء $O(n)$ واستعلام وتعديل $O(\log n)$ | نحو $4n$ | التحليلات على الفترات والبرمجة التنافسية |
| شجرة فينويك | المجاميع التراكمية مع التعديل | استعلام وتعديل $O(\log n)$ | $n$ فقط | الإحصاءات التراكمية وعد المقلوبات |
| DSU | دمج المجموعات ومعرفة الانتماء | شبه ثابت مطفأ $O(\alpha(n))$ | $n$ | كروسكال والمكونات المتصلة وكشف الدورات |
| مرشح بلوم | اختبار الوجود الاحتمالي | ثابت $O(k)$ | بتات قليلة لكل عنصر | قواعد البيانات الموزعة وفحص الروابط الخبيثة |
| قائمة التخطي | ترتيب مرن وبحث سريع | متوقع $O(\log n)$ | $O(n)$ مع مؤشرات إضافية | Redis وLevelDB والأنظمة المتزامنة |
تحليل كفاءة هياكل البيانات
بعد أن عرفنا الهياكل وأنواعها، يبرز السؤال الأهم عمليا: كيف نقارن بينها بطريقة موضوعية؟ فلا يكفي أن نقول إن هذا الهيكل أسرع من ذاك، لأن السرعة تتغير بحسب حجم البيانات والجهاز واللغة وطبيعة العملية. ولهذا ابتكر علماء الحاسوب لغة رياضية مشتركة لوصف الكفاءة بصرف النظر عن هذه التفاصيل، وهي تحليل التعقيد والترميز لـ Big O. وإتقان هذه اللغة هو ما يميز المبرمج الذي يخمن عن المبرمج الذي يستدل.
ماذا تعني كفاءة هيكل البيانات؟
تعني كفاءة هيكل البيانات قدرته على أداء عملياته الأساسية باستهلاك أقل قدر ممكن من الموارد الحاسوبية، وأهمها الزمن والذاكرة. فالهيكل الكفء هو الذي ينجز الإدراج والبحث والحذف والاجتياز بأقل عدد من الخطوات وأقل مساحة تخزين، مع الحفاظ على هذا المستوى حتى عند نمو البيانات. وتقاس الكفاءة عادة بعدد العمليات الأولية كالمقارنات والنسخ والوصول إلى الذاكرة، وليس بالثواني، لأن الثواني تتأثر بالعتاد والحمل اللحظي.
ولا توجد كفاءة مطلقة، فالكفاءة دائما نسبية للعملية المقاسة. فالمصفوفة كفء جدا في الوصول بالفهرس وضعيفة في الإدراج الأوسط، والقائمة المرتبطة عكس ذلك، وجدول التجزئة كفء في البحث بالمفتاح وعاجز عن الترتيب. ولذلك يجب ربط الكفاءة بنمط الاستخدام المتوقع، فيسأل المطور أي العمليات ستتكرر أكثر، وما حجم البيانات المتوقع، وما القيود على الذاكرة والاستجابة.
وتنقسم الكفاءة إلى بعدين متلازمين هما الكفاءة الزمنية والكفاءة المكانية، ويقايض المصممون بينهما كثيرا. فجداول التجزئة تشتري السرعة بذاكرة إضافية، والضغط يشتري الذاكرة بوقت إضافي للفك، ومرشح بلوم يشتري الذاكرة بدقة أقل. ويمثل فهم هذه المقايضات جوهر الهندسة الجيدة، فلا يوجد حل مجاني وإنما حل مناسب للقيود المعطاة.
التعقيد الزمني (Time Complexity)
التعقيد الزمني (Time Complexity) هو دالة تصف كيف يتزايد عدد الخطوات التي تنفذها العملية بتزايد حجم المدخلات n. فهو لا يخبرنا بعدد الثواني الفعلي، بل بمعدل النمو عند تضخم البيانات. فإذا كانت عملية تحتاج إلى خطوة واحدة مهما كبر n فتعقيدها ثابت، وإذا تضاعفت خطواتها بتضاعف n فتعقيدها خطي، وإذا تضاعفت أربع مرات بتضاعف n فتعقيدها تربيعي. وهذا المعيار هو أصدق مؤشر على قابلية التوسع.
ويحسب التعقيد الزمني بعد عد العمليات المهيمنة في الخوارزمية، وهي عادة الحلقات والاستدعاءات العودية. فحلقة واحدة على n عنصرا تعطي O(n)، وحلقتان متداخلتان تعطيان O(n²)، وحلقة تقسم المدخل إلى نصفين في كل تكرار تعطي O(log n). وتهمل الثوابت والحدود الأدنى لأنها لا تؤثر في النمو عند القيم الكبيرة، فالعبارة 3n² + 5n + 20 تختزل إلى O(n²).
ويفسر التعقيد الزمني الفروق الكبيرة بين الهياكل عند الحجوم الضخمة. فالبحث الخطي في مليار عنصر يتطلب مليار خطوة في أسوأ الحالات، بينما يتطلب البحث الثنائي ثلاثين خطوة فقط، وجدول التجزئة خطوة واحدة تقريبا. وهذا التفاوت هو الذي يجعل بعض التطبيقات تستجيب في أجزاء من الثانية وبعضها يتجمد، ولذلك يقدم هذا التحليل على أي تحسين ميكروي للشيفرة.
التعقيد المكاني (Space Complexity)
التعقيد المكاني (Space Complexity) هو مقدار الذاكرة التي يحتاجها الهيكل أو الخوارزمية كدالة في حجم المدخلات. ويشمل الذاكرة التي تشغلها البيانات نفسها، والذاكرة الإضافية المساعدة (Auxiliary Space) التي تحتاجها العمليات أثناء التنفيذ كالمصفوفات المؤقتة وسجلات الاستدعاء العودي. فالمصفوفة التي تضم n عنصرا تستهلك O(n)، وترتيب الكومة يحتاج ذاكرة مساعدة ثابتة O(1)، بينما الترتيب بالدمج يحتاج O(n) إضافية.
وتتفاوت الهياكل في الحمل الإضافي (Overhead) الذي تفرضه فوق البيانات الخام. فالمصفوفة لا تضيف حملا يذكر، والقائمة المرتبطة تضيف مؤشرا أو اثنين لكل عنصر، وجدول التجزئة يضيف حاويات فارغة ومساحة احتياطية لعامل التحميل، والأشجار تضيف مؤشرات الأبناء ومعلومات التوازن. وفي اللغات عالية المستوى تضاف ترويسات الكائنات والمراجع، فتكلف قائمة Python من أعداد صحيحة أضعاف ما تكلفه مصفوفة C مكافئة.
وتصبح الذاكرة المحرك الأول للقرار في ثلاث حالات رئيسية. الأولى الأنظمة المدمجة والأجهزة المحدودة حيث تقاس الذاكرة بالكيلوبايتات، والثانية البيانات الضخمة التي لا تتسع في الذاكرة فيلزم ضغطها أو تقسيمها، والثالثة التطبيقات الحساسة للذاكرة المخبئية حيث يحدد التجاور السرعة أكثر من عدد الخطوات. وفي كل ذلك يجب قياس الاستهلاك الفعلي وعدم الاكتفاء بالتحليل النظري.
فهم ترميز Big O بصورة مبسطة
ترميز Big O هو الأداة الرياضية التي نصف بها الحد الأعلى لمعدل نمو دالة التعقيد عندما يكبر n كثيرا. وتعريفه الرسمي أن الدالة f(n) تنتمي إلى O(g(n)) إذا وجد ثابتان موجبان c وn₀ بحيث يكون f(n) أقل من أو يساوي c·g(n) لكل n أكبر من n₀. ومعنى ذلك ببساطة أن الدالة لن تنمو أسرع من g مهما كبر المدخل، ما عدا ثابتا مضروبا. فهو يعطي سقفا مضمونا للأداء وليس قياسا دقيقا.
ويمكن تبسيط الفكرة بتشبيه عملي. تخيل أنك تبحث عن اسم في دليل هاتف. فإذا قرأته من أوله اسما اسما فكلما تضاعف الدليل تضاعف جهدك وهذا O(n). وإذا فتحته من المنتصف واستبعدت نصفا في كل مرة فتضاعف الدليل يضيف خطوة واحدة فقط وهذا O(log n). وإذا كان لديك فهرس يدلك على الصفحة مباشرة فالجهد ثابت وهذا O(1). فـ Big O يلخص كيف يتغير جهدك عند تغير حجم الدليل.
وللترميز قواعد مبسطة تساعد على استخلاصه بسرعة. أولها إهمال الثوابت، فـ O(2n) هي O(n). وثانيها الاحتفاظ بأكبر حد فقط، فـ O(n² + n) هي O(n²). وثالثها جمع الخطوات المتتابعة وضرب الخطوات المتداخلة، فحلقتان متتاليتان تعطيان O(n + m) وحلقتان متداخلتان تعطيان O(n × m). ورابعها أن O تصف الحد الأعلى أما Ω فتصف الحد الأدنى وΘ تصف الحد الدقيق عندما يتطابق الحدان.
الفرق بين O(1) وO(log n) وO(n) وO(n log n) وO(n²)
تمثل هذه الرتب الخمس أكثر أنماط النمو شيوعا في هياكل البيانات والخوارزميات، ويكفي إتقان دلالاتها لفهم معظم المقارنات العملية. وتتضح الفروق بينها عند تطبيقها على حجم كبير مثل مليون عنصر، حيث تتحول أرقام متقاربة عند الأحجام الصغيرة إلى فجوات هائلة. ويلخص الجدول التالي كل رتبة مع مثال مألوف وعدد الخطوات التقريبي عند n يساوي مليونا:
| الرتبة | الاسم | عدد الخطوات عند n = 1,000,000 | مثال على عملية |
|---|---|---|---|
| O(1) | ثابت | خطوة واحدة | الوصول إلى عنصر بالفهرس أو قراءة قمة المكدس |
| O(log n) | لوغاريتمي | نحو 20 خطوة | البحث الثنائي أو البحث في شجرة متوازنة |
| O(n) | خطي | مليون خطوة | البحث الخطي أو المرور على قائمة |
| O(n log n) | خطي لوغاريتمي | نحو 20 مليون خطوة | الترتيب بالدمج أو ترتيب الكومة |
| O(n²) | تربيعي | تريليون خطوة | الترتيب بالفقاعات أو مقارنة كل زوج |
أفضل حالة ومتوسط الحالة وأسوأ حالة
يختلف أداء العملية الواحدة بحسب طبيعة المدخلات، ولذلك يحلل التعقيد في ثلاث حالات. فأفضل حالة (Best Case) هي المدخل الذي تنجز العملية معه بأقل جهد، كأن يكون العنصر المطلوب في أول موضع في البحث الخطي فيكلف خطوة واحدة. وأسوأ حالة (Worst Case) هي المدخل الذي يستنفد أكبر جهد، كأن يكون العنصر في آخر موضع أو غائبا فيكلف n خطوة. ومتوسط الحالة (Average Case) هو الأداء المتوقع على مدخلات موزعة بصورة عشوائية.
ويركز المحللون غالبا على أسوأ حالة لأنها تعطي ضمانا لا يمكن تجاوزه، وهو أمر حاسم في الأنظمة الحرجة كأنظمة الملاحة والتحكم الطبي والأنظمة الفورية. ويلجأ إلى المتوسط عندما تكون أسوأ حالة نادرة جدا ويمكن تجنبها عمليا، كما في الترتيب السريع (Quick Sort) الذي يبلغ متوسطه O(n log n) وأسوأ حالاته O(n²) لكنها تتفادى باختيار محور عشوائي. وتوجد كذلك التكلفة المطفأة (Amortized) التي توزع تكلفة العمليات النادرة المكلفة على سلسلة العمليات كلها.
وتظهر أمثلة الفروق بين الحالات في الهياكل التي ناقشناها. فـجدول التجزئة يبحث في المتوسط بزمن O(1) وفي أسوأ الحالات بزمن O(n) عند تكدس التصادمات. وشجرة البحث الثنائية غير المتوازنة تبحث في المتوسط بزمن O(log n) وفي أسوأ الحالات بزمن O(n) عند تحولها إلى سلسلة. والمصفوفة الديناميكية تضيف في النهاية بزمن مطفأ O(1) وإن كلفت عملية التوسع المنفردة O(n). فالنظر إلى الحالات الثلاث معا يعطي صورة أصدق من رقم واحد.
مقارنة كفاءة العمليات الأساسية في هياكل البيانات
يجمع الجدول التالي التعقيد الزمني للعمليات الأساسية في أشهر الهياكل، وهو مرجع سريع يغني عن حفظ الأرقام المتفرقة. وتشير القيم إلى المتوسط ما لم يذكر غير ذلك، ويفترض في القائمة المرتبطة أن موضع الإدراج أو الحذف معلوم مسبقا. ويجب قراءة الجدول مع ملاحظة أن الثوابت المخفية والذاكرة المخبئية قد تقلب الترتيب عمليا عند الأحجام المتوسطة.
| الهيكل | الوصول | البحث | الإدراج | الحذف | ملاحظات |
|---|---|---|---|---|---|
| المصفوفة | O(1) | O(n) | O(n) | O(n) | الإضافة في النهاية مطفأة O(1) |
| القائمة المرتبطة | O(n) | O(n) | O(1) | O(1) | بعد الوصول إلى الموضع |
| المكدس | O(n) | O(n) | O(1) | O(1) | Push وPop عند القمة |
| الطابور | O(n) | O(n) | O(1) | O(1) | Enqueue وDequeue |
| جدول التجزئة | لا ينطبق | O(1) متوسطا | O(1) متوسطا | O(1) متوسطا | أسوأ حالة O(n) |
| شجرة BST متوازنة | O(log n) | O(log n) | O(log n) | O(log n) | AVL وRed-Black |
| الكومة | الجذر O(1) | O(n) | O(log n) | O(log n) | استخراج الأصغر O(log n) |
| الرسم بقائمة التجاور | الجيران O(درجة الرأس) | O(V + E) | O(1) | O(درجة الرأس) | الذاكرة O(V + E) |
لماذا لا تكفي سرعة العملية وحدها للحكم على أفضل هيكل بيانات؟
لا تكفي سرعة العملية النظرية وحدها لأن Big O يصف معدل النمو وليس الزمن الفعلي. فهو يهمل الثوابت المضروبة في كل عملية، وقد يكون الثابت في خوارزمية O(n) أصغر بكثير من ثابت خوارزمية O(log n) فتتفوق الأولى عمليا عند الأحجام المتوسطة. وهذا ما يفسر لماذا قد تتفوق المصفوفة على الشجرة في البحث عند بضع مئات من العناصر، ولماذا يستخدم كثير من المكتبات الترتيب بالإدراج للمصفوفات الصغيرة رغم تعقيده التربيعي.
وتتدخل عوامل عتادية وبرمجية أخرى تغير الصورة. فـالذاكرة المخبئية تجعل المرور على مصفوفة متجاورة أسرع بأضعاف من المرور على قائمة مرتبطة رغم تساوي التعقيد النظري. وتكلفة تخصيص الذاكرة وتحريرها قد تطغى على كلفة العملية نفسها. كما أن توزيع البيانات الفعلي يهم، فالبيانات شبه المرتبة قد تحول شجرة غير متوازنة إلى سلسلة، والبيانات ذات المفاتيح المتشابهة قد تكدس التصادمات في جدول التجزئة.
وهناك اعتبارات هندسية تتجاوز السرعة كلها. فـالبساطة وسهولة الصيانة والاختبار قد تفوق ميزة سرعة ضئيلة، ودعم التزامن وسلامة الخيوط قد يحدد الاختيار، وضمانات الأسوأ حالة قد تهم أكثر من المتوسط، وحجم الذاكرة قد يمنع استخدام هيكل سريع لكنه شره. ولذلك يتبع المحترفون منهجا ثلاثي الخطوات: يحللون التعقيد النظري لاستبعاد الخيارات الضعيفة، ثم يقيسون الأداء الفعلي على بيانات حقيقية للمفاضلة بين المتبقي، ثم يختارون الأبسط صيانة عند تقارب النتائج.
كيف تختار هيكل البيانات المناسب؟
يصل كل مبرمج عاجلا أو آجلا إلى لحظة القرار، حين يقف أمام مشكلة جديدة ويسأل نفسه أي هيكل بيانات يستحق أن يبني عليه حله. وتكمن صعوبة هذا القرار في أنه لا يوجد هيكل أفضل في المطلق، فكل هيكل هو مقايضة محسوبة بين السرعة والذاكرة والمرونة وبساطة التنفيذ. والخبير الحقيقي لا يحفظ جدولا جاهزا للإجابات، بل يمتلك منهجا ذهنيا يحول أسئلة المشكلة إلى معايير اختيار واضحة. وفي هذا القسم سنبني هذا المنهج خطوة بخطوة، من تحليل طبيعة البيانات إلى تجنب الأخطاء الشائعة التي تكلف المشاريع وقتا وجهدا كبيرين.
تحديد طبيعة البيانات وطريقة استخدامها
تبدأ كل عملية اختيار سليمة بسؤال أساسي هو ماذا نخزن بالضبط وكيف سنتعامل معه. فيجب أولا أن تحدد شكل البيانات، هل هي قيم مفردة متتابعة كـقراءات الحساسات، أم أزواج مفتاح وقيمة كـبيانات المستخدمين، أم علاقات هرمية كهيكل المجلدات، أم شبكة علاقات حرة كـالصداقات. وهذا التصنيف الأولي يضيق دائرة الخيارات فورا، فالبيانات الهرمية تستدعي الأشجار، والبيانات المترابطة تستدعي الرسوم البيانية، والبيانات المفهرسة بالأسماء تستدعي القواميس. فمن يفهم شكل بياناته يكون قد قطع نصف الطريق نحو الاختيار الصحيح.
ثم تأتي طريقة الاستخدام وهي العامل الأكثر حسما. فيجب أن تحصي العمليات التي سيجريها البرنامج على البيانات، وتقدر تكرار كل عملية. فإذا كانت القراءة تفوق الكتابة بنسبة مئة إلى واحد، فاختر هيكلا يسرع القراءة ولو أبطأ الكتابة، كـ المصفوفة المرتبة مع البحث الثنائي. وإذا كانت الإضافات والحذف تتكرر في المنتصف باستمرار، فـ الهياكل المرتبطة أنسب. وإذا كان البحث بالمفتاح هو العملية المهيمنة، فـ جدول التجزئة هو الخيار الطبيعي. ولا يمكن تقدير هذه النسب بدقة دون فهم سيناريوهات الاستخدام الفعلية.
وينبغي أن تضيف إلى التحليل حجم البيانات المتوقع ومعدل نموها. فالفرق بين مئة عنصر ومئة مليون يقلب ترتيب الأفضلية بالكامل، إذ تتفوق المصفوفة البسيطة عند الأحجام الصغيرة لقلة الحمل الإضافي، بينما يفرض التضخم الكبير هياكل لوغاريتمية أو تجزئة. ويجب أن تسأل أيضا هل البيانات ثابتة تحمل مرة واحدة وتقرأ كثيرا، أم ديناميكية تتغير باستمرار، وهل يصل إليها خيط واحد أم خيوط متعددة. فكل إجابة من هذه الأسئلة تسقط بعض الخيارات وترفع أخرى، حتى يتبقى هيكل أو اثنان يستحقان التجربة.
الاختيار بناء على سرعة البحث والإضافة والحذف
تمثل سرعة البحث والإضافة والحذف المثلث الكلاسيكي الذي تبنى عليه أغلب قرارات الاختيار، ونادرا ما يتفوق هيكل في الثلاثة معا. فـ جدول التجزئة يقدم بحثا وإضافة وحذفا بزمن متوسط ثابت لكنه يخسر الترتيب. والشجرة المتوازنة تقدم الثلاثة بزمن لوغاريتمي مع حفظ الترتيب، لكنها أبطأ من التجزئة في المتوسط. والمصفوفة تقدم الوصول الفوري لكنها تدفع ثمن الإدراج والحذف. والقائمة المرتبطة تقدم إدراجا وحذفا سريعين لكنها تعجز عن البحث والوصول السريعين.
ولذلك يجب ترجيح العملية الأكثر حساسية لـ أداء التطبيق وليس الأكثر تكرارا فقط. فقد تكون عملية نادرة لكنها تقع على المسار الحرج الذي ينتظره المستخدم مباشرة، فيجب تحسينها أولا. فمثلا نظام الدفع يجب أن يتحقق من صحة الطلب بسرعة فائقة حتى لو كانت الإضافة أبطأ. وكذلك تتفاوت الأولويات بين أنظمة القراءة الثقيلة كـالموسوعات وأنظمة الكتابة الثقيلة كـسجلات الأحداث، ولكل نمط هياكله المفضلة.
وتفيد القواعد العملية التالية في الاختيار السريع قبل التعمق. فإذا احتجت إلى بحث بالمفتاح فقط فاستخدم جدول التجزئة، وإذا احتجت إلى بحث مع ترتيب أو نطاقات فاستخدم شجرة متوازنة، وإذا احتجت إلى أصغر أو أكبر عنصر مرارا فاستخدم الكومة، وإذا احتجت إلى عدالة الدور فاستخدم الطابور، وإذا احتجت إلى التراجع فاستخدم المكدس. وتبقى هذه القواعد نقطة بداية وليست حكما نهائيا، فالقياس الفعلي هو الفيصل عند تقارب الخيارات.
الاختيار بناء على استهلاك الذاكرة
يعد استهلاك الذاكرة معيارا حاسما في مواقف كثيرة يتجاهله المبتدئون. فالهياكل تختلف في حملها الإضافي (Overhead) اختلافا كبيرا، فـ المصفوفة تخزن القيم متجاورة بلا إضافات تقريبا، بينما تضيف القائمة المرتبطة مؤشرا أو اثنين لكل عنصر، وتضيف الشجرة مؤشري الأبناء ومعلومات التوازن، ويحتفظ جدول التجزئة بمساحة احتياطية تحافظ على عامل التحميل المنخفض. وعندما تخزن ملايين القيم الصغيرة، قد يتجاوز الحمل الإضافي حجم البيانات نفسها بأضعاف.
وتزداد أهمية الذاكرة مع اللغات عالية المستوى التي تغلف كل قيمة في كائن. فـ قائمة Python من مليون عدد صحيح تخزن مليون مرجع يشير كل منها إلى كائن مستقل، فتستهلك أضعاف ما تستهلكه مصفوفة مكافئة في C أو في مكتبة NumPy. ولهذا يلجأ المطورون في الحسابات الضخمة إلى مصفوفات متجانسة مدمجة أو إلى مصفوفات البتات (Bit Arrays) أو إلى الهياكل الاحتمالية كـ مرشح بلوم لتقليص الحجم بنسبة كبيرة.
ولا يتعلق الأمر بالحجم وحده بل بـ نمط الوصول إلى الذاكرة أيضا. فـ الهياكل المتجاورة تستفيد من الذاكرة المخبئية فتقلل زمن الانتظار الفعلي، بينما تتسبب الهياكل المتناثرة في إخفاقات متكررة للذاكرة المخبئية (Cache Misses). ويجب أيضا حساب ذروة الاستهلاك أثناء العمليات المؤقتة، فـ توسع المصفوفة الديناميكية أو إعادة تجزئة الجدول تتطلب مؤقتا ضعف الذاكرة تقريبا، وهو ما قد يسقط النظام إذا كان الهامش ضيقا.
الاختيار بناء على ترتيب البيانات وإمكانية تكرار العناصر
يحدد الترتيب المطلوب للبيانات عائلة الهياكل المناسبة. فإذا كان ترتيب الإدراج مهما وتريد استرجاع العناصر بالترتيب نفسه، فـ القوائم والطوابير هي الخيار. وإذا كان الترتيب حسب قيمة العنصر مهما (مرتبا تصاعديا أو تنازليا)، فـ الأشجار المتوازنة أو المصفوفة المرتبة أو القوائم المرتبة هي الأنسب. وإذا لم يكن الترتيب مهما أبدا، فـ جداول التجزئة والمجموعات تقدم أفضل سرعة. وبعض التنفيذات توفر حلا وسطا كـ LinkedHashMap في Java و dict في Python اللذين يحفظان ترتيب الإدراج مع سرعة التجزئة.
أما التكرار فيحدد الخيار بين المجموعات وغيرها. فإذا كانت العناصر يجب أن تكون فريدة كأسماء المستخدمين ومعرفات الجلسات، فـ المجموعة (Set) تفرض هذا القيد تلقائيا وتغنيك عن فحص يدوي يكلف زمنا. وإذا كان التكرار مقبولا أو مطلوبا كتخزين سجل المشتريات حيث يتكرر المنتج، فـ القوائم والمصفوفات أنسب. وإذا أردت عد التكرارات نفسها فـ القاموس الذي يربط العنصر بعدد مرات ظهوره هو الحل الأمثل، وتوفر Python فئة Counter لهذا الغرض.
ويظهر التداخل بين المعيارين في حالات واقعية كثيرة. فـ لوحة المتصدرين تحتاج ترتيبا بحسب النقاط وتقبل تكرار النقاط بين لاعبين، فتناسبها الأشجار المتوازنة أو قوائم التخطي مع مفتاح مركب. وقائمة المهام تحتاج أولوية وتقبل تكرار الأولويات، فتناسبها الكومة أو طابور الأولوية مع كسر التعادل بالأسبقية. ويجب الانتباه إلى سلوك الهيكل عند التكرار، فبعض الأشجار تتجاهل المفتاح المكرر أو تستبدل قيمته، وهذا قد يسبب فقدانا صامتا للبيانات إن لم يكن مقصودا.
اختيار هيكل البيانات حسب طبيعة التطبيق البرمجي
تفرض طبيعة التطبيق أنماط استخدام متكررة تقود إلى خيارات مألوفة. ففي تطبيقات الويب تكثر عمليات البحث بالمفتاح والتخزين المؤقت وإدارة الجلسات، فتهيمن القواميس وجداول التجزئة. وفي أنظمة المعالجة المتسلسلة كمعالجة الطلبات والرسائل تهيمن الطوابير. وفي تطبيقات التحرير والتصميم التي تدعم التراجع تهيمن المكدسات، وفي تطبيقات الخرائط والتواصل الاجتماعي تهيمن الرسوم البيانية، وفي محركات البحث والإكمال التلقائي تهيمن أشجار Trie والفهارس المعكوسة.
وتجدر الإشارة إلى أن التطبيق الواحد يستخدم عادة عدة هياكل معا، فلا تبحث عن هيكل واحد يخدم كل شيء. فـ نظام التجارة الإلكترونية قد يستخدم قاموسا لسلة المشتريات، وكومة لترتيب الطلبات بحسب الأولوية، ورسما بيانيا لتوصية المنتجات، وشجرة +B داخل قاعدة بياناته لفهرسة الجداول. والمهم أن يختار المطور لكل مكون الهيكل المناسب لنمط استخدامه الخاص، وأن يوازن ذلك مع تعقيد التصميم الكلي. وتساعد النقاط التالية على ربط التطبيق بالخيار الأولي:
- تطبيقات الويب والخدمات: القواميس وجداول التجزئة لـ التخزين المؤقت والجلسات والبحث بالمعرف.
- أنظمة الرسائل والمعالجة الخلفية: الطوابير وطوابير الأولوية لـ تنظيم المهام وضمان العدالة.
- المحررات والأدوات الإبداعية: المكدسات لـ التراجع والإعادة والقوائم ثنائية الاتجاه للسجلات.
- الخرائط والشبكات الاجتماعية: الرسوم البيانية بقوائم التجاور مع خوارزميات المسارات.
- البحث والنصوص: أشجار Trie والفهارس المعكوسة لـ الإكمال التلقائي واسترجاع المعلومات.
أمثلة عملية لاختيار الهيكل المناسب في مواقف مختلفة
يلخص الجدول التالي مجموعة من المواقف البرمجية الشائعة مع الهيكل الأنسب لكل منها وسبب الاختيار. ويجب التعامل معه كمرشد للتفكير وليس كوصفة جامدة، فتغير الحجم أو القيود قد يبدل الاختيار:
| الموقف | الهيكل الأنسب | سبب الاختيار |
| التحقق من تكرار اسم المستخدم أثناء التسجيل | المجموعة (Set) أو جدول التجزئة | اختبار وجود بزمن متوسط ثابت وبلا حاجة إلى ترتيب |
| زر التراجع في محرر نصوص | المكدس (Stack) | آخر تعديل هو أول ما يلغى حسب LIFO |
| طابور طباعة المستندات | الطابور (Queue) | خدمة عادلة بحسب الوصول FIFO |
| جدولة المهام بحسب الأولوية | الكومة (Heap) | استخراج الأعلى أولوية بزمن لوغاريتمي |
| قائمة تضم عددا ثابتا من القيم تقرأ بالفهرس | المصفوفة (Array) | وصول فوري وذاكرة متجاورة وبساطة |
| قائمة تتغير كثيرا بالإدراج والحذف في المنتصف | القائمة المرتبطة (Linked List) | تعديل المؤشرات دون إزاحة العناصر |
| قاموس مرتب مع استعلامات النطاق | شجرة متوازنة (Red-Black أو +B) | ترتيب محفوظ وبحث وإدراج لوغاريتمي |
| الإكمال التلقائي لكلمات البحث | شجرة Trie | بحث بالبادئات بزمن يعتمد على طول الكلمة |
| أقصر طريق بين مدينتين | رسم بياني موزون مع كومة | خوارزمية ديكسترا على قائمة تجاور مع طابور أولوية |
| فحص وجود عنصر في مليارات السجلات بذاكرة ضئيلة | مرشح بلوم (Bloom Filter) | ذاكرة صغيرة مع قبول إيجابيات كاذبة نادرة |
أخطاء شائعة عند اختيار هياكل البيانات
يقع كثير من المطورين في أخطاء متكررة عند الاختيار تكلفهم أداء وصيانة. أشهرها الاستخدام المفرط للقوائم لكل شيء، فالبحث المتكرر داخل قائمة كبيرة بحثا خطيا يحول برنامجا سريعا إلى بطيء جدا، ويكفي غالبا تحويل القائمة إلى مجموعة أو قاموس لتحسين الأداء بدرجات. والخطأ المعاكس هو التعقيد المبكر، فاستخدام شجرة متوازنة أو هيكل متقدم لبيانات لا تتجاوز عشرات العناصر يضيف تعقيدا لا مبرر له.
ومن الأخطاء كذلك تجاهل حجم البيانات المستقبلي، فحل يعمل ممتازا اليوم على ألف سجل قد ينهار غدا على ملايين السجلات. وكذلك الاعتماد على التعقيد النظري دون قياس، أو نسيان حالة أسوأ السيناريوهات كإدخال بيانات مرتبة في شجرة غير متوازنة، أو استخدام مفاتيح قابلة للتغيير في جدول تجزئة فتضيع العناصر. كما يتجاهل البعض سلامة الخيوط (Thread Safety) عند مشاركة الهيكل بين عدة خيوط، فتظهر أخطاء سباق (Race Conditions) يصعب تتبعها. وأبرز هذه الأخطاء ما يلي:
- استخدام القائمة للبحث المتكرر بدل المجموعة أو القاموس مما يسبب تكلفة خطية في كل عملية.
- التعقيد المبكر باختيار هياكل متقدمة لبيانات صغيرة لا تستفيد منها.
- إهمال نمو البيانات وافتراض أن الحجم الحالي ثابت للأبد.
- الاكتفاء بالتحليل النظري دون قياس الأداء الفعلي على بيانات واقعية.
- تجاهل التزامن عند مشاركة الهيكل بين خيوط متعددة دون حماية.
الفرق بين هياكل البيانات وقواعد البيانات ومراكز البيانات
تتشابه الأسماء في هذا الموضوع تشابها مربكا، فهياكل البيانات وقواعد البيانات ومراكز البيانات ثلاثة مصطلحات تشترك في كلمة بيانات لكنها تعمل في ثلاث طبقات مختلفة تماما من عالم الحاسوب. ويخلط كثير من المبتدئين وبعض غير المتخصصين بينها، فيظنون أن قاعدة البيانات هي هيكل بيانات كبير، أو أن مركز البيانات مكان تخزن فيه الهياكل. وسنفصل في هذا القسم الفروق بينها ونوضح كيف تتكامل في الأنظمة الحديثة كأنها طبقات متراصة، تبدأ من البنية المادية وتنتهي بـ الذاكرة والمؤشرات.
الفرق بين هياكل البيانات (Data Structures) وقواعد البيانات (Databases)
هياكل البيانات (Data Structures) هي تقنيات تنظيم البيانات داخل ذاكرة البرنامج (RAM) أثناء تشغيله، وتعيش غالبا في الذاكرة الرئيسية وتزول بانتهاء البرنامج. أما قاعدة البيانات (Database) فهي نظام متكامل لـ تخزين البيانات بصورة دائمة وإدارتها والاستعلام عنها، ويتولى إدارتها برنامج متخصص يسمى نظام إدارة قواعد البيانات (DBMS) مثل MySQL و PostgreSQL و MongoDB. فالأولى أداة برمجية يستخدمها المطور داخل شيفرته، والثانية خدمة مستقلة تحفظ البيانات على الأقراص (Storage) وتدير الوصول إليها.
ويختلف المفهومان في الغاية والنطاق. فهدف هيكل البيانات هو تسريع العمليات الحسابية على البيانات أثناء معالجتها، ويعمل على مستوى العناصر والعقد. أما هدف قاعدة البيانات فهو الاحتفاظ بالبيانات وحمايتها ومشاركتها بين عدة مستخدمين وتطبيقات، ويعمل على مستوى الجداول والسجلات والمعاملات. وتوفر قواعد البيانات مزايا لا تملكها الهياكل، كـ المتانة (Durability) وضمان خصائص ACID للمعاملات والتحكم بالتزامن والصلاحيات والنسخ الاحتياطي والتعافي من الأعطال.
ولا يعني ذلك أن إحداهما تغني عن الأخرى، فالمطور يستخدمهما معا في التطبيق الواحد. فيقرأ البيانات من القاعدة ويحملها في هياكل داخل الذاكرة كـ القوائم والقواميس ليعالجها بسرعة، ثم يعيد حفظ النتائج في القاعدة. ومن الأخطاء الشائعة محاولة استخدام قاموس في الذاكرة بديلا عن قاعدة بيانات فتضيع البيانات عند إعادة التشغيل، أو استخدام قاعدة بيانات لتخزين قيم مؤقتة سريعة التغير فيتباطأ النظام دون داع.
مقارنة بين هياكل البيانات وقواعد البيانات
يوضح الجدول التالي أوجه الاختلاف في التعريف والهدف وطريقة تنظيم البيانات ومكان التخزين ومدة الاحتفاظ بالبيانات وأمثلة الاستخدام. ويجب ملاحظة أن أنظمة إدارة قواعد البيانات نفسها تستخدم هياكل بيانات داخلية مثل أشجار +B وجداول التجزئة وقوائم التخطي وأشجار LSM، فهي مبنية فوق الهياكل وليست بديلا عنها:
| وجه المقارنة | هياكل البيانات (Data Structures) | قواعد البيانات (Databases) |
|---|---|---|
| التعريف | أساليب لتنظيم البيانات داخل ذاكرة البرنامج | أنظمة لتخزين البيانات وإدارتها والاستعلام عنها |
| الهدف | تسريع المعالجة والعمليات الحسابية | حفظ البيانات وحمايتها ومشاركتها |
| طريقة التنظيم | عقد ومؤشرات ومصفوفات وأشجار ورسوم | جداول وسجلات وحقول أو مستندات أو رسوم بيانية |
| مكان التخزين | الذاكرة الرئيسية RAM غالبا | الأقراص والتخزين الدائم مع ذاكرة مخبئية |
| مدة الاحتفاظ بالبيانات | مؤقتة تنتهي بانتهاء البرنامج | دائمة تبقى بعد إيقاف النظام |
| المستخدمون | برنامج واحد عادة وخيوطه | عدة مستخدمين وتطبيقات في آن واحد |
| الضمانات | لا توفر ضمانات متانة أو معاملات | خصائص ACID ونسخ احتياطي وصلاحيات |
| أمثلة الاستخدام | قائمة مهام أو قاموس مؤقت أو شجرة بحث | قاعدة عملاء أو سجل طلبات أو كتالوج منتجات |
| العلاقة | تستخدم داخل نظام قاعدة البيانات نفسه كفهارس | تستخدم الهياكل داخليا لتنفيذ عملياتها |
كيف ترتبط هياكل البيانات بقواعد البيانات؟
ترتبط الهياكل بالقواعد ارتباطا بنيويا عميقا، فكل نظام قاعدة بيانات ناجح هو في جوهره مجموعة ذكية من الهياكل تعمل خلف واجهة استعلام مريحة. فـ الفهارس (Indexes) التي تسرع الاستعلامات تبنى غالبا كـ أشجار +B في MySQL InnoDB و PostgreSQL و Oracle، وتبنى أحيانا كـ جداول تجزئة للبحث بالمساواة. وتستخدم محركات التخزين الحديثة مثل RocksDB و Cassandra بنية LSM Tree التي تجمع جداول ذاكرية مبنية على قوائم التخطي أو الأشجار مع ملفات مرتبة على القرص ومرشحات بلوم لتجنب قراءة الملفات غير اللازمة.
وتمتد العلاقة إلى مكونات أخرى في القاعدة. فـ ذاكرة التخزين المؤقت للصفحات (Buffer Pool) تعتمد على جداول تجزئة وقوائم مرتبطة لتطبيق سياسة LRU في إخلاء الصفحات. ومحسن الاستعلامات (Query Optimizer) يمثل خطط التنفيذ كـ أشجار ويبحث فيها عن أرخص خطة. ومدير المعاملات يستخدم رسم بياني للانتظار (Wait-for Graph) لاكتشاف الجمود (Deadlocks). وحتى قواعد البيانات داخل الذاكرة كـ Redis تقدم الهياكل نفسها للمستخدم مباشرة كـ القوائم والمجموعات والقواميس والمجموعات المرتبة والمكدسات.
ويفسر هذا الارتباط فائدة فهم الهياكل لمن يعمل مع قواعد البيانات. فمن يعرف كيف تعمل شجرة +B يفهم لماذا يسرع الفهرس الاستعلام على عمود معين، ولماذا يبطئ الكتابة قليلا، ولماذا لا يفيد عند البحث بنمط يبدأ بحرف شامل، ولماذا يؤثر ترتيب الأعمدة في الفهرس المركب. وبذلك يتحول ضبط الأداء من تجربة عشوائية إلى قرار مبني على معرفة بـ البنية الداخلية للنظام.
الفرق بين هياكل البيانات (Data Structures) ومراكز البيانات (Data Centers)
تختلف مراكز البيانات (Data Center) عن الهياكل اختلافا جذريا، فهو منشأة مادية حقيقية تضم الخوادم ومعدات التخزين والشبكات وأنظمة الطاقة والتبريد والحماية والمراقبة، تستضيف التطبيقات والخدمات على مدار الساعة. ويقوم عليه مهندسو بنية تحتية وشبكات وكهرباء، وتقاس جودته بـ التوافرية والأمان وكفاءة استهلاك الطاقة. فهو مبنى وأجهزة وكابلات، بينما هيكل البيانات فكرة برمجية تنظم قيما داخل ذاكرة جهاز ما.
وتتجلى المفارقة في اختلاف المستوى بين المفهومين. فـ مركز البيانات يوفر بيئة التشغيل الفيزيائية التي تحتاجها الأنظمة، أي المعالجات والذاكرة والأقراص والاتصال بالإنترنت والكهرباء المستقرة. أما هيكل البيانات فهو قاعدة تنظيم تطبق داخل برنامج يعمل على أحد تلك الخوادم. وقد يعمل البرنامج نفسه بنفس الهياكل على حاسوب محمول أو داخل مركز بيانات عملاق، فلا يتغير المنطق وإنما يتغير حجم الموارد المتاحة ومستوى التوافرية.
وتتباين الأهداف كذلك. فـ مركز البيانات يسعى إلى الاستمرارية والأمان والقابلية للتوسع ويستخدم التكرار (Redundancy) في الطاقة والشبكة والتخزين لتفادي نقاط الفشل الوحيدة. وتصنف مراكز البيانات عادة في مستويات (Tiers) بحسب التوافرية والتكرار المتاح. أما هيكل البيانات فيسعى إلى الكفاءة الحسابية في الزمن والذاكرة ويحسب بـ التعقيد Big O. فمعيار النجاح في الأول نسبة التشغيل المستمر، وفي الثاني عدد الخطوات المطلوبة لكل عملية.
مقارنة بين هياكل البيانات ومراكز البيانات
يوضح الجدول التالي الفرق بين المفهومين من حيث الطبيعة والهدف والمكونات ومكان العمل ونطاق التأثير وأمثلة الاستخدام. ويبرز الفرق الأساسي بين تنظيم البيانات برمجيا داخل التطبيقات وتوفير البنية التحتية اللازمة لتشغيل الأنظمة كلها:
| وجه المقارنة | هياكل البيانات (Data Structures) | مراكز البيانات (Data Centers) |
|---|---|---|
| الطبيعة | مفهوم برمجي منطقي | منشأة مادية وبنية تحتية |
| الهدف | تنظيم البيانات لتسريع المعالجة وتقليل الموارد | استضافة الأنظمة وضمان استمرارية عملها وأمانها |
| المكونات | عقد ومؤشرات ومصفوفات وعمليات | خوادم وتخزين وشبكات وطاقة وتبريد وحماية |
| مكان العمل | داخل ذاكرة البرنامج على الجهاز | مبنى مجهز يضم آلاف الأجهزة |
| نطاق التأثير | أداء التطبيق أو الخوارزمية | توافرية كل الخدمات المستضافة وقدرتها |
| معيار الكفاءة | التعقيد الزمني والمكاني | نسبة التوافرية وكفاءة الطاقة والسعة |
| القائمون عليه | المبرمجون ومهندسو البرمجيات | مهندسو البنية التحتية والشبكات والعمليات |
| أمثلة الاستخدام | قاموس للتخزين المؤقت أو شجرة للفهرسة | استضافة موقع أو تشغيل خدمة سحابية |
كيف تعمل هياكل البيانات داخل الأنظمة المستضافة في مراكز البيانات؟
تعمل هياكل البيانات داخل الأنظمة المستضافة في مراكز البيانات على مستويين متكاملين. فعلى مستوى الخادم الواحد، تعيش الهياكل في ذاكرة التطبيق كـ القواميس والقوائم والأشجار وتعالج الطلبات الواردة بسرعة. وعلى مستوى المجموعة الموزعة (Cluster)، تظهر هياكل مصممة خصيصا للتوزيع على عشرات أو مئات الخوادم، مثل جداول التجزئة الموزعة (Distributed Hash Tables) والتجزئة المتسقة (Consistent Hashing) التي توزع المفاتيح على العقد بحيث تتأثر أقل نسبة ممكنة منها عند إضافة خادم أو فقدانه.
وتلعب الهياكل دورا محوريا في الخدمات التي تعتمد عليها مراكز البيانات الحديثة. فـ موزعات الأحمال (Load Balancers) تستخدم التجزئة المتسقة أو الطوابير لتوزيع الطلبات، وأنظمة الرسائل مثل Kafka تبنى على سجلات تسلسلية مضافة في النهاية (Append-only Logs) وطوابير موزعة، وأنظمة التخزين المؤقت مثل Redis و Memcached تعمل كـ جداول تجزئة ضخمة موزعة في الذاكرة. وتعتمد قواعد البيانات الموزعة على أشجار LSM و +B ومرشحات بلوم على كل عقدة، وتستخدم خوارزميات الإجماع (Consensus Algorithms) سجلات منسخة لضمان تماثل الحالة.
ويفرض هذا السياق الموزع متطلبات إضافية على تصميم الهياكل. فيجب أن تتحمل الأعطال الجزئية وأن تتوافق مع التزامن العالي وأن تقلل حركة الشبكة بين الخوادم، ولذلك تظهر هياكل خاصة كـ الأشجار اللاقفلية (Lock-free Trees) والمنسقات الموزعة والأنواع المتجانسة المتفقة في النهاية (CRDTs). ويظهر من ذلك أن الهياكل ليست منفصلة عن مراكز البيانات، بل هي البرمجيات التي تستثمر قدراتها المادية بأفضل صورة، فمركز البيانات يوفر القدرة الخام والهياكل تحسن استخدامها.دراتها المادية بأفضل صورة، فمركز البيانات يوفر القدرة الخام والهياكل تحسن استخدامها.
استخدامات هياكل البيانات في التطبيقات والأنظمة الحديثة
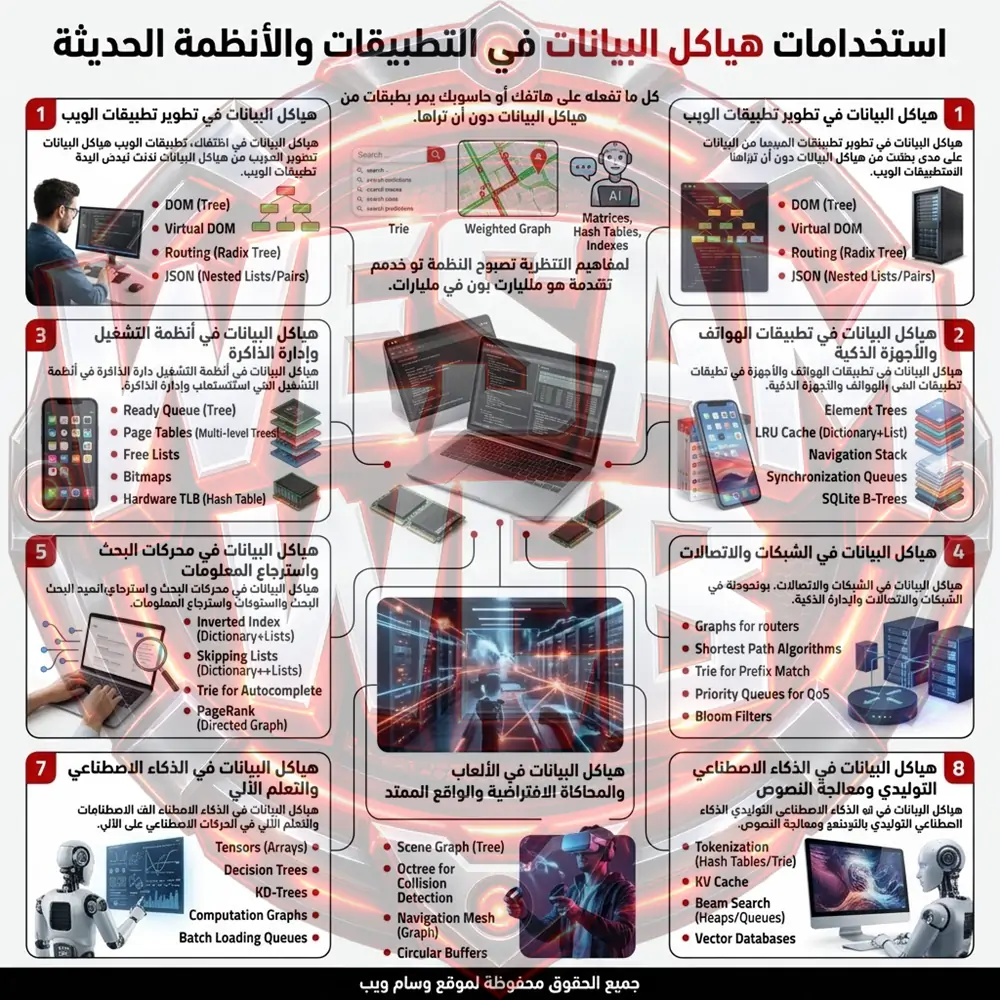
كل ما تفعله على هاتفك أو حاسوبك خلال يوم عادي يمر بطبقات من هياكل البيانات دون أن تراها. فعندما تكتب كلمة في مربع البحث وتظهر لك اقتراحات قبل أن تكملها، تعمل شجرة بادئية (Trie) في الخلفية. وعندما يختار تطبيق الخرائط أسرع طريق وسط الازدحام، يجري بحثا على رسم بياني موزون (Weighted Graph) يضم ملايين التقاطعات. وعندما يستجيب نموذج ذكاء اصطناعي لسؤالك خلال ثوان، تقف خلفه مصفوفات وجداول تجزئة وفهارس شبكية تتقاسم العمل. وفي هذا القسم نتتبع حضور هذه الهياكل في أهم المجالات التقنية، لنرى كيف تتحول المفاهيم النظرية التي شرحناها إلى أنظمة تخدم مليارات المستخدمين.
هياكل البيانات في تطوير تطبيقات الويب
تعتمد صفحة الويب نفسها على هيكل بيانات شجري، فالمتصفح يحول شيفرة HTML إلى شجرة تسمى نموذج كائنات المستند (DOM)، يمثل كل وسم فيها عقدة، وتربط العلاقة بين الوسم الحاوي والوسوم الداخلة فيه رابط أب وابن. وتقوم مكتبات الواجهات مثل React على فكرة الشجرة الافتراضية (Virtual DOM) التي تقارن نسختين من الشجرة لتحدد أقل عدد من التعديلات اللازمة على الصفحة الحقيقية. ويعتمد هذا الأسلوب على خوارزميات اجتياز ومقارنة تعمل على الأشجار، وبفضلها تتحدث الواجهات بسرعة دون إعادة بناء الصفحة كلها.
وعلى جانب الخادم تهيمن القواميس وجداول التجزئة على أغلب العمليات. فـ بيانات الجلسات (Sessions) تخزن بمفتاح فريد لكل مستخدم ليسترجعها الخادم بزمن ثابت تقريبا، وأنظمة التخزين المؤقت مثل Redis و Memcached تحفظ نتائج الاستعلامات والصفحات المولدة مسبقا بنفس الفكرة. وتستخدم أطر العمل شجرة بادئية مضغوطة (Radix Tree) في جدول التوجيه (Routing) لتحدد المعالج المناسب لكل عنوان يصل إلى الخادم، فتطابق المسار مقطعا بمقطع بدلا من المقارنة مع كل المسارات المسجلة. وتتحول بيانات الاستجابة بين الخادم والمتصفح إلى صيغة JSON التي هي في جوهرها قاموس متداخل من القوائم والأزواج.
وتستخدم الأنظمة الخلفية الطوابير بكثافة في معالجة المهام الثقيلة مثل إرسال البريد ومعالجة الصور وتوليد التقارير، فيضع الخادم المهمة في طابور مثل RabbitMQ أو Amazon SQS ويرد على المستخدم فورا، بينما يسحب عمال الخلفية المهام ويعالجونها بالتتابع. وتعتمد حماية الواجهات من الإفراط في الطلبات (Rate Limiting) على نافذة منزلقة تنفذ عادة بـ طابور مزدوج النهاية (Deque) أو عداد مخزن في قاموس. وهكذا يتبين أن تطبيق ويب واحدا يجمع الأشجار والقواميس والطوابير معا، ولكل هيكل منها مهمة محددة لا يؤديها غيره بالكفاءة نفسها.
هياكل البيانات في تطبيقات الهواتف والأجهزة الذكية
تفرض الأجهزة المحمولة قيودا صارمة على الذاكرة والبطارية والمعالج، ولذلك تزداد أهمية الاختيار الدقيق للهياكل فيها. فكل شاشة في التطبيق تمثل شجرة عناصر من أزرار وقوائم وصور تحتاج إلى رسم وتحديث، وتؤثر كفاءة هذه الشجرة مباشرة في سلاسة الحركة واستجابة اللمس. وتعاني القوائم الطويلة من مشكلة استهلاك الذاكرة إذا أنشئت كل عناصرها دفعة واحدة، فتستخدم الأنظمة تقنية إعادة التدوير (Recycling) التي تحتفظ بعدد محدود من العناصر المرئية وتعيد استخدامها أثناء التمرير، وهي فكرة تشبه مجمع الكائنات (Object Pool) المبني على قائمة أو مكدس.
وتعتمد التطبيقات كذلك على التخزين المؤقت لتقليل استهلاك البيانات وتسريع العرض، فتستخدم ذاكرة LRU مؤقتة لحفظ الصور التي حملت حديثا. وتنفذ هذه الذاكرة غالبا بـ قاموس وقائمة مرتبطة ثنائية الاتجاه معا، فـالقاموس يجد العنصر بسرعة، والقائمة ترتب العناصر بحسب آخر استخدام لـ إخلاء الأقدم عند الامتلاء. ويحتفظ نظام أندرويد بفئات مثل LruCache و SparseArray التي توفر الذاكرة مقارنة بـالقواميس العامة، بينما يوفر نظام iOS فئة NSCache لـلغرض نفسه.
ويبرز دور قواعد البيانات المحلية على الهواتف، فمحرك SQLite المثبت على أغلب الأجهزة يبنى على أشجار B لـفهرسة الجداول. وتتلخص أبرز استخدامات الهياكل في التطبيقات المحمولة فيما يلي:
- شجرة العناصر: تمثيل واجهة المستخدم وتحديثها بكفاءة عند تغير الحالة.
- ذاكرة LRU المؤقتة: قاموس مع قائمة ثنائية لحفظ الصور والبيانات الأكثر استخداما.
- مكدس التنقل: تتبع الشاشات المفتوحة ليعمل زر الرجوع بالترتيب الصحيح.
- طابور المزامنة: حفظ العمليات المعلقة أثناء انقطاع الاتصال وإرسالها لاحقا.
- فهارس SQLite: أشجار B لتسريع الاستعلامات على البيانات المحلية.
هياكل البيانات في أنظمة التشغيل وإدارة الذاكرة
يعد نظام التشغيل أكبر مستهلك لـ هياكل البيانات في الحاسوب، لأنه يدير الموارد كلها من معالج وذاكرة وأقراص وأجهزة. فهو يحتفظ بقائمة العمليات الجاهزة في طوابير تحدد أي عملية تحصل على المعالج تاليا، وقد اعتمد مجدول لينكس (CFS) سنوات طويلة على شجرة أحمر وأسود (Red-Black Tree) ترتب العمليات بحسب الزمن الذي استهلكته. ويمثل كل عملية بسجل يسمى كتلة تحكم العملية (PCB) يحمل حالتها وسجلاتها ومواردها، وترتبط هذه السجلات في قوائم مرتبطة وأشجار تعكس علاقات الأب والابن بين العمليات.
وتقوم إدارة الذاكرة على هياكل متخصصة تعمل خلف الكواليس. فـ جداول الصفحات (Page Tables) تترجم العناوين الافتراضية للبرنامج إلى عناوين فيزيائية في الذاكرة، وتبنى في المعالجات الحديثة كـ أشجار متعددة المستويات توفر الذاكرة بعدم تخصيص الأجزاء غير المستخدمة. وتحتفظ الأنظمة بـ قوائم للكتل الحرة (Free Lists) وبـ بتات خرائط (Bitmaps) تتبع الصفحات المشغولة، وتستخدم مخصصات الذاكرة مثل نظام الأصدقاء (Buddy Allocator) أشجارا ثنائية ضمنية لدمج الكتل المتجاورة بسرعة. وتستخدم ذاكرة ترجمة العناوين المؤقتة (TLB) جدول تجزئة عتاديا لتسريع عملية الترجمة.
هياكل البيانات في الشبكات والاتصالات
تقوم الشبكات على الرسوم البيانية (Graphs) من الأساس، فالأجهزة والموجهات رؤوس، والروابط بينها حواف موزونة بالزمن أو السعة أو التكلفة. وتستخدم بروتوكولات التوجيه مثل OSPF خوارزمية ديكسترا على هذا الرسم لحساب أقصر المسارات، بينما يستخدم بروتوكول RIP خوارزمية بيلمان فورد. ويحتفظ كل موجه بجدول توجيه ضخم يضم مئات الآلاف من البادئات في الإنترنت العالمي، ويطابق عنوان كل حزمة بـ أطول بادئة (Longest Prefix Match) باستخدام شجرة Trie أو بنى عتادية مشتقة منها.
وتمر الحزم داخل الموجه عبر طوابير تنظم إرسالها. فالطابور البسيط يخدم الحزم بحسب وصولها، وطوابير الأولوية تمنح حزم المكالمات الصوتية والفيديو أسبقية على تنزيل الملفات لتحافظ على جودة الخدمة (QoS). وعندما يمتلئ الطابور، تطبق سياسات إسقاط الحزم كالإسقاط من الذيل أو الإسقاط العشوائي المبكر (RED). أما ترجمة العناوين (NAT) وتتبع الاتصالات في جدران الحماية فتعتمدان على جداول تجزئة سريعة تربط كل اتصال بحالته.
وتظهر أنماط أخرى في الشبكات الحديثة. فـ التجزئة المتسقة (Consistent Hashing) توزع الطلبات على مجموعات الخوادم بحيث تتأثر أقل نسبة منها عند إضافة خادم أو سقوطه. وتستخدم شبكات توزيع المحتوى (CDN) مرشحات بلوم (Bloom Filters) لتجنب تخزين الملفات التي يطلبها مستخدم واحد مرة واحدة فقط. وتعتمد الشبكات النظيرة (Peer-to-Peer) كالبيتورنت على جداول تجزئة موزعة (DHT) تحدد أي عقدة تحمل أي ملف دون خادم مركزي. وبهذا تظهر الهياكل في كل طبقة من طبقات الاتصال من العتاد إلى التطبيق.
هياكل البيانات في محركات البحث واسترجاع المعلومات
يقوم محرك البحث على هيكل مركزي يسمى الفهرس المعكوس (Inverted Index)، وهو في جوهره قاموس يربط كل كلمة بقائمة الوثائق التي تحتويها. فبدلا من فحص مليارات الصفحات عند كل استعلام، ينظر المحرك إلى قائمة الكلمة المطلوبة مباشرة فيجد الصفحات المرشحة فورا. وتسمى قائمة الوثائق لكل كلمة قائمة النشر (Posting List)، وتخزن مرتبة ومضغوطة لتوفير الذاكرة وتسريع عمليات التقاطع عند البحث بعدة كلمات. وتستخدم قوائم التخطي لتسريع القفز داخل هذه القوائم الطويلة.
ولا يتوقف الأمر عند الفهرس، فتتعاون هياكل أخرى في كل مرحلة. فـ شجرة Trie والآلات محدودة الحالات المشتقة منها تدعم الإكمال التلقائي وتصحيح الأخطاء الإملائية، وطوابير الأولوية تحتفظ بأفضل النتائج أثناء الترتيب فلا تحتاج إلى ترتيب كل الوثائق المرشحة، وتكفي كومة صغرى بحجم $k$ لاستخراج أعلى $k$ نتيجة. ويمثل الويب كله رسما بيانيا موجها تمثل صفحاته رؤوسا وروابطه حوافا، وقامت خوارزمية PageRank التي ابتكرتها جوجل على تحليل هذا الرسم لتقدير أهمية الصفحات.
وتتسع الهياكل المستخدمة مع تطور البحث الحديث. فـ البحث الدلالي يمثل النصوص كـ متجهات عددية كثيفة ويخزنها في فهارس متخصصة تعتمد على رسوم بيانية مثل HNSW أو على التجزئة الحساسة للموقع (LSH) أو تقسيم الفضاء إلى عناقيد. وتستخدم مرشحات بلوم لتجنب قراءة أجزاء الفهرس التي لا تحتوي الكلمة. ويوضح هذا التنوع أن محرك البحث الواحد ليس هيكلا منفردا، بل منظومة متناسقة من القواميس والأشجار والكومات والرسوم تعمل معا لتجيب خلال أجزاء من الثانية.
هياكل البيانات في الألعاب والمحاكاة الافتراضية والواقع الممتد
تتطلب الألعاب ثلاثية الأبعاد معالجة آلاف الكائنات في كل إطار بمعدل ستين إطارا في الثانية أو أكثر، ولهذا تعد من أكثر المجالات حساسية لاختيار الهياكل. فمحركات الألعاب تنظم عالمها في شجرة تسمى رسم المشهد (Scene Graph) حيث ترث الكائنات الفرعية التحويلات المكانية لآبائها، فتتحرك اليد مع الذراع والذراع مع الجسد تلقائيا. وتقسم الفضاءات بـ أشجار مكانية كـ الشجرة الرباعية (Quadtree) في الألعاب ثنائية الأبعاد والشجرة الثمانية (Octree) وأشجار BVH في الثلاثية، فتختصر فحص التصادمات من مقارنة كل كائن بكل كائن إلى مقارنة الكائنات المتجاورة فقط.
وتعتمد الذكاء الاصطناعي للشخصيات على الرسوم البيانية وطوابير الأولوية. فالعالم يقسم إلى شبكة ملاحة (Navigation Mesh) تمثل رسما بيانيا، وتستخدم خوارزمية A* كومة لاختيار العقدة الأكثر وعدا في كل خطوة فتجد الشخصية طريقها حول العوائق بسرعة. وتعتمد أنظمة الأحداث على طوابير تؤجل تنفيذ الأفعال إلى وقتها المناسب، وتستخدم أنماط ECS (Entity Component System) مصفوفات متجاورة لكل نوع من المكونات لتحقيق أقصى استفادة من الذاكرة المخبئية، وهو دليل على أن التخطيط الفيزيائي للبيانات قد يهم أكثر من التعقيد النظري.
وفي الواقع الممتد (XR) بأنواعه من الواقع المعزز إلى الواقع الافتراضي والمختلط، تتضاعف المتطلبات لأن تأخر الاستجابة القليل يسبب دوارا وانزعاجا للمستخدم. فتبني الأجهزة خريطة ثلاثية الأبعاد للغرفة المحيطة باستخدام أشجار ثمانية وشبكات مثلثات وبنى مكانية مجزأة (Voxel Hashing)، وتثبت المرتكزات المكانية (Spatial Anchors) للكائنات الافتراضية في جداول تجزئة تربطها بمواقع حقيقية. وتحتاج أنظمة التتبع إلى طوابير ذات سعة محدودة تحتفظ بآخر قراءات الحساسات كـ مخازن حلقية (Circular Buffers) تتجدد باستمرار دون تخصيص ذاكرة جديدة.
هياكل البيانات في الذكاء الاصطناعي والتعلم الآلي
تقوم نماذج التعلم الآلي على المصفوفات متعددة الأبعاد المعروفة باسم الموترات (Tensors) التي تخزن البيانات والأوزان ونواتج الطبقات. وتعتمد مكتبات مثل NumPy و PyTorch و TensorFlow على كتل متجاورة من الذاكرة تتيح للمعالجات الرسومية تنفيذ عمليات ضرب المصفوفات على ملايين العناصر دفعة واحدة. ويظهر هنا أثر التخزين المتجاور بوضوح، فتنظيم البيانات بترتيب يطابق طريقة القراءة قد يضاعف السرعة عدة مرات. وتستخدم المصفوفات المتناثرة (Sparse Matrices) تمثيلات مضغوطة تحفظ القيم غير الصفرية فقط عندما تكون أغلب الخانات أصفارا.
وتتوزع الهياكل الأخرى على مراحل دورة حياة النموذج. فـ أشجار القرار والغابات العشوائية وخوارزميات التعزيز التدريجي (Gradient Boosting) كـ XGBoost تبنى كلها على الأشجار كهيكل أساسي، وتقوم خوارزميات الجيران الأقرب (KNN) على أشجار KD أو أشجار الكرات لتسريع البحث عن أقرب النقاط. وتمثل الشبكات العصبية نفسها كـ رسوم حسابية موجهة (Computation Graphs) تسجل العمليات المتتابعة ليحسب الانتشار العكسي (Backpropagation) المشتقات عبر اجتياز الرسم بترتيب عكسي. وتعتمد نماذج الرسوم العصبية (Graph Neural Networks) على قوائم التجاور مباشرة.
وفي مرحلة تجهيز البيانات وتشغيل النماذج تعمل القواميس والمجموعات والطوابير بصمت وراء الكواليس. فبناء المفردات (Vocabulary) وعد تكرار الكلمات يعتمدان على القواميس، وإزالة التكرار من مجموعات البيانات الضخمة تعتمد على المجموعات ومرشحات بلوم وتجزئة MinHash، وتحميل الدفعات أثناء التدريب يتم عبر طوابير متزامنة تغذي المعالج الرسومي بلا انقطاع. ويتضح من ذلك أن كفاءة أنظمة الذكاء الاصطناعي لا تتوقف على النماذج وحدها، بل على جودة الهياكل التي تحيط بها وتغذيها.
هياكل البيانات في الذكاء الاصطناعي التوليدي ومعالجة النصوص
يبدأ التعامل مع النص في النماذج اللغوية الكبيرة بمرحلة التقطيع (Tokenization)، حيث يتحول النص إلى وحدات صغيرة تسمى الرموز (Tokens). ويخزن المقطع مفردات ضخمة في جدول تجزئة يربط كل رمز برقم تعريفي، وتستخدم خوارزميات مثل ترميز أزواج البايت (BPE) جداول دمج مرتبة وطوابير أولوية أو قوائم مرتبطة لدمج الأزواج الأكثر تكرارا بكفاءة. وتستخدم بعض التنفيذات أشجار Trie لمطابقة أطول رمز ممكن في كل موضع من النص.
وأثناء التوليد، يحتاج النموذج إلى هياكل تحافظ على حالته السابقة دون إعادة حسابها في كل خطوة. فتخزن ذاكرة المفاتيح والقيم (KV Cache) ناتج الانتباه للرموز السابقة في موترات متجاورة كي لا يعاد حسابها، وتدير أنظمة الخدمة الحديثة هذه الذاكرة بأساليب تشبه ترقيم الصفحات في أنظمة التشغيل (Paged Attention) فتقسمها إلى كتل صغيرة يشار إليها بجداول ترجمة. ويستخدم بحث الحزمة (Beam Search) كومة أو طابور أولوية للاحتفاظ بأفضل التسلسلات المرشحة في كل خطوة.
ويمتد حضور الهياكل إلى التطبيقات المبنية حول النماذج. فأنظمة التوليد المعزز بالاسترجاع (RAG) تقسم المستندات إلى مقاطع وتحولها إلى متجهات وتخزنها في قواعد بيانات متجهية تستخدم فهارس رسمية مثل HNSW للعثور على أقرب المقاطع لسؤال المستخدم بسرعة. وتحافظ التطبيقات على سجل المحادثة في قوائم تقص عند تجاوز حدود السياق، وتخزن نتائج الاستعلامات المتكررة في ذاكرات مؤقتة قاموسية توفر التكلفة والزمن. فـ الذكاء الاصطناعي التوليدي على ضخامته يقف على أكتاف هياكل البيانات التقليدية نفسها.
هياكل البيانات في أنظمة الملفات وإدارة الموارد
ينظم نظام الملفات البيانات على القرص في هيكل شجري مألوف من المجلدات والملفات، لكن ما يجري تحت السطح أعقد من ذلك بكثير. فكل ملف يمثل بسجل وصفي يسمى العقدة الفهرسية (Inode) في أنظمة يونكس ولينكس، يحمل حجم الملف وصلاحياته ومؤشرات إلى كتل بياناته على القرص. وتستخدم المؤشرات المباشرة وغير المباشرة بنية شجرية متعددة المستويات تتيح الوصول إلى الملفات الكبيرة دون تضخيم حجم السجل الصغير. وتحتفظ الأنظمة بـ خرائط بتات (Bitmaps) تتبع الكتل الحرة والمشغولة بسرعة عالية.
وتطورت الأنظمة الحديثة نحو أشجار B و B+ لفهرسة المجلدات والملفات الكبيرة. فنظام NTFS يخزن محتويات المجلدات في أشجار B+، ونظام Btrfs مبني بالكامل على أشجار B بآلية النسخ عند الكتابة (Copy-on-Write)، ونظام XFS يستخدم أشجار B+ لإدارة الامتدادات والمساحات الحرة. وتتيح هذه الأشجار البحث عن ملف داخل مجلد يضم ملايين الملفات بعدد قليل من قراءات القرص، وهو ما كان مستحيلا عند استخدام القوائم الخطية في الأنظمة القديمة.
وتمتد الهياكل إلى إدارة الموارد في النظام ككل. فـ ذاكرة الصفحات المؤقتة (Page Cache) تحفظ أجزاء الملفات الأكثر استخداما في الذاكرة باستخدام جداول تجزئة و أشجار Radix للبحث السريع و قوائم LRU لاختيار ما يخلى أولا. وتحتفظ ذاكرة المجلدات المؤقتة (Dentry Cache) بنتائج تحليل المسارات في جداول تجزئة تتفادى تكرار المرور على المجلدات. وتدير مجدولات الإدخال والإخراج طوابير الطلبات الموجهة للقرص وتعيد ترتيبها لتقليل حركة الرؤوس في الأقراص الميكانيكية.
وبذلك تعمل هياكل متنوعة معا لتجعل التعامل مع الملفات سلسا وسريعا.che) تحفظ أجزاء الملفات الأكثر استخداما في الذاكرة باستخدام جداول تجزئة وأشجار Radix للبحث السريع وقوائم LRU لاختيار ما يخلى أولا. وتحتفظ ذاكرة المجلدات المؤقتة (Dentry Cache) بنتائج تحليل المسارات في جداول تجزئة تتفادى تكرار المرور على المجلدات. وتدير مجدولات الإدخال والإخراج طوابير الطلبات الموجهة للقرص وتعيد ترتيبها لتقليل حركة الرؤوس في الأقراص الميكانيكية. وبذلك تعمل هياكل متنوعة معا لتجعل التعامل مع الملفات سلسا وسريعا.
العلاقة بين هياكل البيانات والخوارزميات
قال عالم الحاسوب السويسري نيكلاوس فيرث في عنوان كتابه الشهير الصادر عام 1976 إن الخوارزميات زائد هياكل البيانات تساوي البرامج، وهي عبارة تلخص العلاقة بين المفهومين أبلغ تلخيص. فلا قيمة لهيكل بيانات دون عمليات تعمل عليه، ولا يمكن لخوارزمية أن تعمل دون بيانات منظمة تتعامل معها. ويشبه الأمر العلاقة بين المطبخ والوصفة، فالمطبخ بأدواته وتنظيمه يحدد ما يمكن طهيه بسرعة، والوصفة تحدد الخطوات التي تنفذ داخله. وفي هذا القسم نفصل كيف يتكامل المفهومان وكيف يؤثر أحدهما في الآخر.
كيف تتكامل هياكل البيانات والخوارزميات في البرامج؟
الخوارزمية هي سلسلة محددة من الخطوات التي تحل مسألة معينة، بينما هيكل البيانات هو الطريقة التي تنظم بها المعلومات التي تعمل عليها تلك الخطوات. ويتداخل المفهومان في كل برنامج حقيقي تداخلا لا يمكن فصله، فخوارزمية البحث الثنائي تفترض مصفوفة مرتبة تتيح الوصول العشوائي، وخوارزمية البحث بالعرض (BFS) تفترض طابورا، وخوارزمية البحث بالعمق (DFS) تفترض مكدسا أو عودية، وخوارزمية ديكسترا تفترض كومة وقائمة تجاور. فكل خوارزمية تحمل في تصميمها تصورا عن الهيكل الذي تعمل عليه.
ويتجلى هذا التكامل عند تتبع مسألة واحدة من البداية إلى النهاية. فمسألة إيجاد أقصر طريق بين مدينتين تتطلب أولا نمذجة الخريطة كرسم بياني موزون وهو قرار في هياكل البيانات، ثم اختيار خوارزمية ديكسترا وهو قرار في الخوارزميات، ثم اختيار كومة لتنفيذ طابور الأولوية داخلها وهو قرار في الهياكل مجددا. وكل قرار يقيد الآخر ويفتح خيارات جديدة. ولهذا يدرس المنهجان عادة معا في مقرر جامعي واحد هو هياكل البيانات والخوارزميات (DSA).
ولا يعني ذلك أن المفهومين متطابقان. فالخوارزمية الواحدة قد تعمل على هياكل مختلفة بنتائج متفاوتة، كالترتيب الذي يمكن تنفيذه على مصفوفة أو قائمة مرتبطة بكفاءات مختلفة. والهيكل الواحد تعمل عليه خوارزميات كثيرة، فالرسم البياني تجتازه خوارزميات البحث ويحلل بخوارزميات الاتصال والتدفق والمطابقة. فالعلاقة تبادلية ومرنة، وفهمها هو ما يمكن المبرمج من التنقل بين الخيارات بحرية ووعي.
كيف يؤثر اختيار هيكل البيانات في أداء الخوارزمية؟
يحدد الهيكل المستخدم تكلفة كل خطوة تتكرر داخل الخوارزمية، وبالتالي تكلفتها الكلية. فخوارزمية تكرر عملية البحث عن عنصر مليون مرة تتأثر كليا بسرعة هذه العملية، فإذا كانت خطية كما في القائمة صارت الخوارزمية كلها تربيعية وانهارت عند الأحجام الكبيرة، وإذا كانت ثابتة كما في جدول التجزئة بقيت الخوارزمية خطية وأنجزت عملها في ثوان. ومن أشهر الأمثلة مسألة مجموع عددين، فتنفيذها بحلقتين متداخلتين على مصفوفة يكلف O(n2)O(n^2)O(n2)، بينما يهبط إلى O(n)O(n)O(n) عند استخدام قاموس يحتفظ بالأعداد السابقة.
وتظهر الأمثلة نفسها في الخوارزميات الكلاسيكية. فخوارزمية ديكسترا المنفذة بمصفوفة عادية للبحث عن أقرب عقدة تبلغ تكلفتها O(V2)O(V^2)O(V2)، وعند تنفيذها بكومة ثنائية تصبح O((V+E)logV)O((V + E) \log V)O((V+E)logV)، وهو فرق كبير في الرسوم المتناثرة. وكذلك ترتيب الكومة وترتيب الاختيار يؤديان المهمة نفسها تقريبا، لكن الأول يستفيد من الكومة فيبلغ O(nlogn)O(n \log n)O(nlogn) والثاني تربيعي. والفارق الوحيد بينهما هو الهيكل المستخدم لاستخراج العنصر الأكبر في كل مرة.
ولا يقتصر الأثر على التعقيد الزمني بل يشمل الذاكرة وسهولة التنفيذ والأخطاء. فاستخدام قائمة مرتبطة في خوارزمية تعتمد على الوصول بالفهرس يجعل التنفيذ معقدا وبطيئا، واستخدام مصفوفة لتنفيذ عمليات إدراج كثيرة في المنتصف يهدر الوقت في الإزاحة. وقد يسبب اختيار هيكل غير متوازن مفاجآت في الأداء عند أسوأ المدخلات. ولذلك يعد اختيار الهيكل جزءا لا يتجزأ من تصميم الخوارزمية، وليس تفصيلا ثانويا يترك لمرحلة التنفيذ.
ويمكن أن يغير الهيكل المناسب الخوارزمية نفسها تغييرا جذريا. فمسألة إيجاد أكبر عنصر في كل نافذة منزلقة تحل بحلقتين متداخلتين بتكلفة O(n×k)O(n \times k)O(n×k)، لكن استخدام طابور مزدوج النهاية (Deque) يحولها إلى حل خطي O(n)O(n)O(n) بخوارزمية مختلفة تماما أنيقة وسريعة. وكذلك تتحول مسائل الاتصال الديناميكي من إعادة بناء الرسم كل مرة إلى عمليات دمج شبه ثابتة عند استخدام هيكل DSU. ولهذا يقول المختصون إن أفضل طريق لتحسين خوارزمية هو غالبا تحسين هيكل بياناتها أولا.
أمثلة على استخدام هياكل البيانات في عمليات البحث والترتيب والمعالجة
تظهر العلاقة بين المفهومين بوضوح في المهام الأساسية الثلاث التي تتكرر في كل برنامج تقريبا، وهي البحث والترتيب والمعالجة. ففي البحث يتفاوت الأداء بحسب الهيكل تفاوتا كبيرا، فالقائمة غير المرتبطة تفرض بحثا خطيا، والمصفوفة المرتبة تتيح البحث الثنائي اللوغاريتمي، وجدول التجزئة يقدم بحثا ثابتا تقريبا، والشجرة المتوازنة تجمع اللوغاريتم مع الترتيب. وفي الترتيب تعمل خوارزمية الدمج على المصفوفات والقوائم المرتبطة على السواء، وترتيب الكومة يستفيد من بنية الكومة، والترتيب بالعد يستخدم مصفوفة مساعدة عندما تكون القيم ضمن نطاق صغير.
وفي المعالجة العامة تتكرر الأنماط التالية في تطبيقات لا حصر لها:
- في كشف العناصر المكررة تستخدم مجموعة (Set).
- في عد التكرارات يستخدم قاموس (Dictionary).
- في التحقق من توازن الأقواس يستخدم مكدس (Stack).
- في معالجة الطلبات بالتتابع يستخدم طابور (Queue).
- في إيجاد أكبر k عنصرا يستخدم كومة (Heap).
- في تمثيل التعبيرات الرياضية تستخدم شجرة (Tree).
وتتلخص أبرز الأمثلة فيما يلي:
- البحث الثنائي على مصفوفة مرتبة: مزج بين هيكل يتيح الوصول العشوائي وخوارزمية تقسم المسألة إلى نصفين بتكلفة O(logn)O(\log n)O(logn).
- ترتيب الكومة (Heap Sort): بناء كومة كبرى ثم استخراج الجذر مرارا للحصول على ترتيب تصاعدي بتكلفة O(nlogn)O(n \log n)O(nlogn) وذاكرة إضافية ثابتة.
- البحث بالعرض (BFS): طابور وقائمة تجاور لإيجاد أقصر مسار في رسم غير موزون.
- البحث بالعمق (DFS): مكدس أو عودية لاستكشاف المسارات وكشف الدورات والترتيب الطوبولوجي.
- عد التكرارات وكشف التطابق: قاموس أو مجموعة لتحويل مسائل تربيعية إلى خطية.
الفرق بين دور هيكل البيانات ودور الخوارزمية
يتلخص الفرق بين الدورين في أن هيكل البيانات يجيب عن سؤال كيف تنظم البيانات وتخزن؟، بينما تجيب الخوارزمية عن سؤال ما الخطوات التي تنفذ لحل المسألة؟. فالهيكل كيان ساكن نسبيا يحمل حالة البيانات ويحدد العمليات المسموحة، والخوارزمية عملية ديناميكية تتحرك عبر الهيكل وتغير حالته وصولا إلى نتيجة. ويقاس كل منهما بمعايير متقاربة لكن مختلفة، فالهيكل يقيم بتكلفة عملياته وحجمه في الذاكرة، والخوارزمية تقيم بتكلفتها الكلية وصحة نتائجها. ويوضح الجدول التالي الفروق بالتفصيل:
| وجه المقارنة | هيكل البيانات (Data Structure) | الخوارزمية (Algorithm) |
|---|---|---|
| السؤال الذي يجيب عنه | كيف تنظم البيانات وتخزن؟ | ما الخطوات التي تحل المسألة؟ |
| الطبيعة | تنظيم ساكن للمعلومات في الذاكرة | سلسلة متحركة من التعليمات |
| المكونات | عقد ومؤشرات ومصفوفات وعمليات أساسية | مدخلات وخطوات وشروط وتكرار ومخرجات |
| معيار التقييم | تكلفة الإدراج والبحث والحذف وحجم الذاكرة | التعقيد الزمني والمكاني وصحة النتيجة |
| أمثلة | المصفوفة والمكدس والشجرة والرسم البياني | البحث الثنائي والترتيب السريع وديكسترا |
| الاستقلالية | يمكن استخدامه مع خوارزميات متعددة | يمكن تنفيذها على هياكل مختلفة |
| التأثير المتبادل | يحدد كفاءة الخطوات داخل الخوارزمية | تحدد أي الهياكل أنسب لعملها |
| المخرجات | بنية منظمة جاهزة للاستعلام | حل المسألة أو قيمة ناتجة |
لماذا يحتاج المبرمج إلى فهم هياكل البيانات والخوارزميات معا؟
يحتاج المبرمج إلى فهم المفهومين معا لأن أداء البرنامج لا يتحدد بأحدهما منفردا. فمن يعرف الخوارزميات دون الهياكل سيعجز عن تنفيذها بكفاءة، ومن يعرف الهياكل دون الخوارزميات سيملك أوعية منظمة دون أن يعرف كيف يستثمرها. أما من يجمع بينهما فيستطيع أن ينظر إلى المشكلة ويفككها إلى بيانات وعمليات، ثم يختار لكل جزء أنسب أداة، ويتنبأ بسلوك حله عند تضخم البيانات قبل أن يكتب سطرا واحدا من الشيفرة.
وتمنح هذه المعرفة المبرمج قدرة على التشخيص والتحسين. فعندما يبطؤ تطبيق مع نمو البيانات، يستطيع صاحب المعرفة أن يحلل المسار الحرج ويحدد العملية ذات التعقيد المرتفع ويستبدلها بما يناسبها، بدلا من التخمين أو الاكتفاء بزيادة قوة الخوادم. كما يفهم سلوك المكتبات الجاهزة التي يستخدمها يوميا، فيعرف لماذا تكلف إزالة أول عنصر من قائمة Python أكثر من إزالة الأخير، ولماذا يتغير ترتيب عناصر المجموعة، ولماذا تفشل القوائم كمفاتيح في القواميس.
ويظل هذا المجال من أهم معايير التقييم المهني في قطاع هندسة البرمجيات وتكنولوجيا المعلومات. فمقابلات التوظيف في الشركات التقنية الكبرى تركز غالبا على مسائل الهياكل والخوارزميات لأنها تكشف طريقة التفكير وقدرة الشخص على تحليل المشكلات وليس حفظ الأدوات فقط. وتنتقل هذه المهارة بين اللغات والأطر والتقنيات المتغيرة، فتظل صالحة حتى حين تتبدل الموضة التقنية. ولذلك يعد الاستثمار في إتقانها من أعلى الاستثمارات عائدا على المدى الطويل لكل من يعمل في البرمجة والذكاء الاصطناعي وهندسة الأنظمة.استثمارات عائدا على المدى الطويل لكل من يعمل في البرمجة والذكاء الاصطناعي وهندسة الأنظمة.
هياكل البيانات في لغات البرمجة
تتفق لغات البرمجة على المفاهيم وتختلف في طريقة تقديمها للمبرمج. فبعضها يضع القوائم والقواميس في متناول يدك منذ السطر الأول، وبعضها لا يمنحك سوى المصفوفات والمؤشرات وعليك أن تبني الباقي بنفسك. وهذا الاختلاف ليس تفصيلا شكليا، بل يحدد سرعة التطوير وأداء البرنامج وحجم الأخطاء المحتملة. ولذلك يحتاج المطور المحترف إلى معرفة ما توفره لغته من هياكل جاهزة، وإلى فهم ما يجري تحتها من تنفيذ وتكاليف. وفي هذا القسم نستعرض أربع لغات من أكثر اللغات استخداما، ثم نقارن بينها ونناقش متى تعتمد على الجاهز ومتى تبني بنفسك.
وتنبع أهمية هذه المقارنة من واقع عملي بسيط، فمعظم المطورين يعملون بأكثر من لغة على مدى مسيرتهم، وينتقلون بين Python وJava وJavaScript حسب المشروع. ومن يفهم الفكرة وراء الهيكل يستطيع أن يجد مقابله في اللغة الجديدة خلال دقائق، فـالقائمة الديناميكية تسمى list في Python وArrayList في Java وvector في C++ وArray في JavaScript، لكنها في الجوهر مصفوفة تتوسع تلقائيا. وهذا التقابل هو ما نسعى إلى ترسيخه في الفقرات التالية.
وتتأثر سرعة هذه الهياكل بعوامل تتجاوز اللغة نفسها، مثل المترجم أو المفسر وطريقة إدارة الذاكرة ودعم الأنواع الثابتة أو الديناميكية. فالعملية نفسها قد تتكلف نانوثوان في C++ وميكروثوان في Python، رغم أن تعقيدها النظري واحد. ولهذا يجب دائما التفريق بين التعقيد الخوارزمي والأداء العملي في لغة بعينها، وهو ما سنراعيه في كل لغة نتناولها.
هياكل البيانات الأساسية في Python
توفر لغة Python أربعة هياكل مدمجة تغطي أغلب الاحتياجات اليومية. فـالقائمة (list) هي مصفوفة ديناميكية تقبل أنواعا مختلفة وتدعم الإضافة والحذف والفهرسة والتقطيع. والصف (tuple) هو قائمة غير قابلة للتعديل تصلح مفتاحا في القواميس لأنه قابل للتجزئة. والقاموس (dict) هو جدول تجزئة يحفظ ترتيب الإدراج منذ الإصدار 3.7، والمجموعة (set) هي جدول تجزئة للمفاتيح فقط تضمن التفرد وتتيح عمليات الاتحاد والتقاطع. وتجمع هذه الأربعة بين البساطة والكفاءة بدرجة عالية.
وتكمل المكتبة القياسية الصورة بوحدات متخصصة. فوحدة collections تقدم deque للطابور مزدوج النهاية وCounter لعد التكرارات وdefaultdict لقاموس بقيمة افتراضية وOrderedDict وnamedtuple. ووحدة heapq توفر كومة صغرى على قائمة عادية، ووحدة bisect تتيح البحث الثنائي والإدراج المرتب، ووحدة array تخزن أنواعا رقمية متجانسة بذاكرة أقل. أما الحوسبة العلمية فتعتمد على NumPy التي تقدم مصفوفات متجانسة متجاورة أسرع بعشرات المرات من القوائم.
ويجب معرفة بعض الفروق الدقيقة في الأداء عند العمل بـ Python. فالإضافة في نهاية القائمة سريعة بتكلفة مطفأة ثابتة، لكن الإدراج أو الحذف من البداية خطي لأنه يزيح العناصر، وهنا يتفوق deque بزمن ثابت عند الطرفين. واختبار الوجود بالعامل in خطي في القائمة وثابت في المجموعة والقاموس. والقائمة تخزن مراجع إلى كائنات وليس القيم نفسها، مما يزيد استهلاك الذاكرة. ويوضح المثال التالي أبرز الهياكل:
from collections import deque, Counter, defaultdict
import heapq

# القائمة (مصفوفة ديناميكية)
numbers = [4, 2, 9]
numbers.append(7)

# الصف (غير قابل للتعديل)
point = (3, 5)

# القاموس والمجموعة
ages = {"Ali": 30, "Sara": 25}
unique = {1, 2, 2, 3}          # {1, 2, 3}

# الطابور مزدوج النهاية
queue = deque([1, 2, 3])
queue.appendleft(0)
queue.pop()

# عد التكرارات
print(Counter("banana"))       # Counter({'a': 3, 'n': 2, 'b': 1})

# القاموس بقيمة افتراضية
groups = defaultdict(list)
groups["fruits"].append("apple")

# الكومة الصغرى
heap = [5, 1, 3]
heapq.heapify(heap)
print(heapq.heappop(heap))     # 1
هياكل البيانات في Java
تقدم لغة Java إطارا متكاملا يسمى إطار المجموعات (Java Collections Framework) يقوم على واجهات ثم تنفيذات. فالواجهة List تنفذها ArrayList المبنية على مصفوفة ديناميكية وLinkedList المبنية على قائمة ثنائية الاتجاه. والواجهة Map تنفذها HashMap بـجدول تجزئة وTreeMap بـشجرة أحمر وأسود وLinkedHashMap التي تحفظ ترتيب الإدراج. والواجهة Set تنفذها HashSet وTreeSet وLinkedHashSet بالنمط نفسه. وهذا التصميم المبني على التجريد يتيح تبديل التنفيذ دون تغيير بقية الشيفرة.
وتمتاز Java بـ النظام الصارم للأنواع والأنواع العامة (Generics) التي تحدد نوع العناصر وقت الترجمة فتمنع أخطاء كثيرة قبل التشغيل، كأن تكتب List<String>. وتوفر اللغة فئات للطوابير مثل ArrayDeque التي تنوب عن المكدس والطابور معا وPriorityQueue المبنية على كومة ثنائية. أما المكدس القديم Stack فيفضل تجنبه لأنه متزامن بلا داع ويرث من Vector وتحل محله Deque. وتوفر حزمة java.util.concurrent نسخا آمنة للخيوط مثل ConcurrentHashMap وCopyOnWriteArrayList.
ويفرض نظام Java بعض التكاليف التي يجب الانتباه إليها. فالمجموعات لا تخزن الأنواع الأولية كـ int مباشرة بل تغلفها في كائنات كـ Integer فيما يسمى التغليف (Boxing)، وهذا يزيد استهلاك الذاكرة ويبطئ العمليات قليلا. ويجب تنفيذ الدالتين equals وhashCode بصورة متسقة في أي فئة تستخدم مفتاحا في HashMap، وإلا ضاعت العناصر. ويوضح المثال التالي أهم التنفيذات:
import java.util.*;

public class Demo {
    public static void main(String[] args) {
        // قائمة ديناميكية
        List<Integer> list = new ArrayList<>();
        list.add(10);
        list.add(20);

        // قاموس
        Map<String, Integer> ages = new HashMap<>();
        ages.put("Ali", 30);
        System.out.println(ages.get("Ali"));        // 30

        // مجموعة مرتبة (شجرة أحمر وأسود)
        Set<Integer> sorted = new TreeSet<>(List.of(5, 1, 3));
        System.out.println(sorted);                  // [1, 3, 5]

        // مكدس وطابور عبر ArrayDeque
        Deque<Integer> stack = new ArrayDeque<>();
        stack.push(1);
        stack.push(2);
        System.out.println(stack.pop());             // 2

        Queue<String> queue = new ArrayDeque<>();
        queue.offer("A");
        queue.offer("B");
        System.out.println(queue.poll());            // A

        // طابور أولوية (كومة صغرى)
        PriorityQueue<Integer> pq = new PriorityQueue<>();
        pq.add(8);
        pq.add(2);
        System.out.println(pq.poll());               // 2
    }
}
هياكل البيانات في C وC++
تقف لغة C في الطرف الآخر من الطيف، فهي لا توفر هياكل جاهزة سوى المصفوفات الثابتة والبنى (struct) والمؤشرات، وكل ما عدا ذلك يبنيه المبرمج بيده. ويمنحه هذا تحكما كاملا في تخطيط الذاكرة وتخصيصها بالدالتين malloc وfree، فيستطيع بناء قوائم مرتبطة وأشجارا وجداول تجزئة بالحجم الذي يريده تماما. لكنه يتحمل مسؤولية تحرير الذاكرة ومنع تجاوز الحدود، وأي خطأ قد يسبب تسريبا أو انهيارا أو ثغرة أمنية. ولهذا تعد C مدرسة ممتازة لفهم ما يجري فعلا تحت غطاء الهياكل.
أما C++ فتجمع بين هذا التحكم ومكتبة قوالب قياسية ضخمة تسمى STL (Standard Template Library). فـstd::vector مصفوفة ديناميكية وstd::list قائمة ثنائية الاتجاه وstd::deque طابور مزدوج النهاية وstd::stack وstd::queue وstd::priority_queue محولات فوقها. وstd::map وstd::set مبنيان على أشجار أحمر وأسود مرتبة، وstd::unordered_map وstd::unordered_set على جداول تجزئة. وتعتمد المكتبة على المكررات (Iterators) التي توحد طريقة المرور على كل الحاويات، وعلى خوارزميات عامة كـstd::sort وstd::find.
ويتفوق أداء C++ غالبا لأن القوالب تترجم بالنوع المحدد بلا تغليف ولا حمل إضافي، ولأن std::vector يخزن القيم نفسها متجاورة فيستفيد من الذاكرة المخبئية. وتنصح الإرشادات الحديثة باستخدام vector افتراضيا ما لم يثبت القياس خلاف ذلك، وبـالمؤشرات الذكية std::unique_ptr وstd::shared_ptr لإدارة الذاكرة تلقائيا. ويبين المثال التالي قائمة مرتبطة يدوية بلغة C ثم استخدام STL في C++:
#include <stdio.h>
#include <stdlib.h>

typedef struct Node {
    int data;
    struct Node *next;
} Node;

Node *push_front(Node *head, int value) {
    Node *node = malloc(sizeof(Node));
    node->data = value;
    node->next = head;
    return node;
}

void free_list(Node *head) {
    while (head) {
        Node *next = head->next;
        free(head);          // تحرير الذاكرة يدويا
        head = next;
    }
}

int main(void) {
    Node *head = NULL;
    head = push_front(head, 3);
    head = push_front(head, 2);
    head = push_front(head, 1);
    for (Node *p = head; p; p = p->next)
        printf("%d ", p->data);   // 1 2 3
    free_list(head);
    return 0;
}
#include <iostream>
#include <vector>
#include <unordered_map>
#include <queue>
#include <stack>
#include <set>

int main() {
    std::vector<int> v = {4, 2, 9};
    v.push_back(7);

    std::unordered_map<std::string, int> ages;
    ages["Ali"] = 30;

    std::set<int> sorted = {5, 1, 3};          // شجرة أحمر وأسود

    std::stack<int> st;  st.push(1); st.push(2);
    std::queue<int> q;   q.push(1);  q.push(2);

    // كومة كبرى افتراضيا
    std::priority_queue<int> pq;
    pq.push(8); pq.push(2);
    std::cout << pq.top() << "\n";             // 8
    return 0;
}
JavaScript: المصفوفات المتغيرة، الكائنات (Objects)، Map/Set
تعتمد لغة JavaScript على هياكل مرنة ديناميكية تناسب طبيعة الويب. فـالمصفوفة (Array) قائمة ديناميكية تقبل أنواعا مختلفة وتتوسع تلقائيا، وتوفر دوالا غنية كـpush وpop وshift وunshift وslice وsplice وmap وfilter وreduce. وتجدر الإشارة إلى أن المحركات الحديثة كـV8 تحسن المصفوفات داخليا، فتخزنها متجاورة عندما تكون عناصرها من نوع واحد، وتتحول إلى تمثيل قاموسي أبطأ إذا كانت متفرقة أو مختلطة. ولذلك يفضل تجنب الثقوب وخلط الأنواع في المصفوفات الحساسة للأداء.
وتستخدم الكائنات (Objects) تقليديا كقواميس تربط مفاتيح نصية بقيم، لكنها تحمل قيودا مهمة. فمفاتيحها تتحول إلى نصوص أو رموز (Symbols) فقط، وترث خصائص من النموذج الأولي قد تتعارض مع مفاتيحك، ولا تحافظ على ترتيب الإدراج بصورة موثوقة للمفاتيح الرقمية، وحساب حجمها يتطلب Object.keys. وللتغلب على هذه القيود قدم معيار ES6 الهيكلين Map وSet. فـMap يقبل أي نوع مفتاحا ويحفظ ترتيب الإدراج ويوفر خاصية size، وSet يخزن قيما فريدة بسرعة اختبار ثابتة.
ويفضل استخدام Map بدل الكائنات عندما تتغير المفاتيح كثيرا أو تكون ديناميكية أو غير نصية، ويكفي الكائن العادي للسجلات ذات الحقول الثابتة المعروفة. وتوفر اللغة كذلك WeakMap وWeakSet اللذين يحتفظان بـمراجع ضعيفة تسمح لـجامع النفايات بتحرير المفاتيح، وهي أدوات مفيدة في التخزين المؤقت المرتبط بدورة حياة الكائنات. أما الطابور والمكدس فيحاكيان بالمصفوفات، مع ملاحظة أن shift خطي في بعض الحالات فيلجأ للطوابير الكبيرة إلى مؤشر رأس أو مكتبات متخصصة.
// المصفوفة الديناميكية
const nums = [4, 2, 9];
nums.push(7);
const doubled = nums.map(n => n * 2);

// الكائن كسجل
const user = { name: "Sara", age: 25 };

// Map: مفاتيح من أي نوع مع حفظ الترتيب
const scores = new Map();
scores.set("Ali", 90);
scores.set(42, "number key");
console.log(scores.get("Ali"));   // 90
console.log(scores.size);         // 2

// Set: قيم فريدة
const unique = new Set([1, 2, 2, 3]);
console.log(unique.has(2));       // true
console.log([...unique]);         // [1, 2, 3]

// المكدس والطابور بالمصفوفة
const stack = [];
stack.push(1); stack.push(2);
console.log(stack.pop());         // 2

const queue = [];
queue.push("A"); queue.push("B");
console.log(queue.shift());       // A
كيف تختلف طريقة تنفيذ هياكل البيانات بين لغات البرمجة؟
تختلف طريقة التنفيذ بين اللغات على ثلاثة محاور رئيسية هي التحكم في الذاكرة ونظام الأنواع ومستوى التجريد. ففي C وC++ يتحكم المبرمج في كل بايت، فيحجز الذاكرة ويحررها ويرتب الحقول بالطريقة التي يريدها. وفي Java وPython وJavaScript يتولى جامع النفايات التحرير، وتخزن الكائنات على الكومة ويتعامل المبرمج مع مراجع إليها. وتنعكس هذه الفروق على الأداء، فالتحكم اليدوي يمنح السرعة والتوقع لكنه يرفع خطر الأخطاء، بينما تمنح الإدارة التلقائية الأمان والراحة بكلفة حمل إضافي ومقاطعات عرضية لجامع النفايات.
ويشكل نظام الأنواع محورا ثانيا للفرق. فاللغات ذات الأنواع الثابتة كـJava وC++ تفرض أن تكون عناصر الحاوية من نوع محدد وقت الترجمة، مما يتيح تحسينات ويمنع أخطاء مبكرا. أما اللغات ذات الأنواع الديناميكية كـPython وJavaScript فتسمح بتخزين أي شيء في أي حاوية، وهذا يمنح مرونة وسرعة في كتابة النماذج الأولية لكنه يؤجل اكتشاف الأخطاء إلى وقت التشغيل ويزيد حمل الذاكرة لأن كل قيمة تحمل معلومات نوعها.
والمحور الثالث هو مستوى التجريد وطريقة تقديم الهياكل. فـPython تدمج القوائم والقواميس في صلب صياغتها بأقواس مباشرة، وJava تقدم إطارا محكما من الواجهات والتنفيذات، وC++ تقدم قوالب قابلة للتخصيص بلا حمل وقت التشغيل، وJavaScript تخلط الكائنات والقواميس في كيان واحد تاريخيا ثم تفصلهما بـMap. وتؤثر هذه الفلسفات في أسلوب التفكير عند التصميم، فمبرمج Python يسأل أي هيكل مدمج يناسبني، ومبرمج C يسأل كيف أبني هذا الهيكل بكفاءة.
هل توفر لغات البرمجة هياكل بيانات جاهزة أم يجب بناؤها يدويا؟
تقدم أغلب اللغات الحديثة هياكل جاهزة تغطي الاحتياجات الشائعة، ولا حاجة إلى بنائها يدويا في الإنتاج عادة. فمكتباتها القياسية كتبت ودققت وحسنت على يد خبراء واختبرت على نطاق واسع وتتعامل مع الحالات الحدية والتزامن والأداء بصورة يصعب مجاراتها في تنفيذ سريع. ولذلك تنص الممارسة الهندسية السليمة على البدء بالجاهز، فهو أسرع تطويرا وأقل أخطاء وأسهل قراءة على بقية الفريق. وبناء هيكل يدوي مكان هيكل جاهز دون مبرر قياسي يعد من علامات الهندسة المفرطة.
ومع ذلك توجد حالات مشروعة للبناء اليدوي. أولها التعلم، فتنفيذ قائمة مرتبطة أو شجرة بحث أو جدول تجزئة بنفسك هو أفضل وسيلة لفهم آليتها، وهو ما تختبره المقابلات التقنية. وثانيها غياب الهيكل المطلوب من المكتبة القياسية، كغياب شجرة متوازنة مرتبة في Python أو غياب DSU وشجرة المقاطع وشجرة فينويك في أغلب اللغات. وثالثها الحاجة إلى سلوك مخصص كذاكرة LRU بسياسة خاصة أو تخطيط ذاكرة مضبوط للأداء الأقصى في الألعاب والأنظمة المدمجة.
وتوجد منطقة وسطى عملية تتمثل في المكتبات الخارجية الناضجة. فمكتبة sortedcontainers في Python توفر قوائم وقواميس مرتبة بكفاءة عالية، ومكتبة Guava في Java تقدم مجموعات متعددة وخرائط ثنائية الاتجاه، ومكتبة Boost في C++ تضيف رسوما بيانية وحاويات متقدمة، ومكتبة Immutable.js توفر هياكل غير قابلة للتغيير لـ JavaScript. وهكذا يكون التدرج الصحيح بالبدء بالمدمج ثم المكتبات الموثوقة وأخيرا التنفيذ اليدوي عند الضرورة القصوى.
مقارنة بين هياكل البيانات المدمجة والمخصصة
يلخص الجدول التالي أسماء هياكل البيانات الشائعة في اللغات الأربع، ويساعد على نقل المعرفة من لغة إلى أخرى بسرعة. ويلاحظ أن الاختلاف في الأسماء وليس في المفاهيم، وأن بعض الهياكل غائبة في لغات معينة فتعوض بالمحاكاة أو بمكتبة خارجية.
| الهيكل | Python | Java | C++ | JavaScript |
|---|---|---|---|---|
| مصفوفة ديناميكية | list | ArrayList | vector | Array |
| قائمة مرتبطة | غير مدمجة (deque قريبة) | LinkedList | list | غير مدمجة |
| مكدس | list أو deque | ArrayDeque | stack | Array (push/pop) |
| طابور | deque | ArrayDeque أو LinkedList | queue أو deque | Array (push/shift) |
| قاموس (جدول تجزئة) | dict | HashMap | unordered_map | Map أو Object |
| مجموعة | set | HashSet | unordered_set | Set |
| خريطة مرتبة | غير مدمجة (sortedcontainers) | TreeMap | map | غير مدمجة |
| كومة (طابور أولوية) | heapq | PriorityQueue | priority_queue | غير مدمجة |
| شجرة ورسم بياني | غير مدمجة | غير مدمجة | غير مدمجة | غير مدمجة |
الفرق بين الهياكل المدمجة (Built-in) والهياكل التي تبنيها يدوياً (Custom Implementation)
تأتي الهياكل المدمجة (Built-in) مع اللغة أو مكتبتها القياسية جاهزة للاستخدام ومحسنة غالبا بـشيفرة منخفضة المستوى سريعة. فـقاموس Python مكتوب بلغة C ومحسن لعقود، ولن يضاهيه قاموس مكتوب بـ Python نفسها في السرعة. أما الهياكل المخصصة (Custom) فيبنيها المبرمج بنفسه لحاجة محددة، فتمنحه تحكما كاملا في السلوك والتخزين وتتيح إضافة عمليات غير متوفرة، لكنها تكلفه وقتا في الكتابة والاختبار والصيانة، وتحمله مسؤولية الأخطاء والأداء. ويوضح الجدول التالي أهم الفروق:
| وجه المقارنة | الهياكل المدمجة (Built-in) | الهياكل المخصصة (Custom) |
|---|---|---|
| الجاهزية | جاهزة فورا مع اللغة | تحتاج كتابة واختبارا |
| الأداء | محسنة غالبا بشيفرة أصلية | يتوقف على جودة التنفيذ واللغة |
| الموثوقية | مختبرة على نطاق واسع | قد تحمل أخطاء حدية خفية |
| المرونة | محدودة بما تقدمه اللغة | كاملة ويمكن تصميمها للحاجة |
| الصيانة | يتولاها مطورو اللغة | يتحملها فريق المشروع |
| سهولة القراءة | مألوفة لكل المطورين | تحتاج توثيقا وشرحا |
| التزامن | تتوفر نسخ آمنة للخيوط | يجب تصميمه وحمايته يدويا |
| أفضل استخدام | أغلب التطبيقات الإنتاجية | التعلم والهياكل غير المتوفرة والتحسين الدقيق |
الأخطاء الشائعة عند التعامل مع هياكل البيانات
تتكرر أخطاء بعينها عند المبتدئين وكثير من المحترفين على حد سواء، ولا تعود في الغالب إلى قلة الذكاء بل إلى غياب عادات تحليل محددة. ويمتاز الخطأ في هذا المجال بأنه يتأخر ظهوره، فالشيفرة تعمل بصورة سليمة أمام بيانات الاختبار الصغيرة، ثم تنهار عند الإنتاج حين تكبر البيانات أو تتزامن الطلبات. ولذلك كان تعلم هذه الأخطاء مسبقا أرخص وسيلة لتفاديها. وسنستعرض في هذا القسم أبرزها مع أسبابها وطرق الوقاية منها.
وتنقسم الأخطاء عموما إلى ثلاث فئات. الأولى أخطاء الاختيار، حين يختار المبرمج هيكلا لا يناسب نمط الاستخدام. والثانية أخطاء التنفيذ، كسوء التعامل مع المؤشرات والحالات الحدية. والثالثة أخطاء التقييم، كالثقة بالتحليل النظري دون قياس. وتجمع القائمة التالية أهم ما سنناقشه:
- اختيار هيكل غير مناسب للمهمة كالبحث الخطي المتكرر في قائمة كبيرة.
- تجاهل استهلاك الذاكرة وحملها الإضافي في الأحجام الكبيرة.
- إهمال العناصر المكررة وترتيب البيانات عند اختيار الحاوية.
- سوء التعامل مع المؤشرات والمراجع وما ينتج عنه من تسريبات وانهيارات.
- إهمال الحالات الحدية والأخطاء المنطقية كالقائمة الفارغة والعنصر الوحيد.
- الاعتماد على التعقيد النظري دون قياس الأداء الفعلي.
اختيار هيكل بيانات غير مناسب للمهمة
أكثر الأخطاء شيوعا هو استخدام الهيكل المألوف بدل المناسب. فكثير من المطورين يضعون كل شيء في قوائم لأنها أول ما تعلموه، ثم يبحثون فيها داخل حلقات متداخلة، فتصبح التكلفة تربيعية دون أن ينتبهوا. ومثال ذلك فحص وجود كل عنصر من قائمة في قائمة أخرى كبيرة، وهو ما يتحول إلى ملايين المقارنات، بينما يكفي تحويل القائمة الثانية إلى مجموعة ليصبح الفحص ثابتا. وهذا التعديل البسيط قد يحول برنامجا يعمل عشر دقائق إلى برنامج يعمل ثانية واحدة.
ويحدث الخطأ المعاكس كذلك، وهو التعقيد المبكر حين يستخدم المبرمج هيكلا متقدما لبيانات صغيرة لا تستفيد منه. فشجرة متوازنة لخمسين عنصرا تضيف شيفرة أكثر وأخطاء محتملة دون أي ميزة ملموسة في السرعة. ومن أنواع الاختيار الخاطئ كذلك استخدام قائمة كطابور عبر حذف العنصر الأول مرارا، أو استخدام قاموس حين يهم الترتيب حسب القيمة، أو استخدام مصفوفة حين تكثر الإدراجات في المنتصف. والوقاية تتم بتحديد العمليات الأكثر تكرارا قبل الاختيار.
ويفيد في تفادي هذا الخطأ تدريب بسيط قبل كل قرار. اكتب قائمة بالعمليات المطلوبة ورتبها بحسب التكرار، ثم ابحث عن الهيكل الذي يخدم أعلاها تكرارا بأقل كلفة، وراجع ما إذا كانت العمليات الأخرى ستتحمل كلفته. وإن ترددت بين خيارين، فاكتب اختبار أداء صغيرا بحجم بيانات قريب من الواقع، فالقياس يحسم الجدل بسرعة. ولا تنس توثيق سبب الاختيار في تعليق قصير ليفهمه من يقرأ الشيفرة لاحقا.
تجاهل استهلاك الذاكرة
يركز المبتدئون على سرعة التنفيذ وينسون أن للذاكرة سقفا صلبا لا يرحم. فبرنامج سريع يستهلك ذاكرة أكبر من المتاحة ينهار أو يلجأ إلى التبديل على القرص فيبطؤ بصورة كارثية. ويكمن الخطر في الحمل الإضافي غير المرئي، فقائمة Python من عشرة ملايين عدد صحيح قد تستهلك مئات الميغابايتات لأن كل عنصر كائن مستقل بمؤشر، بينما تكفي مصفوفة NumPy بحجم أقل بكثير. وكذلك تستهلك القواميس والمجموعات ذاكرة أكبر من القوائم بسبب الحاويات الاحتياطية.
ومن صور هذا الخطأ تحميل البيانات كلها في الذاكرة عندما تكفي معالجتها على دفعات. فقراءة ملف ضخم دفعة واحدة في قائمة تستهلك حجمه أضعافا، بينما يكفي المرور عليه سطرا بسطر بـمولد (Generator) أو مكرر. ومنها كذلك الاحتفاظ بمراجع قديمة لكائنات لم تعد مطلوبة، فيعجز جامع النفايات عن تحريرها وتتراكم كـتسريب بطيء (Memory Leak) ينهار به الخادم بعد أيام. وتشمل الأمثلة الشائعة ذاكرات مؤقتة بلا حد أقصى تنمو للأبد.
ويعالج هذا الخطأ بعادات منتظمة. قدر حجم البيانات مسبقا واحسب الذاكرة المطلوبة تقريبيا، واستخدم أدوات القياس مثل sys.getsizeof وtracemalloc في Python أو المحللات في Java. واختر تمثيلات مدمجة عند الحاجة كالمصفوفات المتجانسة ومصفوفات البت ومرشح بلوم، وضع حدودا قصوى لكل ذاكرة مؤقتة مع سياسة إخلاء واضحة كـLRU. ولا تنس أن ذروة الاستهلاك تحدث أثناء العمليات المؤقتة كالتوسع وإعادة التجزئة، فاحسب لها هامشا.
عدم الانتباه إلى العناصر المكررة وترتيب البيانات
يسبب تجاهل التكرار والترتيب أخطاء منطقية صامتة أخطر من الأخطاء التي توقف البرنامج، لأنها تنتج نتائج خاطئة دون أي تحذير. فاستخدام مجموعة عند الحاجة إلى عد التكرارات يضيع المعلومة تلقائيا، واستخدام قائمة عند اشتراط التفرد يسمح بإدخال قيم مكررة تفسد الإحصاءات أو تكرر إرسال الرسائل. وكذلك يؤدي تخزين مفاتيح مكررة في قاموس إلى استبدال القيمة القديمة بالجديدة بصمت، فتفقد بيانات كان يجب حفظها، مثل تخزين طلبات عميل بمفتاح اسمه فقط.
وتتفاقم المشكلة عند الاعتماد على ترتيب غير مضمون. فعناصر المجموعة لا تحتفظ بترتيب معين في أغلب اللغات، وقد يتغير الترتيب بين تشغيل وآخر أو بين إصدارين من اللغة، فيبني المبرمج منطقا على ترتيب ظهر صدفة أثناء الاختبار فينهار في الإنتاج. وهناك كذلك مشكلة استقرار الترتيب (Stability) عند ترتيب عناصر بمفاتيح متساوية، فبعض الخوارزميات تحفظ الترتيب الأصلي للعناصر المتساوية وبعضها لا تحفظه، وهو أمر يهم عند الترتيب بعدة معايير متتالية.
وللوقاية يجب تحديد متطلبات التفرد والترتيب صراحة عند التصميم. فإن كان التفرد مطلوبا فاستخدم مجموعة أو قاموسا، وإن كان التكرار مهما فاستخدم قائمة أو عدادا. وإن كان ترتيب الإدراج مهما فاختر حاوية تضمنه كـdict في Python الحديثة أو LinkedHashMap، وإن كان الترتيب حسب القيمة مهما فاستخدم شجرة مرتبة أو رتب عند الحاجة. واكتب اختبارات تتضمن بيانات مكررة ومرتبة بالعكس ومتساوية القيم لكشف هذه المشكلات مبكرا.
سوء التعامل مع المؤشرات والمراجع
تعد المؤشرات والمراجع من أكثر مصادر الأخطاء إرباكا في هياكل البيانات المرتبطة. ففي لغات مثل C و C++ تظهر أخطاء قاتلة كالوصول إلى مؤشر فارغ (Null Pointer Dereference) أو مؤشر معلق (Dangling Pointer) يشير إلى ذاكرة حررت بالفعل، أو تحرير الذاكرة مرتين (Double Free)، أو نسيان تحريرها فتتسرب. وتنتج هذه الأخطاء سلوكا غير محدد يختلف من تشغيل لآخر ويصعب تتبعه، وقد تتحول إلى ثغرات أمنية خطيرة كما حدث في عدد كبير من الاختراقات المعروفة.
وتظهر المشكلة بصورة أخف في اللغات المدارة. فمن أشهر أخطاء Python نسخ قائمة متداخلة بالإسناد أو بـالنسخ السطحي (Shallow Copy) فتشترك النسخ في القوائم الداخلية نفسها وتتأثر بتعديل إحداها. ومنها كذلك إنشاء مصفوفة ثنائية بالضرب [[0] * 3] * 3 فتتكرر المرجع نفسه في الصفوف الثلاثة. وفي Java يؤدي تعديل كائن مستخدم مفتاحا في HashMap إلى فقدانه لأن قيمة التجزئة تغيرت، كما تتسبب المراجع الحية القديمة في تسريبات الذاكرة.
وتتلخص الوقاية من هذه الأخطاء في عادات واضحة. افحص المؤشر قبل استخدامه، وصفر المؤشر بعد التحرير في C، وفضل المؤشرات الذكية وRAII في C++ التي تدير الذاكرة تلقائيا، واستخدم أدوات الكشف مثل Valgrind وAddressSanitizer. وفي اللغات المدارة افهم الفرق بين النسخ السطحي والعميق، واستخدم كائنات غير قابلة للتغيير كمفاتيح، وارسم المؤشرات على ورقة قبل كتابة عمليات الإدراج والحذف في القوائم والأشجار.
إهمال الحالات الحدية والأخطاء المنطقية
تعمل أغلب الشيفرات ممتازة في الحالة العادية وتفشل عند الحدود، ولهذا تدور أغلب أخطاء هياكل البيانات حول حالات محددة متكررة. فـالهيكل الفارغ هو الحالة الأولى، إذ يحاول المبرمج سحب عنصر من مكدس فارغ أو قراءة رأس قائمة لا رأس لها. والهيكل ذو العنصر الواحد هو الحالة الثانية، فحذف آخر عقدة في قائمة يتطلب تصفير مؤشري الرأس والذيل معا، وكثيرا ما ينسى أحدهما. والحالة الثالثة هي العنصر الأول والأخير، حيث تختلف عمليات الإدراج والحذف عن المنتصف.
وتضاف إليها أخطاء منطقية كلاسيكية تتكرر عبر اللغات. فـخطأ الإزاحة بواحد (Off-by-one) يسبب تجاوز حدود المصفوفة أو إهمال العنصر الأخير في الحلقات والبحث الثنائي. والعودية بلا شرط توقف سليم تستنفد المكدس وتنتهي بخطأ الفيض. وحذف عنصر أثناء المرور على القائمة نفسها يخلخل الفهارس ويتخطى عناصر، وتعديل قاموس أثناء المرور عليه يطلق استثناء في بعض اللغات ويعطي نتائج خاطئة في أخرى. ومنها كذلك عدم معالجة القيم المتساوية في أشجار البحث والمقارنات غير المتسقة.
ويتطلب علاج هذه المشكلات انضباطا في الاختبار أكثر من موهبة خاصة. اكتب اختبارات وحدة تغطي الحالات الحدية بصورة منهجية، وهي الفارغ والعنصر الواحد والعنصران والتكرار والقيم القصوى والصغرى والمدخلات المرتبة والمعكوسة. واستخدم اختبارات الخصائص (Property-based Testing) مثل مكتبة Hypothesis في Python التي تولد مدخلات عشوائية وتبحث عن حالات تكسر الشيفرة. وأضف دوال تحقق داخلية (Invariant Checks) تفحص سلامة الهيكل بعد كل عملية أثناء التطوير، كالتأكد من خاصية الكومة أو توازن الشجرة.
الاعتماد على التعقيد النظري دون قياس الأداء الفعلي
يقع كثير من المطورين في فخ تقديس ترميز Big O وكأنه حكم نهائي على الأداء. لكن هذا الترميز يصف معدل النمو عند الأحجام الكبيرة ويتجاهل الثوابت المضروبة وتأثيرات العتاد. فالبحث الخطي في مصفوفة من مئة عنصر قد يتفوق على البحث في جدول تجزئة لأن حساب التجزئة نفسه له كلفة ثابتة أعلى، ولأن المرور على الذاكرة المتجاورة سريع جدا. وقد تتفوق المصفوفة على القائمة المرتبطة في الإدراج في المنتصف فعليا رغم التعقيد النظري المعاكس، لأن إزاحة كتلة متجاورة تتم بتعليمات عتادية سريعة.
وتتدخل عوامل عملية أخرى لا يلتقطها التحليل النظري. فـالذاكرة المخبئية وتنبؤ التفرع وتكلفة تخصيص الذاكرة وجمع النفايات وتوزيع البيانات الحقيقي كلها تؤثر في الزمن الفعلي. وقد تكون أسوأ حالة نظرية نادرة جدا في بياناتك أو شائعة جدا بحسب طبيعتها، كإدخال بيانات مرتبة في شجرة غير متوازنة. كما أن التحسين المبكر لعملية لا تمثل عنق الزجاجة يهدر الجهد ويزيد التعقيد دون فائدة ملموسة، وهو ما حذر منه دونالد كنوث بعبارته الشهيرة أن التحسين المبكر أصل كل الشرور.
ويكمن الحل في منهج عملي متدرج. ابدأ بالتحليل النظري لاستبعاد الخيارات الضعيفة بوضوح، ثم اكتب اختبارات قياس (Benchmarks) بحجم وتوزيع بيانات يشبهان الواقع، وكررها عدة مرات لتجنب الضوضاء، مستخدما أدوات مثل timeit وcProfile في Python وJMH في Java وGoogle Benchmark في C++. وحدد عنق الزجاجة الحقيقي بالمحللات (Profilers) قبل أي تعديل، وحسن الجزء الذي يستهلك النسبة الكبرى من الزمن فقط. وعند تقارب النتائج اختر الأبسط صيانة، فبساطة الشيفرة ميزة تتراكم مع الزمن.
كيف تتعلم هياكل البيانات وتطبقها عمليا؟
يتعثر كثير من المتعلمين في هذا المجال، لا لصعوبة المفاهيم نفسها، بل لأنهم يتعلمون بطريقة خاطئة. فبعضهم يحفظ التعاريف دون أن يكتب سطرا من الشيفرة، وبعضهم ينسخ الحلول الجاهزة دون أن يفهم سبب عملها، وبعضهم يقفز إلى الأشجار والرسوم البيانية قبل أن يتقن المصفوفات والقوائم. والحقيقة أن هذا المجال يشبه تعلم السباحة، فلا يكفي أن تقرأ عن الماء، بل لا بد أن تنزل إليه وتتحرك فيه بنفسك. وفي هذا القسم نضع خريطة طريق عملية تبدأ من الصفر، وتمر بـالأساسيات والتدريب والمشاريع والمصادر، وتنتهي بـطرق اختبار صحة ما بنيته وكفاءته.
المتطلبات الأساسية قبل تعلم هياكل البيانات
المتطلب الأول هو إتقان لغة برمجة واحدة على الأقل بمستوى مريح. فيجب أن تفهم المتغيرات والشروط والحلقات والدوال والأنواع الأساسية، وأن تستطيع كتابة برنامج صغير دون الرجوع إلى الدليل في كل سطر. ويفضل أن تبدأ بـPython لأن صياغتها مقروءة وتحجب تفاصيل الذاكرة، فتركز على الفكرة نفسها. ويصلح Java أو C++ أيضا لمن يريد فهم الذاكرة والمؤشرات عن قرب. والمهم ألا تتعلم لغتين في آن واحد، فيتشتت جهدك بين الصياغة والمفهوم.
والمتطلب الثاني هو فهم الدوال والعودية (Recursion)، لأن الأشجار والرسوم البيانية وكثيرا من الخوارزميات تعتمد عليها اعتمادا كبيرا. فتدرب على كتابة دوال عودية بسيطة مثل حساب المضروب ومتتالية فيبوناتشي وجمع عناصر قائمة، وتعلم أن تحدد حالة التوقف (Base Case) والحالة العودية بوضوح. وتأكد من فهمك لـمكدس الاستدعاءات الذي شرحناه سابقا، لأن تتبع الدوال العودية على الورق من أنفع التمارين على الإطلاق.
والمتطلب الثالث هو قدر بسيط من الرياضيات، وهو أقل مما يتصور كثيرون. فتحتاج إلى الجبر الأساسي والأسس واللوغاريتمات بمستوى المدرسة الثانوية، وإلى فهم فكرة النمو والدوال، لتستوعب ترميز Big O. أما الرياضيات المتقدمة كـالتفاضل والإحصاء فلا تلزم في البداية، ولا يمنعك ضعفك فيها من تعلم هذا المجال. ويكفي أن تتعامل مع الأرقام بارتياح وأن تفكر بصورة منطقية متسلسلة.
الترتيب المقترح لتعلم هياكل البيانات من الصفر
يعتمد الترتيب الأمثل على مبدأ التدرج من البسيط إلى المركب، بحيث يبنى كل هيكل على ما قبله. فـالمصفوفات أولا لأنها الأساس الذي تبنى عليه أغلب الهياكل، ثم القوائم المرتبطة لفهم المؤشرات، ثم المكدسات والطوابير كتطبيقات مقيدة عليهما. وبعدها جداول التجزئة والمجموعات والقواميس لأهميتها العملية الكبيرة، ثم الأشجار وأشجار البحث، ثم الكومات، ثم الرسوم البيانية التي تجمع كل ما سبق، وأخيرا الهياكل المتقدمة. ويسير تعلم ترميز Big O بالتوازي مع كل هيكل منذ اليوم الأول:
- المرحلة الأولى: المصفوفات والقوائم المرتبطة مع أساسيات Big O وتحليل التعقيد.
- المرحلة الثانية: المكدسات والطوابير والطوابير مزدوجة النهاية مع تطبيقاتها الكلاسيكية.
- المرحلة الثالثة: جداول التجزئة والمجموعات والقواميس ومعالجة التصادم.
- المرحلة الرابعة: الأشجار الثنائية وأشجار البحث والاجتياز ثم الأشجار المتوازنة نظريا.
- المرحلة الخامسة: الكومات وطوابير الأولوية ثم الرسوم البيانية وخوارزميات BFS وDFS.
- المرحلة السادسة: الهياكل المتقدمة كـ Trie وDSU وشجرة المقاطع عند الحاجة.
كيف تتدرب على بناء هياكل البيانات بنفسك؟
أنجع طريقة للتعلم هي بناء كل هيكل من الصفر قبل استخدام النسخة الجاهزة. فاكتب قائمة مرتبطة بنفسك بعقدها ومؤشراتها، ثم مكدسا وطابورا فوقها، ثم جدول تجزئة بسيطا بالتسلسل المنفصل، ثم شجرة بحث ثنائية بكل عملياتها. ولا تنسخ الشيفرة من المصدر، بل اقرأ الفكرة ثم أغلق الشاشة واكتبها من ذاكرتك، فإن تعثرت عد إلى المصدر ثم أعد المحاولة. فهذا التمرين يحول الفهم السطحي إلى مهارة راسخة، ويكشف لك مواضع الضعف بوضوح.
ويكمل هذا التدريب حل المسائل البرمجية المنظمة على منصات متخصصة. فابدأ بمسائل سهلة لكل هيكل، وانتقل إلى المتوسطة بعد إتقانها، وخصص وقتا ثابتا يوميا ولو ثلاثين دقيقة، فالانتظام أفضل من الجلسات الطويلة المتباعدة. وعند تعثرك في مسألة، فكر فيها عشرين دقيقة على الأقل قبل النظر إلى الحل، ثم أعد كتابته بنفسك دون نظر. وسجل كل مسألة أخطأت فيها في دفتر ملاحظات لتراجعها بعد أسابيع. ومن أفضل العادات:
- ارسم الهيكل على ورقة قبل الكتابة وتتبع المؤشرات خطوة بخطوة.
- اشرح الحل بصوت عال كأنك تعلمه لشخص آخر لتكشف الثغرات.
- حلل التعقيد الزمني والمكاني لكل حل بعد كتابته.
- أعد حل المسألة نفسها بهيكل مختلف وقارن النتائج.
- اكتب اختبارات للحالات الحدية قبل اعتبار الحل منتهيا.
مشاريع تطبيقية لتطوير مهاراتك في هياكل البيانات
تثبت المشاريع التطبيقية المعرفة بصورة لا تفعلها التمارين المنفصلة، لأنها تضعك أمام قرارات اختيار حقيقية وتجبرك على ربط الهياكل ببعضها. فاختر مشروعا صغيرا يمكن إنجازه خلال أسبوع أو أسبوعين، وحدد مسبقا أي الهياكل ستستخدم ولماذا، ثم قارن اختيارك بالبدائل بعد الانتهاء. ولا تحتاج إلى واجهة رسومية معقدة، فسطر الأوامر يكفي تماما، فالهدف هو المنطق الداخلي. وفيما يلي أفكار مدروسة تغطي الهياكل الرئيسية:
- محرر نصوص بسيط مع التراجع والإعادة باستخدام مكدسين.
- نظام حجز تذاكر أو طابور خدمة عملاء باستخدام الطوابير وطابور الأولوية.
- دليل هاتف مع بحث سريع وإكمال تلقائي باستخدام القواميس وشجرة Trie.
- ذاكرة مؤقتة LRU باستخدام قاموس وقائمة مرتبطة ثنائية الاتجاه.
- تطبيق خرائط مصغر يجد أقصر طريق بين مدن باستخدام رسم بياني وخوارزمية ديكسترا.
- نظام ملفات افتراضي صغير يعرض المجلدات كشجرة ويدعم البحث والاجتياز.
أهم المصادر والمراجع لمعرفة ودراسة هياكل البيانات
تتعدد المصادر الجيدة لتعلم هذا المجال، ولا حاجة إلى جمعها كلها، بل يكفي اختيار كتاب أو دورة مرجعية واحدة مع منصة للتدريب وأداة للتصور المرئي. وتتمايز المصادر بحسب الغرض، فـالكتب الأكاديمية تعطي العمق الرياضي والدقة، والدورات التفاعلية تعطي التدرج والتطبيق، والمنصات التدريبية تعطي الممارسة، وأدوات التصور تجعل العمليات المجردة مرئية تتحرك أمامك. ويلخص الجدول التالي أبرز المصادر المعروفة وطريقة الاستفادة من كل منها:
| المصدر | النوع | أفضل استخدام |
|---|---|---|
| Introduction to Algorithms (CLRS) | كتاب أكاديمي مرجعي | العمق النظري والتحليل الرياضي للمستوى المتقدم |
| Algorithms by Sedgewick and Wayne | كتاب وموقع مصاحب بشيفرة Java | التنفيذ العملي والشرح المتدرج للهياكل الأساسية |
| Algorithms Part I (Princeton, Coursera) | دورة جامعية مسجلة | تعلم منظم بالفيديو مع تمارين مبرمجة |
| CS50 من جامعة هارفارد | دورة مجانية تمهيدية | البداية من الصفر مع أساسيات البرمجة والهياكل |
| VisuAlgo | أداة تصور تفاعلية | مشاهدة الهياكل والخوارزميات وهي تعمل خطوة بخطوة |
| Data Structure Visualizations (USFCA) | محاكيات مرئية | تجربة الإدراج والحذف في الأشجار والكومات والتجزئة |
| Big-O Cheat Sheet | مرجع سريع | مراجعة تعقيد العمليات في الهياكل والترتيبات |
| LeetCode | منصة مسائل برمجية | التدريب على المسائل المصنفة بحسب الهيكل والصعوبة |
| GeeksforGeeks | موسوعة تعليمية عملية | شروح سريعة وأمثلة بلغات متعددة |
| توثيق Python الرسمي للهياكل | توثيق رسمي | فهم الهياكل المدمجة في Python وتكاليف عملياتها |
| Java Collections Framework | توثيق رسمي | فهم الواجهات والتنفيذات في Java |
كيف تختبر صحة تنفيذ هيكل البيانات وكفاءته؟
يبدأ اختبار الصحة باختبارات الوحدة (Unit Tests) التي تتحقق من كل عملية على حدة. فتختبر الإدراج ثم تتأكد من أن العنصر موجود، وتختبر الحذف ثم تتأكد من غيابه، وتختبر حجم الهيكل بعد كل عملية. وتشمل هذه الاختبارات الحالات الحدية بصورة صريحة، وهي الهيكل الفارغ والعنصر الواحد والعنصران والقيم المكررة والإدراج في البداية والمنتصف والنهاية والحذف من المواضع نفسها. وتفيد أطر مثل pytest في Python وJUnit في Java في تنظيم هذه الاختبارات وتشغيلها تلقائيا بعد كل تعديل.
ثم تأتي المقارنة بنسخة مرجعية موثوقة، وهي من أقوى طرق كشف الأخطاء الخفية. فتولد آلاف العمليات العشوائية من إدراج وحذف وبحث، وتنفذها على هيكلك المبني يدويا وعلى الهيكل المدمج المكافئ، ثم تقارن النتائج بعد كل عملية. فإذا اختلفت النتيجة ولو مرة واحدة فثمة خطأ يمكن تتبعه بإعادة تشغيل العملية ذاتها ببذرة عشوائية ثابتة. وتضيف اختبارات الخصائص (Property-based Testing) طبقة أخرى، كالتحقق من أن الاجتياز الوسيط لشجرة البحث يعطي قيما مرتبة دائما، وأن الكومة تحقق خاصيتها بعد كل عملية.
أما اختبار الكفاءة فيعتمد على القياس الفعلي وليس الحدس. فشغل عملياتك على أحجام متزايدة مثل ألف وعشرة آلاف ومئة ألف ومليون، وسجل الزمن في كل مرة، ثم ارسم العلاقة أو قارن النسب. فإذا تضاعف الزمن عشر مرات عند ضرب الحجم في عشرة فالسلوك خطي، وإذا تضاعف مئة مرة فهو تربيعي، وبهذا تتحقق من أن تنفيذك يطابق التعقيد المتوقع نظريا. واستخدم المحللات (Profilers) لمعرفة أين يضيع الوقت، وقس الذاكرة بأدوات مثل tracemalloc، وكرر القياس عدة مرات لتتجنب الضوضاء العارضة، واختبر على توزيعات مختلفة من البيانات المرتبة والعشوائية والمعكوسة.
الأدوار الوظيفية والقيمة التشغيلية لهياكل البيانات
كما تعلمنا حتى الآن، تعد هياكل البيانات إلى جانب الخوارزميات الركيزة الأساسية لأي نظام حاسوبي، بل وتتجاوز ذلك لتشكل الهيكل العظمي للأنظمة الرقمية. ويمكن تلخيص الأبعاد الوظيفية الرئيسية لهياكل البيانات في المحاور الآتية:
- تحسين آليات التخزين (Data Storage).
- تسهيل التبادل البيني للمعلومات (Data Exchange).
- إدارة الموارد والخدمات التشغيلية (Resource and Service Management).
- دعم مرونة النظام وقابليته للتوسع (Scalability).
وفي السطور التالية نستعرض هذه المحاور التشغيلية بشيء من التفصيل.
- تحسين آليات التخزين
- من خلال تحديد الخصائص والبنى المناظرة المستخدمة في أنظمة إدارة قواعد البيانات، تسهم هياكل البيانات في تنظيم عمليات التخزين ورفع كفاءتها. وبهذا تصصبح البيانات المهيكلة أكثر سهولة في الإدارة والاسترجاع وأقل استهلاكاً للمساحات الفيزيائية.
- تسهيل التبادل البيني للمعلومات
- تسمح هياكل البيانات بمشاركة المعلومات المنظمة بين البرامج والتطبيقات المختلفة، مثل حزم بروتوكول TCP/IP في الشبكات. وهذا يضمن تدفق البيانات والتواصل بين الأنظمة بشكل موثوق وآمن ودون فقدان للسياق.
- إدارة الموارد والخدمات التشغيلية
- تمكن هياكل البيانات، مثل القوائم المرتبطة والطوابير، أنظمة التشغيل (Operating Systems) من تنفيذ العمليات الحرجة كـإدارة الملفات وتخصيص الذاكرة وتنفيذ خوارزميات الجدولة بكفاءة عالية، مما ينعكس مباشرة على استقرار أداء الحاسوب.
- دعم مرونة النظام وقابليته للتوسع
- تعتمد أدوات تحليل البيانات الضخمة (Big Data) بشكل كلي على هياكل البيانات لإدارة مساحات الذاكرة وتوزيع الأحمال. وهذا النهج يمنح الأنظمة القدرة على المعالجة الفائقة والتوسع السلس مع تزايد حجوم البيانات.
وبشكل عام، تُعد هياكل البيانات الوسيط الجوهري لتنظيم المعلومات وتخزينها واسترجاعها بالتكامل مع الخوارزميات الحاسوبية، لـتحويل البيانات الخام إلى معلومات ذات قيمة تقنية وتشغيلية.
الفوائد والمكاسب التقنية لاستخدام هياكل البيانات
تعتبر البيانات المادة الخام للعمليات الحسابية، لكن هذه البيانات لا تحمل قيمة حقيقية ما لم تُنظم داخل بنى برمجية مدروسة. ومع نمو البيانات وتضخمها، تبرز الحاجة إلى هياكل البيانات لتمكين الخوارزميات من فهم طبيعة المخرجات والمدخلات، مما يرفع الكفاءة الإجمالية للنظام. وتتمثل أبرز المنافع التقنية في النقاط التالية:
- إمكانية التخزين المنظم للمعلومات على القرص الصلب (Hard Disk) وسائط التخزين المختلفة.
- تمثيل البنية الأساسية اللازمة لـتصميم الخوارزميات الفعالة.
- مرونة عالية في إجراء التعديلات والمعالجات على أحجام البيانات الضخمة.
- تسريع عمليات استرجاع البيانات والوصول إليها بأقل زمن تأخير ممكناً.
- توفير وقت مهندسي البرمجيات عند تنفيذ عمليات المعالجة أو الاستعلام أو تصحيح الأخطاء.
- بفضل التطوير المستمر لـهياكل البيانات الكلاسيكية مثل المصفوفة والشجرة والقائمة المرتبطة والمكدس والرسم البياني، أصبح دمج هذه الهياكل واستخدامها في التطبيقات أكثر سهولة ومرونة.
مفهوم التعقيد الزمني وسلوك نمو الدوال
التعقيد التنفيذي أو سلوك نمو الدوال (Time Complexity) من أهم معايير القياس في مجالي هندسة البرمجيات وتكنولوجيا معلومات. ويُقصد به مقدار الوقت الكلي الذي تستغرقه الخوارزمية لتنفيذ مهامها بناءً على عدد المدخلات المتغيرة $n$. وبمعنى آخر، يوضح هذا المفهوم كيف يتدرج وقت التنفيذ ويزداد مع تضخم حجم البيانات $n$، ويُقاس ذلك باستخدام ترميز O الكبير (Big O Notation) مثل $O(n)$.
فعلى سبيل المثال، يبلغ التعقيد التنفيذي للوصول المباشر إلى أي عنصر داخل قوائم بايثون (Python Lists) زَمناً ثابتاً يعادل $O(1)$ بغض النظر عن حجم القائمة، لأنها تعتمد على الوصول العشوائي المباشر في الذاكرة. في المقابل، يبلغ التعقيد التنفيذي للبحث عن عنصر غير مفهرس داخل مصفوفة أحادية البعد زَمناً خطياً يعادل $O(n)$. لذلك، يجب على المبرمجين تقييم التعقيد الزمني لهياكل البيانات قبل اعتمادها في المشاريع البرمجية لضمان أعلى مستويات الأداء.
لماذا تعد هياكل البيانات أساسا لفهم البرمجة؟
تعد هياكل البيانات اللغة المشتركة التي يتحدث بها كل المبرمجين المحترفين، فهي تحول التفكير من كتابة أوامر متفرقة إلى تصميم حلول منظمة. فعندما يواجه المبرمج مشكلة جديدة، يسأل أولا ما شكل البيانات وما العمليات المطلوبة عليها ثم يختار الهيكل الأنسب، وهذا الأسلوب في التفكير هو ما يميز المهندس عن كاتب الشيفرة المجرد. وتمنحه هذه المعرفة قدرة على التنبؤ بسلوك حله عند تضخم البيانات قبل أن يكتب سطرا واحدا، وعلى تشخيص البطء وتحسينه بدل الاكتفاء بزيادة قوة الأجهزة.
وتمتد أهمية هذه المعرفة إلى كل ما بنيت عليه التقنية الحديثة. فـقواعد البيانات التي تحفظ معلوماتك تعتمد على أشجار B+ وجداول التجزئة، ومحركات البحث تعتمد على الفهارس المعكوسة والرسوم البيانية، وأنظمة التشغيل تعتمد على الطوابير والأشجار، ونماذج الذكاء الاصطناعي تعتمد على المصفوفات متعددة الأبعاد والفهارس الرسمية. ومن يفهم هذه الهياكل يستطيع أن يفهم ما تحت غطاء الأدوات التي يستخدمها يوميا، فلا تبقى صناديق سوداء غامضة بل منظومات مفهومة يمكن ضبطها واستثمارها.
وأخيرا تعد هذه المهارة استثمارا طويل الأمد لأنها لا تتقادم بسرعة كالأطر واللغات. فاللغات تظهر وتختفي والأطر تتبدل كل بضعة أعوام، لكن مبادئ تنظيم البيانات وتحليل الكفاءة ظلت ثابتة منذ عقود وستبقى كذلك. ولهذا تركز عليها المناهج الجامعية ومقابلات التوظيف في كبرى شركات التقنية، ولهذا أيضا ينتقل أصحابها بين المجالات من تطوير الويب إلى الذكاء الاصطناعي إلى هندسة الأنظمة بسهولة أكبر من غيرهم. فمن أراد أن يفهم البرمجة فهما حقيقيا فليبدأ من هنا.
الأسئلة الشائعة حول هياكل البيانات
يطرح المتعلمون والمطورون أسئلة متكررة حول هذا المجال، بعضها يخص المفاهيم الأساسية وبعضها يخص التعلم والاختيار. وقد جمعنا أهمها فيما يلي مع إجابات مركزة تلخص ما ورد في هذا الدليل، وتصلح مرجعا سريعا عند الحاجة إلى مراجعة سريعة قبل مقابلة أو امتحان أو قرار تصميم.
ما المقصود بهياكل البيانات باختصار؟
هياكل البيانات هي أساليب منظمة لتخزين البيانات داخل الحاسوب وإدارتها بحيث تنفذ العمليات عليها بكفاءة. فهي تحدد كيف ترتب القيم في الذاكرة وما العلاقات بينها وما العمليات المسموحة كالإضافة والحذف والبحث والترتيب. ويتفاوت أداء البرنامج تفاوتا كبيرا بحسب الهيكل المختار، ولذلك تعد من أهم أسس علوم الحاسوب وهندسة البرمجيات.
ما أشهر أنواع هياكل البيانات؟
أشهر الأنواع هي المصفوفات والقوائم المرتبطة والمكدسات والطوابير وجداول التجزئة والمجموعات والقواميس والأشجار والكومات والرسوم البيانية. وتضاف إليها هياكل متقدمة أقل شيوعا كأشجار Trie وشجرة المقاطع وشجرة فينويك وهيكل DSU ومرشح بلوم وقائمة التخطي. ويصنفها المختصون إلى خطية وغير خطية وثابتة وديناميكية ومجرّدة وملموسة.
ما الفرق بين هياكل البيانات الخطية وغير الخطية؟
ترتب الهياكل الخطية عناصرها في تسلسل واحد يأتي فيه كل عنصر بعد الذي قبله، كالمصفوفات والقوائم والمكدسات والطوابير، ويمكن المرور عليها بحلقة بسيطة. أما غير الخطية فتنشئ علاقات متفرعة يرتبط فيها العنصر بعدة عناصر، كالأشجار والرسوم البيانية، وتحتاج إلى خوارزميات اجتياز خاصة. وتتفوق غير الخطية في تمثيل العلاقات الهرمية والشبكية وتسريع البحث اللوغاريتمي.
ما الفرق بين المصفوفة والقائمة المرتبطة؟
تخزن المصفوفة عناصرها في كتلة متجاورة من الذاكرة وتتيح الوصول الفوري بالفهرس بزمن ثابت، لكن الإدراج والحذف في المنتصف مكلفان بسبب الإزاحة. أما القائمة المرتبطة فتخزن عقدا متفرقة ترتبط بمؤشرات، فيكون الإدراج والحذف فيها سريعين بعد الوصول إلى الموضع، لكن الوصول إلى عنصر معين يتطلب المرور على ما قبله. وتتفوق المصفوفة عمليا في كثير من الحالات بفضل الذاكرة المخبئية.
ما الفرق بين المكدس والطابور؟
يعمل المكدس بمبدأ آخر من يدخل أول من يخرج (LIFO)، فتتم الإضافة والإزالة من طرف واحد هو القمة، ويناسب التراجع واستدعاء الدوال والتحقق من الأقواس. أما الطابور فيعمل بمبدأ أول من يدخل أول من يخرج (FIFO)، فتتم الإضافة من الخلف والإزالة من الأمام، ويناسب جدولة المهام والشبكات والخدمة العادلة. وكلاهما ينفذ عملياته الأساسية بزمن ثابت.
ما أفضل هيكل بيانات للبحث السريع؟
يعد جدول التجزئة الأسرع للبحث بالمفتاح إذ يصل إلى القيمة بزمن متوسط ثابت. وإذا احتجت إلى البحث مع الحفاظ على الترتيب أو الاستعلام على النطاقات، فـالأشجار المتوازنة كشجرة أحمر وأسود وأشجار B+ هي الأنسب بزمن لوغاريتمي. وللبحث في مصفوفة مرتبة يكفي البحث الثنائي، وللبحث عن البادئات النصية تتفوق شجرة Trie. فلا يوجد هيكل أفضل في المطلق، بل يتوقف الأمر على نوع البحث.
هل تختلف هياكل البيانات من لغة برمجة إلى أخرى؟
المفاهيم ثابتة عبر اللغات، فالمكدس مكدس في Python وJava وC++ بالسلوك نفسه. لكن الاختلاف يظهر في التنفيذ والأسماء والجاهزية، فما يسمى list في Python يسمى ArrayList في Java وvector في C++. وتتفاوت اللغات في مقدار ما توفره من هياكل مدمجة، وفي إدارة الذاكرة وتكاليف العمليات، فتقدم C القليل وتقدم Java وPython الكثير. ولذلك يسهل انتقال من أتقن المفاهيم من لغة إلى أخرى.
هل يمكن تعلم هياكل البيانات دون معرفة متقدمة بالرياضيات؟
نعم، يمكن تعلمها دون رياضيات متقدمة، فالمطلوب هو الجبر الأساسي وفهم الأسس واللوغاريتمات بمستوى المرحلة الثانوية. وتكفي هذه الخلفية لاستيعاب ترميز Big O وتحليل التعقيد على مستوى التطبيق العملي. أما التعمق الرياضي كإثبات الصحة والتحليل المطفأ والاحتمالات في الهياكل الاحتمالية فيأتي لاحقا لمن يريد التخصص الأكاديمي. والأهم من الرياضيات هو التفكير المنطقي والتدرب على كتابة الشيفرة.
ما العلاقة بين هياكل البيانات والخوارزميات؟
هيكل البيانات ينظم المعلومات في الذاكرة، والخوارزمية هي سلسلة الخطوات التي تعمل عليها لحل مسألة. والعلاقة بينهما تكاملية، فكل خوارزمية تفترض هيكلا تعمل عليه، وكل هيكل يحدد كفاءة الخوارزميات التي تستخدمه. فخوارزمية ديكسترا تحتاج إلى كومة ورسم بياني، والبحث الثنائي يحتاج إلى مصفوفة مرتبة. ولذلك تدرس معا في مقرر واحد، ويعد اختيار الهيكل جزءا من تصميم الخوارزمية.
ما الفرق بين هياكل البيانات وقواعد البيانات؟
هياكل البيانات أساليب برمجية لتنظيم البيانات داخل ذاكرة البرنامج أثناء تشغيله، وتزول بانتهائه. أما قواعد البيانات فهي أنظمة مستقلة تحفظ البيانات بصورة دائمة على الأقراص وتدير الوصول إليها بين عدة مستخدمين مع ضمانات المعاملات والأمان. وتستخدم قواعد البيانات نفسها هياكل بيانات داخلية كأشجار B+ وجداول التجزئة، ويستخدم المطور الاثنين معا في التطبيق الواحد.
ما الفرق بين هياكل البيانات ومراكز البيانات؟
هياكل البيانات مفهوم برمجي منطقي لتنظيم القيم داخل الذاكرة وتقاس كفاءتها بالتعقيد الزمني والمكاني. أما مراكز البيانات فهي منشآت مادية تضم الخوادم والتخزين والشبكات والطاقة والتبريد لاستضافة الأنظمة وضمان استمرارها، وتقاس جودتها بالتوافرية وكفاءة الطاقة. ولا علاقة بين المفهومين سوى أن البرمجيات المستضافة في مراكز البيانات تعتمد على هياكل البيانات لتستثمر موارد تلك المراكز بكفاءة.
لماذا تعد هياكل البيانات مهمة لمبرمجي البرمجيات؟
لأنها تحدد أداء البرنامج وقابليته للتوسع مع نمو البيانات، فاختيار الهيكل الصحيح يحول عملية تستغرق دقائق إلى عملية تستغرق ثواني. وتمنح المبرمج طريقة تفكير منظمة في المشكلات تقوم على تحليل البيانات والعمليات قبل الكتابة، وتمكنه من فهم الأدوات التي يستخدمها يوميا من قواعد بيانات وأنظمة تشغيل ومكتبات. كما تعد معيارا أساسيا في مقابلات التوظيف التقنية، ومهارة لا تتقادم بتبدل اللغات والأطر.
الخاتمة
رأينا في هذا الدليل أن هياكل البيانات ليست موضوعا أكاديميا جافا بل هي عمود فقري تقوم عليه البرمجيات كلها. فمن المصفوفة التي تخزن القيم متجاورة، إلى القائمة المرتبطة التي تتنقل بين عقدها، إلى المكدس والطابور اللذين ينظمان الترتيب، إلى جدول التجزئة الذي يختصر البحث، إلى الأشجار والكومات والرسوم البيانية التي تمثل العلاقات المعقدة، يمثل كل هيكل إجابة ذكية عن سؤال محدد. وتعلمنا أن الاختيار بينها ليس مسألة حفظ بل مسألة موازنة بين السرعة والذاكرة والمرونة والبساطة، وأن هذه الموازنة تبدأ بفهم طبيعة البيانات ونمط استخدامها.
وتبين لنا كذلك أن التحليل النظري بترميز Big O أداة لا غنى عنها لكنها لا تكفي وحدها، فالقياس الفعلي والاختبار الدقيق للحالات الحدية يكملان الصورة. وأدركنا أن اللغات تقدم هياكل جاهزة ممتازة يجب الاعتماد عليها في الإنتاج، وأن بناءها يدويا يظل أفضل وسيلة للتعلم والفهم العميق. وعرفنا أن الأخطاء الشائعة كاختيار هيكل غير مناسب أو إهمال الذاكرة أو المؤشرات أو الحالات الحدية يمكن تفاديها بعادات منهجية بسيطة تبدأ من التخطيط وتنتهي بالاختبار.
وتبقى الخطوة الأهم هي البدء بالتطبيق العملي منذ اليوم. فاختر لغتك وابن أول قائمة مرتبطة بيديك، ثم تدرج في الهياكل بحسب الترتيب المقترح، وحل المسائل بانتظام، وابن مشروعا صغيرا يجمع ما تعلمت. وستكتشف بعد أسابيع قليلة أن نظرتك إلى البرامج قد تغيرت، فصرت ترى خلف كل تطبيق شبكة من الهياكل تعمل بصمت، وصرت تقرأ الشيفرة وتصمم الحلول بعين مهندس يعرف ثمن كل قرار. وهذه هي الفائدة الحقيقية من إتقان هذا المجال.