الذكاء الاصطناعي (AI): ثورة في تحسين كفاءة الأعمال وتطوير المستقبل

في عالم اليوم الذي يشهد منافسة متزايدة، لم يعد الابتكار خيارًا، بل أصبح شرطًا للبقاء. ويقف الذكاء الاصطناعي في قلب هذا التحول، بوصفه أداة ثورية تعيد تشكيل الأعمال وتفتح آفاقًا جديدة لتحسين الكفاءة. فتقنيات Artificial Intelligence تمكن الشركات من تحليل كميات هائلة من البيانات، وفهم الأنماط بسرعة ودقة، واتخاذ قرارات استراتيجية مبنية على معرفة حقيقية لا على الحدس.
لكن في سبتمبر 2026، حدث شيء غير مألوف. وقع الرئيس الأمريكي دونالد ترامب أمر تنفيذي يوجه الحكومة الفيدرالية إلى التخلي عن مصطلح “الذكاء الاصطناعي” واستبداله بـ“الذكاء الخارق” (Super Intelligence – SI). السبب المعلن: كلمة “اصطناعي” توحي بأن التقنية “مزيفة”، بينما “خارق” يعكس قدراتها الحقيقية.
لكن هناك مشكلة. “الذكاء الخارق” ليس اسمًا جديدًا. إنه مصطلح راسخ في العلم منذ كتاب نيك بوستروم عام 2014، ويعني ذكاءً يتجاوز البشر في كل المجالات، وهو شيء لم يتحقق بعد. فهل غير ترامب الاسم فقط، أم المعنى أيضًا؟ وهل سيتحول الذكاء الاصطناعي فعلًا إلى ذكاء خارق في 2027؟ هذا ما نستكشفه في هذا الدليل.
في هذا الدليل الشامل، نأخذك في رحلة متدرجة تبدأ من الأساسيات: ما هو الذكاء الاصطناعي؟ وكيف نشأ وتطور؟ ثم ننتقل إلى الأنواع والتقنيات التي تشكل جوهره، مثل تعلم الآلة والتعلم العميق والنماذج اللغوية. بعد ذلك نستعرض المجالات والتطبيقات الواقعية، والأدوات الحديثة التي يستخدمها المحترفون اليوم. ثم نناقش الأخلاقيات والتنظيم، ونختم بـالمستقبل الذي ينتظر هذا المجال.
جدول المحتويات
- ما هو الذكاء الاصطناعي (Artificial Intelligence)؟
- تاريخ الذكاء الإصطناعي
- كيف يعمل الذكاء الإصطناعي؟
- أنواع تعلم الآلة
- تكنولوجيا الذكاء الاصطناعي
- الأنواع الثلاثة الرئيسية من الذكاء الاصطناعي
- تصنيف أنظمة الذكاء الاصطناعي
- كيف تتم برمجة الآلة بالذكاء الاصطناعي؟
- ما هي أفضل لغة لتعلم الذكاء الاصطناعي؟
- تطبيق الذكاء الاصطناعي في مختلف الأعمال
- ما الفرق بين التعلم الآلي والتعلم العميق للذكاء الاصطناعي؟
- المخاطر التي يشكلها الذكاء الاصطناعي
- ما هي المميزات والتحديات للذكاء الاصطناعي؟
- ما هو مستقبل الذكاء الاصطناعي؟
- هل للذكاء الاصطناعي قدرة على تدمير البشرية؟
ما هو الذكاء الاصطناعي (Artificial Intelligence)؟
الذكاء الاصطناعي (Artificial Intelligence) هو فرع من علوم الحاسوب يهدف إلى تمكين الآلات من أداء مهام معقدة تتطلب قدرات شبيهة بقدرات البشر، مثل الفهم والتعلم والتخطيط واتخاذ القرارات. ويشمل هذا العلم تقنيات متطورة ومتنوعة، أبرزها الخوارزميات التكيفية ونماذج التعلم الآلي (Machine Learning) والتعلم العميق (Deep Learning)، التي تمكن الأنظمة من تحليل كميات من البيانات الضخمة واستخلاص رؤى هامة واتخاذ قرارات مستقلة تعتمد على البيانات المتاحة.
أنظمة الذكاء الاصطناعي تتميز بقدرتها على:
- إدراك البيئات المحيطة والتعرف على الكائنات والأشكال.
- اتخاذ قرارات مستقلة بناءً على تحليلات متقدمة.
- التعلم المستمر من الخبرات السابقة وتجاربها الميدانية.
- تقليد قدرات البشر من خلال معالجة المعطيات بمرونة واكتساب القدرة على التعميم.
لقد شهد الذكاء الاصطناعي منذ ظهوره في أربعينيات القرن العشرين تطورات كبيرة، حيث تم تطوير أجهزة كمبيوتر قادرة على أداء مهام معقدة مثل إيجاد البراهين الرياضية أو لعب الشطرنج بكفاءة عالية. ومع ذلك، لا تزال هناك تحديات في تصميم أنظمة تتجاوز نطاق المهام المحددة للوصول إلى مستوى الذكاء البشري المتكامل، والذي يتطلب قدرة مرنة على التعامل مع السياقات اليومية المعقدة والمعرفة المتنوعة.
وفي حين أن الذكاء العام الاصطناعي (AGI) لا يزال بعيد المنال، فقد حققت الأنظمة الذكية إنجازات في بعض التطبيقات العملية المتقدمة، مثل:
- التشخيص الطبي المتقدم: حيث تنافس دقة قراراتها دقة الأطباء الخبراء.
- أنظمة البحث الذكية التي تقدم نتائج عالية الدقة بناءً على تحليل البيانات.
- التعرف على الصوت والنصوص باستخدام التعلم العميق.
- روبوتات الدردشة، التي تتمتع بقدرة محسنة على الحوار التفاعلي بمرونة عالية.
هذه القدرات المتقدمة تجعل الذكاء الاصطناعي أداة قوية في تطبيقات صناعية وطبية وتجارية، ولكن يبقى تطوير مرونة كاملة مشابهة للبشر أحد أبرز التحديات المستقبلية في هذا المجال.رز التحديات المستقبلية في هذا المجال.
تاريخ الذكاء الإصطناعي

لم يبدأ الذكاء الاصطناعي في مختبرات القرن العشرين، بل يمكن تتبع جذوره الفكرية إلى اليونان القديمة، حيث حلم الفلاسفة بآلات قادرة على التفكير. لكن الحلم بقي نظريًا حتى أربعينيات القرن العشرين، حين ظهرت أجهزة الكمبيوتر الإلكترونية لأول مرة. عندها أصبح التفكير في آلات ذكية خيارًا قابلًا للتطبيق، لا مجرد خيال.
وفي عام 1956، شهد مؤتمر دارتموث ميلاد مصطلح “الذكاء الاصطناعي” رسميًا، على يد جون مكارثي ومارفن مينسكي وآلن نيويل وهربرت سايمون. ومنذ ذلك الحين، تطور تعريف الذكاء الاصطناعي مع تطور التقنية نفسها. فقبل بضعة عقود، كان مجرد برنامج قادر على التعرف الضوئي على الحروف (OCR) أو إجراء حسابات بسيطة يعد إنجازًا يُصنف كذكاء اصطناعي. أما اليوم، فقد أصبح المعيار أعلى بكثير، مع النماذج اللغوية الكبيرة والوكلاء البرمجيين القادرين على المحاورة والتحليل والبرمجة.
لتبسيط هذه الرحلة الملحمية، قمنا بتقسيم تاريخ الذكاء الاصطناعي إلى عصور متتابعة، توضح كيف انتقلنا من المنطق الرمزي البسيط إلى الشبكات العصبية العميقة، وصولاً إلى الذكاء التوليدي والوكلاء المستقلين (AI Agents):
| العصر / المرحلة | السنة | المحطة / الحدث الأهم | الأهمية والأثر (لماذا غيرت هذه المحطة العالم؟) |
|---|---|---|---|
| 🌱 عصر الجذور والتأسيس | 1936 | نموذج آلة تورينغ النظري (Turing Machine) | وضع آلان تورينغ الأسس النظرية لعلوم الحاسوب والقدرة على "الحساب"، ممهداً الطريق لآلات التفكير. |
| 🌱 عصر الجذور والتأسيس | 1950 | اختبار تورينج (Turing Test) | طرح السؤال الفلسفي والعلمي الأهم: "هل يمكن للآلات أن تفكر؟" ووضع معيار عملي لقياس ذكاء الآلة. |
| 🚀 عصر الميلاد والحماس | 1956 | ورشة دارتموث (Dartmouth Workshop) | ولادة المصطلح: جون مكارثي يصوغ مصطلح "الذكاء الاصطناعي" رسمياً، ويعلن أن "كل جانب من جوانب التعلم يمكن وصفه بدقة". |
| 🚀 عصر الميلاد والحماس | 1966 | برنامج إليزا (ELIZA) | أول "شات بوت" في التاريخ. محاكى معالجاً نفسياً، وأثبت أن الآلات يمكنها خداع البشر وجعلهم يعتقدون أنهم يتحدثون لإنسان. |
| ❄️ عصر "الشتاء" الأول والثاني | 1974-1980 | الشتاء الأول للذكاء الاصطناعي | تراجع التمويل بشكل دراماتيكي بعد فشل الآلات في تلبية التوقعات المبالغ فيها (تقرير لايتهيل). |
| ❄️ عصر "الشتاء" الأول والثاني | 1980s | الأنظمة الخبيرة (Expert Systems) | عودة الاهتمام عبر برامج مثل (MYCIN) للتشخيص الطبي، لكنها اصطدمت بصعوبة الصيانة والتحديث. |
| ❄️ عصر "الشتاء" الأول والثاني | 1987-1993 | الشتاء الثاني للذكاء الاصطناعي | انهيار سوق آلات "Lisp" المخصصة للذكاء الاصطناعي، وتجميد المشاريع الضخمة حول العالم. |
| 🏆 عصر التعلم الآلي والنقاط الفاصلة | 1997 | ديب بلو يهزم كاسباروف | صدمة العالم: حاسوب IBM يهزم بطل العالم في الشطرنج. أثبت أن "القوة الغاشمة" في الحساب يمكن أن تتغلب على الحدس البشري. |
| 🏆 عصر التعلم الآلي والنقاط الفاصلة | 2011 | آيبم واتسون (Watson) و سيري (Siri) | انتقال الذكاء الاصطناعي من المختبرات إلى الهواتف (Siri) وإثبات قدرته على فهم اللغة الطبيعية (Watson في Jeopardy). |
| 🧠 عصر الثورة العميقة (Deep Learning) | 2012 | شبكة AlexNet و ImageNet | بداية عصر التعلم العميق: أثبتت الشبكات العصبية العميقة تفوقها الساحق في التعرف على الصور، مما أعاد إشعال الثورة. |
| 🧠 عصر الثورة العميقة (Deep Learning) | 2014 | الشبكات التوليدية التنافسية (GANs) | إيان غودفيلو يقدم تقنية تسمح لآلتين بتوليد صور واقعية تماماً من الصفر (بداية عصر التزييف العميق والخلق الرقمي). |
| 🧠 عصر الثورة العميقة (Deep Learning) | 2016 | ألفا جو (AlphaGo) يهزم لي سيدول | نقطة التحول التاريخية: الآلة تهزم بطل العالم في لعبة "Go" (الأكثر تعقيداً من الشطرنج)، مستخدمة "الحدس الاصطناعي". |
| ⚡ عصر المحولات والانتشار الكوني | 2017 | ورقة "Attention is All You Need" | من أهم الأوراق في تاريخ الذكاء الاصطناعي: تقديم بنية "المحولات" (Transformers)، وهي البنية التحتية التي بنيت عليها كل نماذج الذكاء التوليدي لاحقاً. |
| ⚡ عصر المحولات والانتشار الكوني | 2020 | إطلاق GPT-3 | ولادة "النماذج اللغوية الكبيرة" (LLMs). الآلة تبدأ في كتابة نصوص لا تُميز عن نصوص البشر، وبداية عصر "البرمجة باللغة الطبيعية". |
| 🌌 عصر الذكاء التوليدي (Generative AI) | 2022 | إطلاق ChatGPT | الانفجار الكبير: وصول الذكاء الاصطناعي إلى مليار مستخدم في شهرين. تحول الـ AI من أداة للمطورين إلى "مساعد شخصي" لكل إنسان على وجه الأرض. |
| 🌌 عصر الذكاء التوليدي (Generative AI) | 2023 | GPT-4 والذكاء متعدد الوسائط | النماذج أصبحت "تسمع، ترى، وتقرأ" في آن واحد. بداية دمج الذكاء الاصطناعي في كل قطاع (الطب، القانون، البرمجة، الفن). |
| 🌌 عصر الذكاء التوليدي (Generative AI) | 2024 | نموذج Sora والوكلاء المستقلون | ثورة في توليد الفيديو الواقعي من النص. ظهور "وكلاء الذكاء الاصطناعي" (AI Agents) القادرين على تنفيذ مهام معقدة على الإنترنت بشكل مستقل. |
| 🔮 عصر التكامل والأنظمة المستقلة (الحاضر) | 2025 | الذكاء الكمي والـ AGI الأولي | دمج الحوسبة الكمية مع الذكاء الاصطناعي لتسريع اكتشاف الأدوية والمواد. ظهور نماذج تقترب من "الذكاء العام الاصطناعي" (AGI) في مهام محددة. |
| 🔮 عصر التكامل والأنظمة المستقلة (الحاضر) | 2026 | الأنظمة المستقلة وواجهات الدماغ-الحاسوب | (نحن الآن): الذكاء الاصطناعي يدير سلاسل التوريد العالمية، المدن الذكية، والمختبرات البحثية ذاتياً. نجاح التجارب الأولى لدمج الرقائق العصبية مع نماذج الذكاء الاصطناعي. |
| 🌠 عتبة المستقبل (ما بعد 2026) | 2027 | أفق الذكاء العام الاصطناعي (AGI) والواقع التخليقي | (العتبة القادمة): يرى بعض الخبراء احتمال وصول أنظمة تمتلك مرونة إدراكية تعادل أو تتجاوز الإنسان في جميع المجالات، وبداية عصر "الواقع التخليقي" حيث يولد المحتوى والبيئات بالكامل بواسطة الآلة لحظياً. |
إذا تأملت الجدول، ستلاحظ نمطًا مرعبًا ومذهلًا في آن واحد: تسارع وتيرة الابتكار.
- استغرق الأمر 41 عامًا (من 1956 إلى 1997) للانتقال من ولادة المصطلح إلى أول انتصار حقيقي للآلة على الإنسان في الشطرنج.
- واستغرق الأمر 10 سنوات فقط (من 2012 إلى 2022) للانتقال من التعرف على الصور إلى محادثة آلة تبدو وكأنها تمتلك معرفة البشرية جمعاء.
- واليوم في في أخر سنة 2026، لم نعد نقيس التقدم بالعقود، بل بالأشهر.
نحن الآن لم نعد نسأل “هل ستغير الآلة العالم؟”، بل السؤال الذي يؤرق الفلاسفة والعلماء معًا على أعتاب عام 2027 هو: “عندما يصبح الذكاء الإصطناعي عامًا (AGI)، ما هو الدور المتبقي للإنسان؟” وهو سؤال لا يزال مفتوحًا.
كيف يعمل الذكاء الإصطناعي؟

يعمل الذكاء الاصطناعي من خلال دمج كميات هائلة من البيانات مع خوارزميات متطورة لمعالجة تلك البيانات وتعلم الأنماط منها. ويعتمد النظام على التكرار المستمر والتقييم الذاتي لتحسين الأداء وتطوير المعرفة بمرور الوقت. ويتميز بقدرته على التعامل مع عدد كبير من المهام بسرعة ودقة، مما يجعله مفيدا في مجموعة واسعة من المجالات. ويمكن تلخيص خطوات إعداد وتعلم أنظمة الذكاء الاصطناعي في سبع خطوات، وسنشرح كل خطوة بفقرتين.
الخطوة الأولى: جمع البيانات
إحدى أهم المراحل في تطوير أي نظام ذكي هي مرحلة جمع البيانات. فبدون بيانات كافية ومتنوعة، لا يمكن للنموذج أن يتعلم أو يحسن أداءه. ويمكن استخدام مصادر مختلفة لتجميع البيانات التي يتطلبها النظام، مثل قواعد البيانات الداخلية، أو المستشعرات، أو السجلات، أو المصادر المفتوحة. وتعد جودة البيانات في هذه المرحلة عاملا حاسما، لأن أي خطأ في المصدر سينتقل إلى النموذج لاحقا.
وتتوفر البيانات بتنسيقات مختلفة مثل النص أو الرقم أو الصورة أو الفيديو أو الصوت، ويمكن أن تكون منظمة أو غير منظمة. وتختلف طبيعة البيانات المطلوبة حسب طبيعة المشكلة، فمشكلة التعرف على الصور تحتاج إلى بيانات بصرية، ومشكلة تحليل النصوص تحتاج إلى بيانات نصية. ولذلك يجب أن يحدد الفريق في هذه المرحلة نوع البيانات ومصادرها وحجمها بدقة.
- مصادر البيانات: قواعد البيانات، المستشعرات، السجلات، المصادر المفتوحة.
- تنسيقات البيانات: نص، رقم، صورة، فيديو، صوت.
- أنواع البيانات: منظمة، غير منظمة.
- معايير الجودة: الدقة، التنوع، الحجم، الحداثة.
الخطوة الثانية: المعالجة المسبقة للبيانات
بعد جمع بيانات المشكلة من مصادر مختلفة، لا يمكن استخدامها بشكل مباشر لتدريب النموذج. فيجب أولا معالجتها مسبقا لتحويلها إلى صيغة تستخدمها الخوارزميات. وهذه المرحلة ضرورية لأن البيانات الخام غالبا ما تحتوي على أخطاء أو فراغات أو تكرار، وإذا دخلت هذه العيوب إلى النموذج، فإنها ستؤثر سلبا في دقته.
ويشمل ذلك حذف البيانات غير الصحيحة، واستكمال البيانات غير المكتملة، وتطبيع البيانات، وإزالة البيانات المكررة. وكل خطوة من هذه الخطوات تؤثر في جودة النموذج النهائي. ويقضي خبراء البيانات وقتا طويلا في هذه المرحلة، لأن جودة المخرجات تعتمد على جودة المدخلات.
- حذف البيانات غير الصحيحة.
- استكمال البيانات غير المكتملة.
- تطبيع البيانات.
- إزالة البيانات المكررة.
- تحويل البيانات إلى صيغة مناسبة للخوارزمية.
الخطوة الثالثة: اختيار النموذج
يعد اختيار النموذج والخوارزمية المناسبين للمشكلة خطوة مهمة في حلها. فلكل من خوارزميات التعلم الآلي وخوارزميات التعلم العميق ميزات فريدة وكفاءة مختلفة، ويعتمد الاختيار على طبيعة المشكلة وحجم البيانات والموارد المتاحة. فالخوارزميات البسيطة قد تكفي لمشكلات صغيرة، بينما تحتاج المشكلات المعقدة إلى نماذج أكثر تعقيدا.
وبالإضافة إلى ذلك، هناك ثلاث طرق رئيسية لتدريب النماذج، وسنشرحها بالتفصيل في القسم التالي. والاختيار الصحيح في هذه المرحلة يوفر الوقت والجهد ويجنب الفريق إعادة العمل من البداية. ولا يوجد نموذج واحد يناسب كل المشكلات، بل لكل مشكلة نموذجها الأنسب.
- خوارزميات التعلم الآلي.
- خوارزميات التعلم العميق.
- ثلاث طرق للتدريب: التعلم الخاضع للإشراف، غير الخاضع، المعزز.
- معايير الاختيار: طبيعة المشكلة، حجم البيانات، الموارد.
الخطوة الرابعة: تدريب النموذج
بعد إعداد البيانات المطلوبة واختيار الخوارزمية الأنسب، حان الوقت لإعطاء البيانات للنموذج للتدريب. وقبل التدريب، يجب تقسيم البيانات إلى ثلاثة أجزاء لضمان تقييم عادل لأداء النموذج. فهذا التقسيم يمنع النموذج من “حفظ” بيانات التدريب بدل تعلم الأنماط الحقيقية.
ويتم تصميم خوارزميات الذكاء الاصطناعي بناء على سلسلة من العمليات الرياضية، ويطبق كل منها عمليات حسابية محددة على بيانات الإدخال. وتتمتع هذه الخوارزميات بحمل حسابي أثقل مقارنة بأساليب التعلم الآلي التقليدية، وتستغرق وقتا أطول لتدريب النموذج. وقد يحتاج التدريب إلى ساعات أو أيام أو أسابيع حسب حجم النموذج والبيانات.
- بيانات التدريب: تستخدم لتدريب النموذج، ويجب أن تكون ذات تنوع جيد.
- بيانات التقييم: تستخدم لقياس أداء النموذج أثناء التدريب.
- بيانات الاختبار: تستخدم لاختبار النموذج النهائي بعد التدريب.
- العمليات الرياضية: تحويل البيانات إلى معادلات قابلة للحساب.
الخطوة الخامسة: تقييم النموذج
بعد تدريب النموذج، يجب تقييم أدائه، لأن النموذج قد يتعلم بيانات التدريب جيدا، لكنه لا يعمل بشكل جيد على بيانات جديدة. وهنا تظهر أهمية مجموعة بيانات التقييم، التي تسمح بقياس درجة تعلم النموذج أثناء التدريب. فالتقييم هو الفرق بين نموذج “حفظ” ونموذج “تعلم”.
ويمكن استخدام معايير تقييم مختلفة لقياس أداء النموذج، ومن خلال فحص الأداء، قد تحدث ثلاث حالات: نقص التجهيز، أو التجهيز الزائد، أو الملاءمة المناسبة. ولكل حالة حل مختلف، ويعتمد اختيار الحل على طبيعة المشكلة وموارد الفريق.
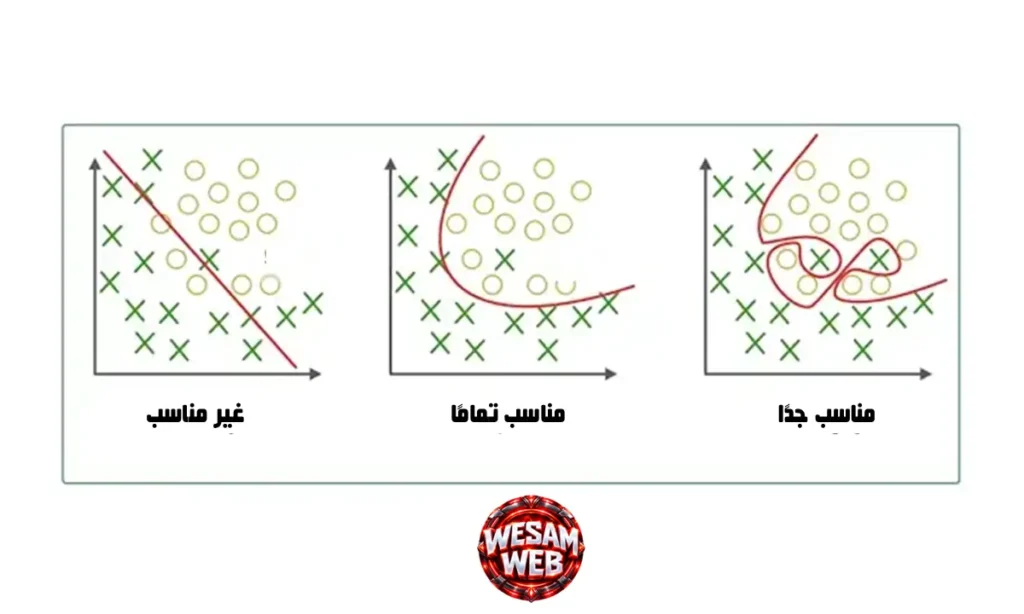
- معايير التقييم: الدقة (Accuracy)، الدقة (Precision)، الاسترداد (Recall)، تصنيف F1.
- نقص التجهيز: النموذج لا يتعلم جيدا. الحل: المزيد من البيانات أو نموذج أكثر تعقيدا.
- التجهيز الزائد: النموذج يتعلم التدريب لكنه يفشل على الاختبار. الحل: تقنيات مثل البيانات الصاخبة.
- الملاءمة المناسبة: الحالة المثالية، حيث يتعلم النموذج ويعمل بشكل جيد.
الخطوة السادسة: نشر النموذج
بعد تحقيق أفضل أداء للنموذج، يجب توفير منصة ليستخدمها المستخدمون. على سبيل المثال، يمكن تصميم برنامج يعمل كـ واجهة مستخدم تتيح للمستخدم استخدام النموذج. وهذه المرحلة هي التي تحول النموذج من مجرد كود في مختبر إلى منتج حقيقي يخدم الناس.
ولنفترض أنك دربت نموذجا للتنبؤ بسعر المنزل بناء على خصائص مثل حجمه وعدد غرفه وموقعه. لهذا النموذج، يمكنك تصميم برنامج بسيط يستقبل هذه الخصائص من المستخدم ويرسلها إلى النموذج المدرب ليتنبأ بسعر المنزل. وتتضمن هذه المرحلة أيضا مراقبة الأداء وضمان الاستقرار والتعامل مع الأخطاء.
- توفير منصة للمستخدمين.
- تصميم واجهة مستخدم.
- ربط الواجهة بالنموذج المدرب.
- اختبار النموذج في بيئة الإنتاج.
- مراقبة الأداء وضمان الاستقرار.
الخطوة السابعة: تحديث النموذج
هناك نقطة مهمة يجب ملاحظتها: نماذج الذكاء الاصطناعي تتعلم الأشياء بناء على البيانات التي نقدمها، ولذلك فإن معرفتها المكتسبة مرتبطة بتلك البيانات ولا يتم تحديثها تلقائيا. ونظرا لأن بيانات جديدة ومتنوعة تُنشأ يوميا، فإننا بحاجة إلى إبقاء النموذج محدثا حتى لا ينخفض أداؤه مع البيانات الجديدة.
ولتحقيق ذلك، يمكن استخدام طريقتين: الأولى التحديث اليدوي، حيث يتم إعداد بيانات جديدة للنموذج وتحديثه بها. والثانية التعلم المعزز، حيث إذا انخفضت كفاءة النموذج للبيانات الجديدة، فسوف يتعلم النموذج تلقائيا من أخطائه ويحسن تعلمه للبيانات الجديدة. وهذا ما يضمن بقاء النموذج فعالا مع مرور الوقت.
- إعادة التدريب: تدريب النموذج دوريا على بيانات محدثة..
- التحديث اليدوي: إعداد بيانات جديدة وتحديث النموذج بها.
- التعلم المعزز: النموذج يتعلم تلقائيا من أخطائه.
- مراقبة الأداء: متابعة كفاءة النموذج مع البيانات الجديدة.
أنواع تعلم الآلة
تنقسم طرق تدريب نماذج الذكاء الاصطناعي إلى ثلاثة أنواع رئيسية، ويختلف كل نوع في طبيعة البيانات التي يحتاجها وطريقة التعلم. وسنشرح كل نوع.
التعلم الخاضع للإشراف
تتطلب الخوارزميات التي تتبع هذا النهج بيانات مصنفة. وتحدد العلامة القيمة المستهدفة. على سبيل المثال، تعد مشكلة اكتشاف رسائل البريد الإلكتروني العشوائية وغير العشوائية من مشكلات التعلم الخاضع للإشراف، وتتضمن البيانات التعليمية لهذه المشكلة محتوى البريد ومرسله وكلماته الرئيسية وطوله، والقيمة المستهدفة لنوع البريد.
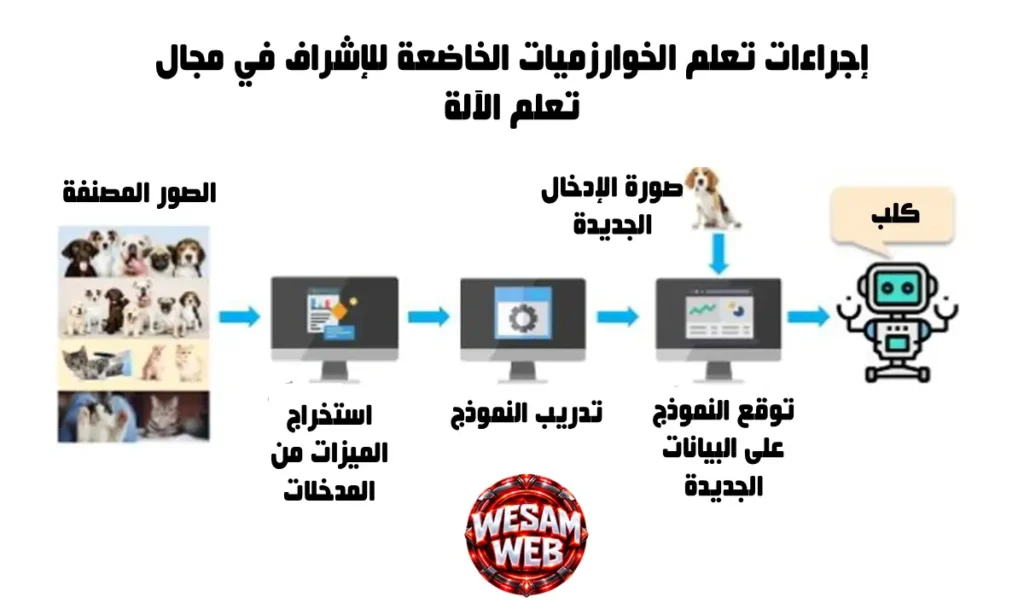
وتستخدم الخوارزميات ذات النهج المراقب القيمة المستهدفة لمعرفة المشكلة والعثور على دالة تربط البيانات بالقيمة المستهدفة. وفي حل مشكلات مثل التصنيف والانحدار، تستخدم خوارزميات التعلم الخاضع للإشراف. في مشكلات التصنيف، نسعى إلى وضع البيانات في فئات منفصلة، مثل اكتشاف البريد العشوائي أو التعرف على صور الحيوانات أو تحديد المؤلف. أما في مشكلات الانحدار، فنسعى إلى التنبؤ بقيم محددة بناء على بيانات الإدخال، مثل التنبؤ بأسعار المساكن من خلال بيانات عدد الغرف وحجم المنزل وموقعه الجغرافي.
التعلم غير الخاضع للإشراف
على عكس النماذج الخاضعة للإشراف، تتعامل خوارزميات التعلم غير الخاضع للإشراف مع بيانات تدريب غير مصنفة. والمشكلات التي يمكن حلها بهذا النهج تسمى مشكلات التجميع. وفي هذه المشكلات، لا تكون القيمة المستهدفة في بيانات التدريب معروفة، وتقوم الخوارزميات بتحديد الأنماط الكامنة في البيانات ووضع البيانات المتشابهة في نفس المجموعات.
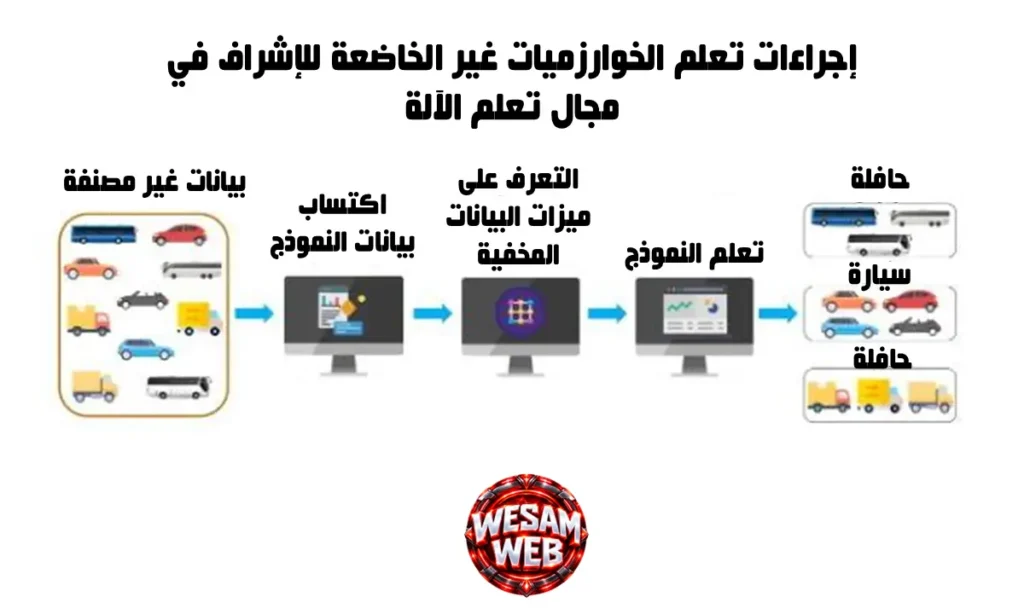
ويمكن أن تكون مدخلات خوارزميات التجميع بيانات مختلفة مثل النص أو الصوت أو الصورة، وتكون مخرجاتها عدة مجموعات مختلفة، وفي كل مجموعة توضع بيانات متشابهة. وتستخدم هذه الأنواع من الخوارزميات لحل مشكلات مثل اكتشاف الاحتيال أو اكتشاف الهجمات السيبرانية. وهذا النوع مفيد عندما لا نعرف مسبقا ما الذي نبحث عنه في البيانات.
التعلم المعزز
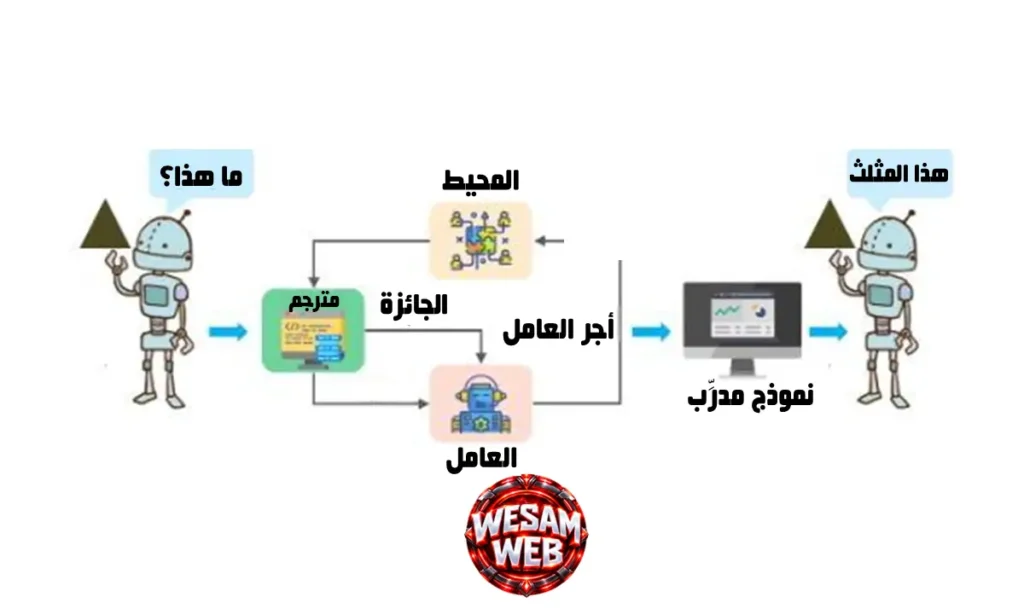
يختلف نهج التعلم المعزز عن النهجين السابقين. ففي التعلم المعزز، لدينا وكيل ذكي يفترض أن يتعلم المهام بالعمل ورد الفعل مثل الإنسان. وبمعنى آخر، في هذا النهج، لا يتم إعداد بيانات تدريبية للنظام، بل يتعلم الوكيل الذكي تدريجيا تحسين أدائه من خلال القيام بمهام مختلفة والحصول على ردود الفعل والنتائج من محيطه.
وهذا الأسلوب هو الأقرب إلى طريقة تعلم الإنسان من التجربة والخطأ. ويستخدم في تطبيقات مثل الألعاب والروبوتات والسيارات الذاتية القيادة. ويحتاج الوكيل إلى مكافأة أو عقاب لتوجيه سلوكه نحو الهدف المطلوب.
تكنولوجيا الذكاء الاصطناعي

في أوائل القرن الحادي والعشرين، أدت قوة المعالجة الأسرع ومجموعات البيانات الأكبر (البيانات الضخمة big data) إلى دفع الذكاء الاصطناعي خارج أقسام علوم الكمبيوتر إلى العالم الحقيقي. وقانون مور، الذي ينص على أن قوة الحوسبة تتضاعف كل 18 شهرا، بقي دون تغيير. وتتلاءم ردود المخزون الخاصة ببرنامج chatbot Eliza المبكر بسهولة مع أقل من 50 كيلو بايت. أما نموذج اللغة الذي يدعم ChatGPT فقد تم تدريبه على 45 تيرابايت من النص. وفيما يلي بعض من تقنيات الذكاء الاصطناعي الأكثر شيوعا والأسرع تطورا.
التعلم الآلي
التعلم الآلي هو فرع من فروع الذكاء الاصطناعي يركز على تطوير خوارزميات وتقنيات تمكن الآلات من التعلم من البيانات. ومن خلال تحليل كميات كبيرة من البيانات واستخلاص الأنماط منها، يمكن للآلات تحسين أدائها في المهام المختلفة بشكل ذاتي. ويعتبر التعلم الآلي أساس العديد من التطبيقات الحديثة مثل التنبؤ بالطقس، والتعرف على الصور، وحتى تحسين تجربة المستخدم في التطبيقات الإلكترونية.
ويشكل التعلم الآلي اليوم أكبر قطاع في سوق الذكاء الاصطناعي، إذ يستحوذ على 40% من إجمالي السوق في عام 2025، ومن المتوقع أن ينمو بمعدل سنوي مركب يبلغ 32.6% خلال الفترة القادمة. وتشير تقديرات أخرى إلى أن سوق التعلم الآلي العالمي بلغ 73.1 مليار دولار في عام 2025، مع توقعات بوصوله إلى 369.4 مليار دولار بحلول عام 2031. هذا النمو المتسارع يعكس اعتماد القطاعات المختلفة على هذه التقنية في تحسين عملياتها واتخاذ قراراتها.
مثال: محركات التوصية في منصات مثل يوتيوب ونتفليكس، تتعلم من سلوك المشاهد السابق لتقترح محتوى مشابها. وكذلك أنظمة كشف الاحتيال في البنوك، التي تتعلم من ملايين المعاملات لتمييز العملية المشبوهة من الطبيعية.
مقالة ذات صلة: التعلم الآلي: فهم أساسيات تعلم الآلة (Machine Learning) وتطبيقاته المتقدمة.
تدريب الآلة
تدريب الآلة هو عملية تزويد الآلة بالبيانات وتعليمها كيفية استخلاص النتائج من هذه البيانات. ويتم ذلك من خلال استخدام مجموعات بيانات تدريبية كبيرة تحتوي على أمثلة واضحة ومتنوعة. ويمكن تدريب الآلة على أداء مهام محددة مثل التعرف على الوجوه أو الترجمة الآلية للنصوص. وكلما زادت كمية ونوعية البيانات التي يتم تدريب الآلة عليها، زادت دقتها وكفاءتها في أداء المهام الموكلة إليها.
وقد شهدت السنوات الأخيرة تطورا كبيرا في حجم البيانات المستخدمة للتدريب، فبينما كان برنامج Eliza المبكر يعمل بأقل من 50 كيلو بايت من البيانات، تم تدريب النموذج الذي يدعم ChatGPT على 45 تيرابايت من النصوص، أي ما يعادل ملايين الكتب والمقالات. ويظهر هذا الفارق الهائل كيف تطورت قدرات النماذج نتيجة لتوفر بيانات ضخمة لم تكن متاحة في العقود السابقة.
مثال: تدريب نموذج للتعرف على الصور عبر عرض ملايين الصور المصنفة مسبقا، حتى يتعلم التمييز بين القطط والكلاب مثلا. وكذلك تدريب نموذج ترجمة على ملايين الجمل المترجمة بين لغتين، حتى يتقن نقل المعنى لا الكلمات فقط.
معالجة اللغة الطبيعية (NLP)
معالجة اللغة الطبيعية هي فرع آخر من الذكاء الاصطناعي يهدف إلى تمكين الآلات من فهم اللغة البشرية وتوليدها. وتشمل تطبيقاتها تحليل النصوص والترجمة الآلية والتعرف على الكلام وتوليد النصوص تلقائيا. وتلعب تقنيات معالجة اللغة الطبيعية دورا حيويا في تحسين واجهات الإنسان والآلة، وتسهيل الاتصال بالأنظمة الذكية مثل المساعدين الشخصيين الأذكياء (مثل Siri وGoogle Assistant).
ويقدر حجم سوق معالجة اللغة الطبيعية عالميا بنحو 91.6 مليار دولار في عام 2025، مع توقعات بوصوله إلى 751.4 مليار دولار بحلول عام 2034، بمعدل نمو سنوي مركب يبلغ 26.3%. ويأتي قطاع تكنولوجيا المعلومات والاتصالات في مقدمة القطاعات المستخدمة لهذه التقنية، يليه قطاع الرعاية الصحية والخدمات المالية. كما أن الشركات الصغيرة والمتوسطة أصبحت أكثر اعتمادا على حلول معالجة اللغة الطبيعية لتحسين خدمة العملاء وأتمتة المهام، بفضل انخفاض تكلفتها النسبية مقارنة بالماضي.
مثال: أنظمة خدمة العملاء الآلية التي تفهم استفسارات المستخدمين وتجيب عنها بلغة طبيعية. وكذلك أدوات التلخيص التي تختصر مقالات طويلة في بضع جمل دون فقدان المعنى الأساسي.
مقالة ذات صلة: معالجة اللغة الطبيعية (NLP): هل ينتج الذكاء الاصطناعي نصً مقنع دون فهم حقيقي لمعناه؟
علم الروبوتات
الروبوتات هي مجال يجمع بين الهندسة والذكاء الاصطناعي لتصميم وبناء روبوتات قادرة على أداء مهام معقدة ومتنوعة. ويمكن للروبوتات المزودة بتقنيات الذكاء الاصطناعي أداء مهام تتراوح من العمليات الجراحية الدقيقة إلى استكشاف الفضاء. وتستخدم الروبوتات أيضا في التصنيع والزراعة والرعاية الصحية والعديد من المجالات الأخرى. ويعتمد نجاح الروبوتات إلى حد كبير على تطوير خوارزميات الذكاء الاصطناعي وقدرتها على التكيف مع البيئات المتغيرة والمهام المختلفة.
وتظهر أرقام الاتحاد الدولي للروبوتات أن العالم شهد تركيب أكثر من 60 ألف روبوت صناعي جديد في عام 2025، بزيادة قدرها 11% عن العام السابق، ليصل إجمالي الروبوتات العاملة في المصانع حول العالم إلى 5 ملايين وحدة. وتتصدر الصين قائمة الدول الأكثر تركيبا للروبوتات الصناعية، إذ استحوذت على 59% من الإجمالي العالمي في عام 2025، بما يعادل 354 ألف روبوت. ومن المتوقع أن يستمر هذا النمو بمعدل يتراوح بين 5% و10% سنويا حتى عام 2029.
مثال: الروبوتات الصناعية في مصانع السيارات التي تركب القطع بدقة عالية، وروبوتات المستودعات التي تنقل البضائع عبر مسارات محسوبة. وكذلك الروبوتات الجراحية التي تساعد الأطباء في إجراء عمليات دقيقة لا تستطيع اليد البشرية تحقيقها بنفس المستوى.وعملنا.
مقالة ذات صلة: روبوتات الذكاء الاصطناعي AI Robots: استكشاف أحدث تقنيات الذكاء الاصطناعي
الأنواع الثلاثة الرئيسية من الذكاء الاصطناعي
يتم تصنيف أنظمة الذكاء الاصطناعي إلى ثلاث فئات بناءً على مدى فهمها واستجابتها لبيئتها. يمكن تصنيفها على أنها ضيقة أو عامة أو فائقة الذكاء. سنناقش كلًا من أنواع الذكاء الاصطناعي بالتفصيل أدناه:
الذكاء الاصطناعي الضيق (ANI)

الذكاء الاصطناعي الضيق (ANI) هو النوع الوحيد الموجود فعليا اليوم. ويشير إلى برامج متقدمة تتفوق على البشر في مهمة محددة، لكنها تعجز عن أداء أي مهمة أخرى خارج نطاقها. فبرنامج الشطرنج الذي يهزم بطل العالم لا يستطيع قيادة سيارة، ونظام التعرف على الوجه لا يستطيع ترجمة نص. ولهذا يسمى “ضيقا”، لأنه محصور في نطاق واحد لا يتجاوزه.
ويشكل الذكاء الضيق الغالبية الساحقة من سوق الذكاء الاصطناعي اليوم. وتشير التقديرات إلى أن جميع التطبيقات التجارية تقريبا، من محركات البحث إلى أنظمة التوصية إلى المساعدات الصوتية، تنتمي إلى هذه الفئة. وحتى النماذج اللغوية الكبيرة مثل ChatGPT وGemini، رغم قدراتها المذهلة، تبقى في جوهرها ذكاء ضيقا، لأنها مصممة لمهمة واحدة: التنبؤ بالكلمة التالية في سياق معين.
ومن أبرز أمثلة الذكاء الضيق اليوم: السيارات ذاتية القيادة التي تتعلم القيادة من ملايين الكيلومترات، وأنظمة التعرف على الوجه التي تكتشف الهوية في حشد كبير، والأنظمة المالية التي تكتشف الاحتيال في أجزاء من الثانية، والمساعدات الذكية التي تحجز رحلات الطيران وتجيب عن الأسئلة. وكل هذه الأنظمة متخصصة في مهمة واحدة، ولا تستطيع نقل مهاراتها إلى مهمة أخرى.
الذكاء العام الاصطناعي (artificial general intelligent)

الذكاء العام الاصطناعي (AGI) يشير إلى قدرة الآلة على فهم العالم من حولها بنفس الطريقة التي يفهمها بها البشر، والقدرة على أداء أي مهمة ذهنية يستطيع الإنسان أداءها. وهذا يعني أن النظام لا يكون متخصصا في مجال واحد، بل يستطيع الانتقال بمرونة بين المجالات، وتعلم مهارات جديدة دون إعادة البرمجة. وهذا هو الفرق الجوهري بينه وبين الذكاء الضيق.
وفي عام 2026، لا يزال الذكاء العام الاصطناعي بعيد المنال، لكن هناك مؤشرات أولية على اقترابنا منه. فبعض النماذج الحديثة بدأت تظهر قدرات متعددة في مجالات مختلفة، من البرمجة إلى الترجمة إلى التحليل. ومع ذلك، يرى كثير من الخبراء أن هذه النماذج لا تزال بعيدة عن الذكاء العام الحقيقي، لأنها تفتقر إلى الفهم العميق والإدراك الواعي والقدرة على التعلم المستمر من التجربة.
وإذا تحقق الذكاء العام الاصطناعي، فإن تأثيره سيكون هائلا. فمن جهة، يمكنه حل مشكلات معقدة مثل تغير المناخ والأمراض المستعصية وأزمات الطاقة. ومن جهة أخرى، يثير مخاوف حقيقية حول مستقبل الوظائف والتحكم البشري والأخلاقيات. ولهذا يبقى السؤال الأهم: كيف نستعد لعالم يشاركنا فيه الذكاء الاصطناعي في كل شيء؟
مميزات الذكاء العام الاصطناعي:
- تهدف إلى حل المشاكل بشكل أسرع.
- أداء الأنشطة الذكية على المستوى البشري.
- القدرة على التعلم والتفكير والقيام بأنشطة جديدة مثل الإنسان.
- تصميم وتنفيذ الإبداع والعقل والمنطق مثل البشر.
الذكاء الاصطناعي الفائق (ASI)

الذكاء الاصطناعي الفائق (ASI) هو مفهوم يستخدم لوصف تكنولوجيا تتجاوز الذكاء البشري في كل المجالات، وليس فقط في مجال واحد. ويتخيله البعض كنظام يتفوق على أعظم العقول البشرية مجتمعة، ويستطيع حل مشكلات لا يستطيع البشر حلها أصلا. وهذا المستوى لم يتحقق بعد، وربما لن يتحقق قريبا، لكنه يبقى مفهوما نظريا يثير النقاش.
وما زال الجدل قائما بين الخبراء حول إمكانية تحقيقه والوقت المطلوب لذلك. فبعضهم يرى أنه قريب، وبعضهم يرى أنه مستحيل، وبعضهم يرى أنه سيتحقق لكن بعد قرون. والأهم من ذلك، أن ما سيحققه غير واضح: هل سيكون فرصة لتحسين حياة البشر، أم تهديدا لوجودهم؟ وهل سيبقى تحت سيطرتنا، أم سيتجاوزها؟
وهذا الغموض هو ما يجعل الذكاء الفائق موضوعا فلسفيا بقدر ما هو موضوعا تقنيا. فالسؤال ليس فقط “هل يمكننا بناؤه؟”، بل “هل يجب أن نبنيه؟” و”من سيتحكم فيه؟” و”ما مصير البشرية في عالم يتفوق فيه الذكاء الاصطناعي على العقل البشري؟“. وهذه الأسئلة لا تزال مفتوحة، ولا توجد إجابات نهائية عليها.
تصنيف أنظمة الذكاء الاصطناعي

يمكن تصنيف أنظمة الذكاء الاصطناعي، وفق التصنيف الشائع الذي قدمته أرندت هنتز (Arend Hintze)، إلى أربع فئات رئيسية بناء على قدرتها على معالجة المعلومات والاستفادة من الخبرات وفهم الحالات العقلية. يبدأ هذا التصنيف من الأنظمة البسيطة التي تستجيب للمعلومات الحالية، ثم ينتقل إلى أنظمة أكثر تقدما يمكنها الاستفادة من الذاكرة والتفاعل مع البشر.
ومع ذلك، من المهم التمييز بين الأنظمة الموجودة فعليا والتصورات النظرية للذكاء الاصطناعي المتقدم. فالآلات التفاعلية والأنظمة ذات الذاكرة المحدودة لها تطبيقات عملية اليوم، بينما نظرية العقل والوعي الذاتي ما زالت مفاهيم بحثية ولم تتحقق كأنظمة ذكاء اصطناعي حقيقية حتى الآن.
النوع الأول: الآلات التفاعلية (Reactive Machines)
تعد الآلات التفاعلية أبسط أنواع أنظمة الذكاء الاصطناعي، لأنها تتعامل مع المعلومات الموجودة أمامها في اللحظة الحالية دون الاحتفاظ بذاكرة مستمرة عن التجارب السابقة. ومن أشهر الأمثلة التاريخية Deep Blue، نظام الشطرنج الذي طورته شركة IBM وتمكن من هزيمة بطل العالم غاري كاسباروف في مباراة رسمية عام 1997. كان النظام يحلل وضع القطع على الرقعة ويقيم عددا كبيرا من النقلات المحتملة لاختيار الحركة المناسبة.
وبالتالي، لا يعني غياب الذاكرة أن هذه الأنظمة عاجزة عن إجراء عمليات معقدة. فقد كان Deep Blue قادرا على تحليل عدد هائل من الاحتمالات واختيار أفضل حركة وفقا للمعلومات المتاحة. لكن خبراته السابقة لم تكن تتحول إلى ذاكرة دائمة يستخدمها لتطوير قراراته المستقبلية. لذلك، يظل هذا النوع مناسبا للمهام المحددة التي يمكن وصف قواعدها ومدخلاتها بوضوح، ولا يمكن نقله بسهولة إلى مشكلات مختلفة تماما.
- تستجيب للمعلومات الحالية دون الاعتماد على تجارب سابقة.
- لا تمتلك ذاكرة مستمرة للتعلم من القرارات السابقة.
- يمكنها تحليل عدد كبير من الاحتمالات ضمن نطاق محدد.
- تناسب المهام المتخصصة التي لها قواعد واضحة.
- يعد Deep Blue من أشهر الأمثلة التاريخية على هذا النوع.
النوع الثاني: الذاكرة المحدودة (Limited Memory)
تختلف أنظمة الذاكرة المحدودة عن الآلات التفاعلية في قدرتها على استخدام المعلومات السابقة لفترة محدودة عند اتخاذ القرارات. ويظهر هذا المفهوم في بعض تطبيقات السيارات ذاتية القيادة، حيث يمكن للنظام الاستفادة من معلومات حديثة عن سرعة المركبات ومواقعها واتجاهاتها. وبذلك يستطيع اتخاذ قرارات مثل تغيير المسار أو المحافظة على مسافة آمنة من المركبات الأخرى.
ومع ذلك، لا تعني الذاكرة المحدودة أن النظام يحتفظ بكل تجاربه إلى الأبد. بل يعتمد على بيانات سابقة أو ملاحظات حديثة تساعده في فهم الوضع الحالي واتخاذ القرار المناسب. ولهذا السبب، يمثل هذا النوع أساسا مهما لعدد من تطبيقات الذكاء الاصطناعي الحديثة، خصوصا عندما تحتاج الأنظمة إلى استخدام السياق السابق دون امتلاك ذاكرة بشرية كاملة ومستمرة.
- يستخدم المعلومات السابقة للمساعدة في اتخاذ القرارات.
- تعتمد الذاكرة فيه على فترة أو نطاق محدد من المعلومات.
- يظهر في بعض تطبيقات القيادة الذاتية والأنظمة الذكية.
- يمكنه الاستفادة من سلوك العناصر المحيطة لاتخاذ قرار مناسب.
- لا يمتلك ذاكرة بشرية دائمة لجميع التجارب السابقة.
النوع الثالث: نظرية العقل (Theory of Mind)
تشير نظرية العقل إلى مستوى متقدم من الذكاء الاصطناعي يستطيع فيه النظام فهم أن الأشخاص الآخرين يمتلكون معتقدات ورغبات ونوايا ومشاعر قد تختلف عن حالته الخاصة. ومن الناحية النظرية، لن يكتفي النظام بتحليل الكلمات أو الأفعال، بل سيحاول فهم الحالة العقلية للشخص والسياق الذي أدى إلى تصرفه. وهذا المستوى يرتبط ارتباطا وثيقا بمجالات علم النفس والعلوم المعرفية والتفاعل بين الإنسان والآلة.
ولا توجد حتى الآن أنظمة ذكاء اصطناعي تمتلك نظرية عقل بالمعنى الكامل المقصود في هذا التصنيف. ومع ذلك، تتطور تقنيات الذكاء الإصطناعي التفاعلي بسرعة في مجالات مثل فهم اللغة وتحليل المشاعر واستنتاج النوايا. ورغم ذلك، يجب عدم مساواة هذه القدرات الجزئية بامتلاك فهم حقيقي وشامل للحالات العقلية البشرية، لأن الفجوة بين محاكاة هذه القدرات وامتلاكها فعليا ما زالت كبيرة.
- تهدف إلى فهم المعتقدات والرغبات والنوايا لدى الآخرين.
- تسعى إلى تحليل الحالة العقلية للشخص وسياق تصرفاته.
- ترتبط بمجالات العلوم المعرفية وعلم النفس.
- بعض التقنيات الحالية تحاكي أجزاء محدودة من هذه القدرات.
- لا يوجد حتى الآن نظام ذكاء اصطناعي يحقق نظرية العقل بالكامل.
النوع الرابع: الوعي الذاتي (Self-Awareness)
يمثل الوعي الذاتي المستوى النظري الأكثر تقدما في هذا التصنيف، إذ يفترض وجود نظام قادر على فهم حالته الداخلية وإدراك وجوده وامتلاك تصور عن ذاته. ووفقا لهذا المفهوم، لن يقتصر الذكاء الاصطناعي على تحليل البيئة المحيطة أو فهم سلوك الآخرين، بل سيكون قادرا على إدراك حالته وعملياته الداخلية بطريقة تشبه بعض جوانب الوعي البشري.
ولا يوجد حاليا دليل علمي على وجود نظام ذكاء اصطناعي يمتلك وعيا ذاتيا حقيقيا بالمعنى المقصود في هذا التصنيف. لذلك، فإن الأنظمة التي تتحدث عن نفسها أو تصف مشاعرها لا تعد تلقائيا أنظمة واعية ذاتيا. فقد تكون هذه الاستجابات ناتجة عن معالجة الأنماط واللغة والبيانات، وليس عن تجربة ذاتية أو وعي حقيقي. وبالتالي، يبقى الوعي الذاتي في الذكاء الاصطناعي موضوعا نظريا وبحثيا أكثر منه تقنية متاحة اليوم.
- لذلك، يعد الوعي الذاتي مفهوما نظريا مستقبليا في الذكاء الاصطناعي.
- يفترض امتلاك النظام إدراكا لذاته وحالته الداخلية.
- يتجاوز فهم البيئة إلى فهم النظام لنفسه.
- يرتبط بمفاهيم الوعي والإدراك والتجربة الذاتية.
- لا توجد حاليا أنظمة مثبتة علميا تمتلك هذا المستوى من الوعي.
كيف تتم برمجة الآلة بالذكاء الاصطناعي؟
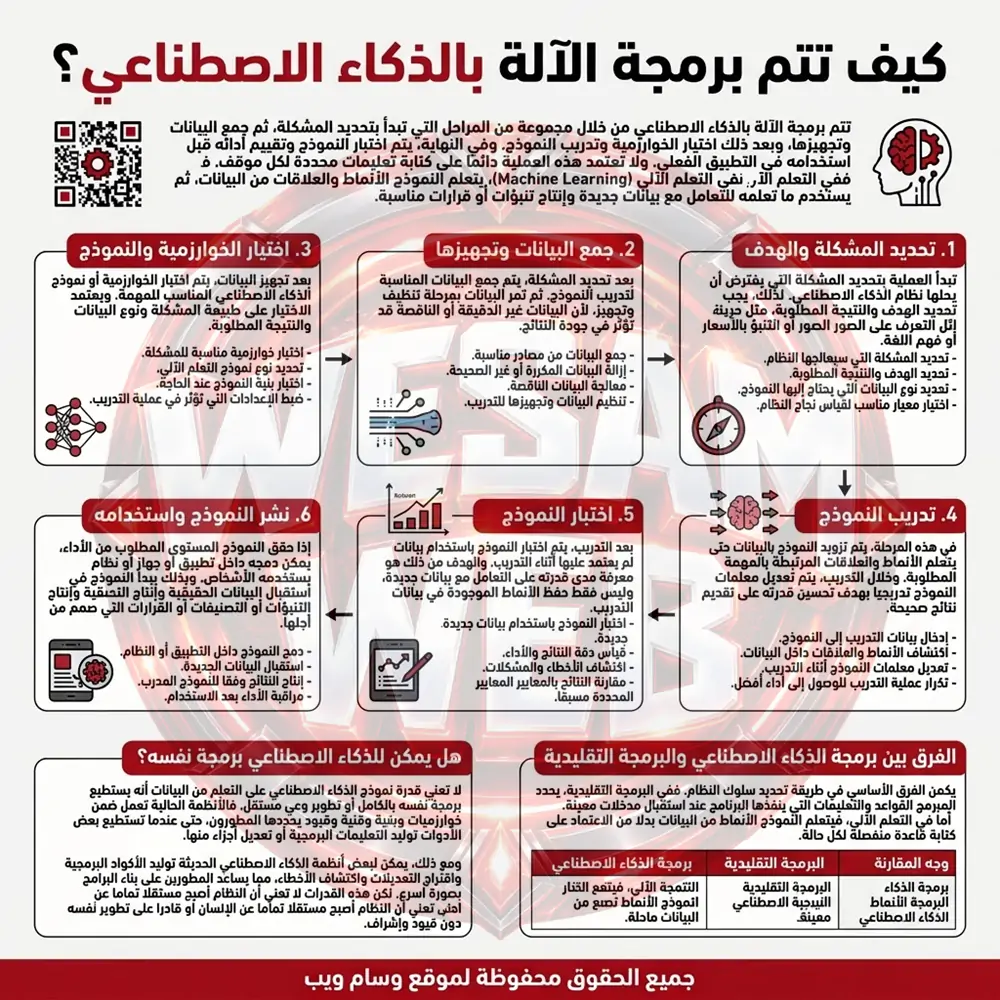
تختلف برمجة الآلة بالذكاء الاصطناعي عن البرمجة التقليدية في طريقة بناء النظام وتعليمه تنفيذ المهام. ففي البرمجة التقليدية، يكتب المبرمج تعليمات وقواعد محددة توضح للكمبيوتر ما يجب فعله عند حدوث كل حالة معروفة. أما في أنظمة الذكاء الاصطناعي، وخصوصا التعلم الآلي (Machine Learning)، فيتم تصميم خوارزميات ونماذج تستطيع التعلم من البيانات واكتشاف الأنماط والعلاقات الموجودة فيها.
وبناء على ذلك، لا يحتاج المطور دائما إلى كتابة تعليمات منفصلة لكل احتمال يمكن أن يواجهه النظام. وبدلا من ذلك، يتم تدريب النموذج باستخدام بيانات مناسبة، ثم يتعلم منها كيفية إنتاج مخرجات عند استقبال بيانات جديدة. ومع ذلك، لا يعني هذا أن الآلة تفكر بالطريقة نفسها التي يفكر بها الإنسان، بل إنها تستخدم خوارزميات ونماذج رياضية لمعالجة البيانات والوصول إلى نتائج وفقا لما تعلمته.
مراحل برمجة الآلة بالذكاء الاصطناعي
المرحلة الأولى: تحديد المشكلة والهدف
تبدأ عملية تطوير نظام الذكاء الاصطناعي بتحديد المشكلة التي يجب على النظام حلها والهدف الذي يراد الوصول إليه. وهذه الخطوة مهمة، لأن اختيار النموذج والخوارزمية والبيانات يعتمد على طبيعة المهمة المطلوبة. فقد يكون الهدف هو التعرف على الأشخاص في الصور، أو التنبؤ بأسعار المنتجات، أو اكتشاف الرسائل المزعجة، أو فهم اللغة الطبيعية.
وبالتالي، لا تبدأ عملية الذكاء الاصطناعي باختيار لغة البرمجة مباشرة، بل تبدأ بفهم المشكلة وتحديد شكل المخرجات المطلوبة. فإذا كان النظام سيحدد ما إذا كانت الصورة تحتوي على جسم معين، فهذه مهمة تصنيف. أما إذا كان سيقدر قيمة رقمية مستقبلية، فقد تكون المهمة تنبؤا رقميا. لذلك، يساعد تحديد الهدف بدقة على اختيار الطريقة المناسبة لبناء النظام.
- تحديد المشكلة التي سيعالجها النظام.
- تحديد الهدف والنتيجة المطلوبة.
- تحديد نوع المخرجات التي يجب أن ينتجها النظام.
- اختيار معيار واضح لقياس نجاح النموذج.
- تحديد القيود والموارد المتاحة للمشروع.
المرحلة الثانية: جمع البيانات
بعد تحديد المشكلة، تأتي مرحلة جمع البيانات التي يحتاج إليها النظام حتى يتعلم منها. وتختلف طبيعة هذه البيانات وفقا للمهمة، فقد تكون صورا أو نصوصا أو أصواتا أو أرقاما أو سجلات أو بيانات حسية من الأجهزة. وكلما كانت البيانات أكثر ارتباطا بالمشكلة، أصبح من الممكن بناء نموذج أكثر ملاءمة للمهمة.
ومع ذلك، لا تكفي كمية البيانات وحدها للحصول على نظام جيد. فالبيانات يجب أن تكون مناسبة ومتنوعة وتمثل الحالات التي سيواجهها النظام في الواقع. كما يجب الانتباه إلى الأخطاء والتحيزات الموجودة فيها، لأن النموذج قد يتعلم أنماطا غير صحيحة إذا كانت البيانات نفسها تحتوي على مشكلات.
- جمع البيانات من مصادر مناسبة.
- التأكد من ارتباط البيانات بالمشكلة.
- توفير بيانات متنوعة تمثل الحالات الواقعية.
- اكتشاف الأخطاء والتحيزات الموجودة في البيانات.
- التأكد من جودة البيانات قبل استخدامها.
المرحلة الثالثة: تنظيف البيانات وتجهيزها
لا يمكن استخدام البيانات الخام دائما بصورة مباشرة في تدريب النموذج. لذلك، تمر البيانات بمرحلة التنظيف والمعالجة المسبقة، حيث يتم التعامل مع القيم الناقصة والبيانات المكررة والأخطاء والتنسيقات المختلفة. وقد تتطلب بعض المشاريع أيضا تحويل البيانات إلى صيغة يمكن للنموذج التعامل معها بصورة أفضل.
وبعد ذلك، يمكن تقسيم البيانات إلى مجموعات مختلفة، مثل بيانات التدريب وبيانات التحقق وبيانات الاختبار. ويساعد هذا التقسيم على معرفة ما إذا كان النموذج قد تعلم الأنماط العامة فعلا، أم أنه أصبح يعتمد بصورة مفرطة على البيانات التي تدرب عليها. وتعد هذه الخطوة مهمة لتجنب مشكلة فرط التكيف (Overfitting).
- تنظيف البيانات من الأخطاء والتكرار.
- معالجة البيانات الناقصة عند الحاجة.
- توحيد تنسيقات البيانات.
- تجهيز البيانات بالشكل المناسب للنموذج.
- تقسيم البيانات إلى تدريب وتحقق واختبار عند الحاجة.
المرحلة الرابعة: اختيار الخوارزمية والنموذج
بعد تجهيز البيانات، يختار المطور الخوارزمية أو النموذج المناسب للمشكلة. ولا توجد خوارزمية واحدة تصلح لجميع تطبيقات الذكاء الاصطناعي، لأن طبيعة المهمة والبيانات تحدد الطريقة الأنسب. فقد تستخدم خوارزميات مختلفة للتصنيف أو التنبؤ أو اكتشاف الأنماط أو معالجة اللغة والصور.
وفي الأنظمة الحديثة، قد يكون النموذج بسيطا نسبيا أو يعتمد على شبكات عصبية عميقة تحتوي على عدد كبير من المعلمات. لذلك، يجب أن يوازن المطور بين دقة النموذج وسرعته وتكلفة تشغيله وحجم البيانات المتاحة. وفي بعض الحالات، يمكن استخدام نموذج جاهز وتخصيصه بدلا من بناء نموذج كامل من الصفر.
- اختيار الخوارزمية المناسبة للمشكلة.
- تحديد نوع النموذج المطلوب.
- اختيار بنية مناسبة للبيانات والمهمة.
- تحديد الموارد الحاسوبية المطلوبة.
- الموازنة بين الدقة والسرعة والتكلفة.
المرحلة الخامسة: تدريب النموذج
بعد اختيار النموذج، تبدأ مرحلة التدريب، حيث تتم معالجة بيانات التدريب حتى يتعلم النموذج الأنماط والعلاقات المرتبطة بالمهمة. وخلال هذه العملية، يقارن النموذج بين النتائج التي ينتجها والنتائج المطلوبة، ثم يتم تعديل معلماته لتقليل الخطأ وتحسين الأداء.
وتتكرر عملية التدريب عدة مرات، وقد يحتاج المطور إلى تعديل إعدادات النموذج أو طريقة تجهيز البيانات للوصول إلى نتائج أفضل. ومع ذلك، فإن التدريب لا يعني أن النموذج يحفظ جميع البيانات بالضرورة، بل الهدف هو أن يتعلم أنماطا قابلة للتعميم تساعده على التعامل مع بيانات جديدة لم يرها أثناء التدريب.
- إدخال بيانات التدريب إلى النموذج.
- مقارنة مخرجات النموذج بالنتائج المطلوبة.
- حساب مقدار الخطأ.
- تعديل معلمات النموذج أثناء التدريب.
- تكرار التدريب لتحسين الأداء.
المرحلة السادسة: اختبار النموذج وتقييمه
بعد انتهاء التدريب، لا يتم استخدام النموذج مباشرة في جميع الحالات، بل يجب اختباره وتقييمه. ويتم ذلك باستخدام بيانات لم يعتمد عليها النموذج أثناء التدريب، حتى يمكن معرفة قدرته على التعامل مع مدخلات جديدة. وبذلك، يستطيع المطور معرفة ما إذا كان النموذج قد تعلم الأنماط فعلا أم أنه اعتمد بصورة كبيرة على بيانات التدريب.
ومن ناحية أخرى، لا تكفي الدقة وحدها لتقييم جميع أنظمة الذكاء الاصطناعي. فقد تكون هناك مقاييس أخرى أكثر أهمية وفقا للمهمة، مثل معدل الخطأ أو الدقة والاستدعاء أو سرعة الاستجابة أو استهلاك الموارد. لذلك، يتم اختيار مقاييس التقييم وفقا لطبيعة النظام والنتيجة التي يجب أن يحققها.
- اختبار النموذج باستخدام بيانات جديدة.
- قياس جودة النتائج وفقا للمهمة.
- اكتشاف الأخطاء ونقاط الضعف.
- مقارنة النتائج بالمعايير المطلوبة.
- التأكد من قدرة النموذج على التعميم.
المرحلة السابعة: نشر النموذج داخل الآلة أو النظام
عندما يحقق النموذج الأداء المطلوب، يمكن نقله إلى البيئة التي سيعمل فيها فعليا. وقد تكون هذه البيئة حاسوبا أو هاتفا ذكيا أو سيارة أو روبوتا أو خادما سحابيا أو جهازا مدمجا. وفي هذه المرحلة، يتم دمج النموذج مع بقية مكونات النظام حتى يستطيع استقبال البيانات وإنتاج النتائج.
وبالتالي، فإن النموذج المدرب لا يعمل منفصلا عن النظام بالكامل. بل يتفاعل مع البرمجيات والأجهزة والمستشعرات وقواعد البيانات وغيرها من المكونات وفقا للتطبيق. وفي بعض الأجهزة، يجب أيضا تحسين النموذج حتى يعمل ضمن قيود الذاكرة والطاقة وقدرة المعالجة المتاحة.
- دمج النموذج داخل التطبيق أو الجهاز.
- ربط النموذج بمصادر البيانات المطلوبة.
- استقبال البيانات الجديدة وتحليلها.
- إنتاج التنبؤات أو التصنيفات أو النتائج.
- تحسين النموذج ليتناسب مع موارد الجهاز.
المرحلة الثامنة: المراقبة والتحديث
لا تنتهي برمجة نظام الذكاء الاصطناعي بمجرد نشره. فالأداء قد يتغير عندما تتغير البيانات أو الظروف التي يعمل فيها النظام. ولهذا السبب، يحتاج النظام إلى المراقبة المستمرة لاكتشاف الأخطاء أو انخفاض جودة النتائج أو تغير طبيعة البيانات.
وعند ظهور مشكلات جديدة، يمكن تحديث البيانات أو تعديل النموذج أو إعادة تدريبه وفقا للحاجة. وقد تحتاج بعض الأنظمة إلى إعادة التدريب بصورة دورية، بينما لا تحتاج أنظمة أخرى إلى ذلك إلا عند ظهور تغيرات واضحة. لذلك، تعد عملية الصيانة والتحديث جزءا أساسيا من دورة حياة نظام الذكاء الاصطناعي.
- مراقبة أداء النموذج بعد نشره.
- اكتشاف تراجع جودة النتائج.
- جمع بيانات جديدة عند الحاجة.
- إعادة تدريب النموذج عند الضرورة.
- تحديث النظام للحفاظ على مستوى الأداء.
الفرق بين برمجة الذكاء الاصطناعي والبرمجة التقليدية
يتمثل الفرق الأساسي بين البرمجة التقليدية وبرمجة الذكاء الاصطناعي في كيفية الوصول إلى النتيجة. ففي البرمجة التقليدية، يحدد المبرمج القواعد والخطوات التي ينفذها البرنامج، ثم يستخدم البرنامج هذه التعليمات لمعالجة المدخلات. فإذا كانت هناك حالات جديدة، يحتاج المبرمج غالبا إلى إضافة قواعد أو تعديل الكود حتى يستطيع البرنامج التعامل معها.
أما في التعلم الآلي، فيتم بناء نموذج يتعلم الأنماط من البيانات بدلا من كتابة قاعدة منفصلة لكل حالة. فعلى سبيل المثال، يمكن تدريب نموذج للتعرف على القطط باستخدام عدد كبير من الصور، ثم يستخدم النموذج الأنماط التي تعلمها لتحديد ما إذا كانت صورة جديدة تحتوي على قطة. ومع ذلك، لا يعني هذا أن النظام يعرف مفهوم القطة بالطريقة البشرية، بل إنه يعتمد على الأنماط الرياضية التي تعلمها أثناء التدريب.
| وجه المقارنة | البرمجة التقليدية | برمجة الذكاء الاصطناعي |
|---|---|---|
| طريقة تحديد السلوك | يحدد المبرمج القواعد والخطوات | يتعلم النموذج الأنماط من البيانات في التعلم الآلي |
| دور البيانات | تستخدم غالبا كمدخلات | تستخدم كمدخلات وقد تستخدم أيضا في تدريب النموذج |
| دور المبرمج | كتابة القواعد والتعليمات | تصميم النظام وتجهيز البيانات واختيار النموذج وتقييمه |
| التعامل مع الحالات الجديدة | يعتمد على القواعد التي كتبها المبرمج | يمكن للنموذج التعميم على بيانات جديدة |
| تحسين النظام | تعديل الكود والقواعد | قد يتطلب تحسين البيانات أو النموذج أو إعادة التدريب |
| أمثلة | الآلات الحاسبة وبرامج إدارة الملفات | التعرف على الصور والترجمة والتنبؤ |
هل يعني الذكاء الاصطناعي أن الآلة تفكر مثل الإنسان؟
قد تبدو بعض أنظمة الذكاء الاصطناعي وكأنها تفكر أو تستنتج مثل الإنسان، خصوصا عند التعامل مع اللغة والصور والصوت. ومع ذلك، فإن هذه الأنظمة لا تعتمد على عقل بشري داخل الكمبيوتر، بل تستخدم نماذج رياضية وخوارزميات لمعالجة كميات كبيرة من البيانات وإنتاج مخرجات بناء على الأنماط التي تعلمتها.
ولهذا السبب، فإن قدرة النظام على الإجابة عن الأسئلة أو التعرف على الصور أو إنتاج النصوص لا تعني بالضرورة أنه يمتلك وعيا أو فهما بشريا. فالذكاء الاصطناعي الحالي يستطيع تنفيذ مهام معقدة للغاية، لكنه يعمل ضمن بنية وخوارزميات وبيانات وأهداف محددة. لذلك، يجب التفريق بين محاكاة بعض القدرات الذكية وبين امتلاك عقل أو وعي شبيه بالإنسان. الإنسان أو قادرا على تطوير نفسه دون قيود وإشراف.
ما هي أفضل لغة لتعلم الذكاء الاصطناعي؟

لا توجد لغة واحدة تكفي وحدها لبناء كل تطبيقات الذكاء الاصطناعي، لكن هناك لغات تتفوق على غيرها في هذا المجال، وتستخدمها كبرى الشركات والمراكز البحثية. ويكمن الفرق بين لغة وأخرى في سرعتها، وسهولة تعلمها، وحجم المكتبات المتوفرة لها، وطبيعة المهام التي تناسبها. وفيما يلي أبرز لغات البرمجة، مع بيان دور كل منها في صناعة الذكاء الاصطناعي.
Python
Python هي اللغة الأولى في مجال الذكاء الاصطناعي بلا منافس تقريبا، إذ تعتمد عليها غالبية المشاريع والمكتبات المتخصصة. وتتميز بـسهولة تعلمها، وقرب صياغتها من اللغة الطبيعية، مما يسمح للمبتدئ بالتركيز على المفاهيم لا على التعقيدات اللغوية. كما تمتلك Python مكتبات عملاقة مثل TensorFlow وPyTorch وScikit-learn وKeras، وهي أدوات أساسية لبناء النماذج وتدريبها.
ويستخدمها الباحثون في الجامعات ومراكز البحث، والمهندسون في شركات التقنية الكبرى، لأنها تجمع بين البساطة والقوة. وتشير التقديرات إلى أن أكثر من 90% من أكواد الذكاء الاصطناعي التي تولدها النماذج الحديثة تكون بلغة Python، وهو ما يعكس هيمنتها على المجال. كما أنها تعمل كـنظام تنسيق يدير المكونات الأخرى المكتوبة بلغات أسرع مثل C++.
- المكتبات: TensorFlow, PyTorch, Scikit-learn, Keras.
- تناسب: التعلم العميق، تحليل البيانات، معالجة اللغة الطبيعية.
- تناسب المبتدئين لأن صياغتها قريبة من اللغة الطبيعية.
- تعمل كنظام تنسيق يدير المكونات الأخرى.
C++
تعد C++ اللغة المسؤولة عن السرعة والأداء العالي في أنظمة الذكاء الاصطناعي. فبينما يكتب الباحثون النموذج بلغة Python، غالبا ما تكون النواة الحسابية داخله مكتوبة بلغة C++ لتحقيق أقصى أداء. ولهذا تستخدم C++ في بناء محركات التعلم العميق، وفي التطبيقات التي تحتاج إلى معالجة فورية مثل السيارات ذاتية القيادة والروبوتات.
وتتميز C++ بقدرتها على إدارة الذاكرة بدقة، والتحكم في موارد الجهاز، وهو ما يجعلها الخيار الأول في الأنظمة المضمنة وتطبيقات الزمن الحقيقي. كما تعتمد عليها المكتبات الكبرى في تنفيذ عملياتها الثقيلة، مثل TensorFlow التي كتبت نواتها الأساسية بلغة C++. لكنها صعبة التعلم مقارنة بـPython، ولذلك يفضل المبتدئ تأجيلها حتى يتقن الأساسيات.
- تناسب: الأنظمة عالية الأداء، الروبوتات، السيارات ذاتية القيادة.
- تتميز بـ: إدارة الذاكرة، السرعة، التحكم في الموارد.
- صعبة التعلم للمبتدئين.
- تستخدمها المكتبات الكبرى في نواتها الحسابية.
JavaScript
JavaScript هي لغة الويب الأولى، وأصبحت اليوم خيارا مهما في تطوير تطبيقات الذكاء الاصطناعي التي تعمل في المتصفح. وتتيح مكتبات مثل TensorFlow.js تشغيل النماذج مباشرة في المتصفح دون الحاجة إلى خادم، مما يفتح الباب لتطبيقات تفاعلية تعمل على جهاز المستخدم مباشرة.
ويستخدمها المطورون لبناء واجهات تفاعلية تدمج النماذج الذكية، مثل تطبيقات التعرف على الصور في الوقت الحقيقي، أو أدوات تحليل النصوص في الويب. كما أنها تتيح تشغيل النماذج على الهواتف والأجهزة الطرفية عبر أطر مثل React Native. وهي الخيار الأول لمن يريد دمج الذكاء الاصطناعي في تطبيقات الويب أو الهواتف.
- تناسب: تطبيقات الويب، الواجهات التفاعلية، النماذج في المتصفح.
- مكتبات: TensorFlow.js, Brain.js, ML5.js.
- تعمل في المتصفح دون الحاجة إلى خادم.
- خيار أول لمن يريد دمج الذكاء الاصطناعي في الويب.
Java
Java لغة قوية ومعروفة في الأنظمة المؤسسية، وقد استخدمت في الذكاء الاصطناعي منذ عقود. وتوفر مكتبات متعددة مثل Deeplearning4j وWeka، مما يجعلها خيارا مناسبا للمشاريع الكبيرة التي تحتاج إلى استقرار وأداء موثوق. كما أن بيئتها الافتراضية JVM تتيح تشغيل النماذج على أي نظام دون تعديل.
وتستخدم Java بشكل واسع في أنظمة تحليل البيانات الضخمة مثل Apache Spark، التي تعتمد عليها الشركات في معالجة ملايين السجلات. لكنها أقل شيوعا في البحث الأكاديمي مقارنة بـPython، لأن صياغتها أطول وأكثر تعقيدا. ومع ذلك، تبقى خيارا معتمدا في المؤسسات التي تبني أنظمة ذكاء اصطناعي واسعة النطاق.
- تناسب: الأنظمة المؤسسية، معالجة البيانات الضخمة.
- مكتبات: Deeplearning4j, Weka.
- تعمل على JVM في أي نظام.
- أقل شيوعا في البحث الأكاديمي من Python.
Julia
Julia لغة حديثة صممت خصيصا للحوسبة العلمية والرياضية، وتجمع بين سهولة Python وسرعة C++. وتستخدم على نطاق واسع في الأبحاث التي تحتاج إلى حسابات معقدة، مثل محاكاة النماذج الفيزيائية وتحليل البيانات الضخمة. ويشهد استخدامها نموا ملحوظا في الأوساط الأكاديمية والبحثية.
وتتميز Julia بـسرعة تنفيذ عالية، ودعم مدمج للعمليات الرياضية المتقدمة، مما يجعلها مناسبة لمشاريع التعلم الآلي التي تحتاج إلى دقة حسابية عالية. لكنها لا تزال أقل انتشارا من Python، وقاعدة مستخدميها أصغر، مما يعني أن الدعم والمكتبات المتاحة أقل. ومع ذلك، فهي خيار قوي للباحثين الذين يريدون أداء عاليا دون التخلي عن سهولة الكتابة.
- تناسب: الحوسبة العلمية، الأبحاث الرياضية، التعلم الآلي.
- تتميز بـ: السرعة العالية، الدقة الحسابية.
- تجمع بين سهولة Python وسرعة C++.
- أقل انتشارا من Python، لكنها تنمو.
LISP
LISP هي أقدم لغة برمجة استخدمت في الذكاء الاصطناعي، إذ ظهرت في خمسينيات القرن الماضي، وكانت اللغة المفضلة في أبحاث الذكاء الاصطناعي الأولى. وقد استخدمت في بناء أنظمة الخبراء والبرامج التي تحاكي التفكير المنطقي، وهي اللغة التي ألهمت كثيرا من المفاهيم الحديثة في المجال.
ورغم تاريخها العريق، لم تعد LISP لغة شائعة في المشاريع الحديثة، لأن معظم الأدوات والمكتبات الحالية لا تدعمها. لكنها تبقى مهمة من الناحية التاريخية والفكرية، لأنها ساعدت في تشكيل أسس الذكاء الاصطناعي. ولذلك يذكرها الباحثون كجزء من التراث العلمي للمجال، وليس كخيار عملي اليوم.
- لغة تاريخية من خمسينيات القرن الماضي.
- استخدمت في أبحاث الذكاء الاصطناعي الأولى.
- لم تعد شائعة في المشاريع الحديثة.
- مهمة تاريخيا لأنها شكلت أسس المجال.
اختيار لغة البرمجة يعتمد على هدفك وطبيعة المشروع الذي تريد بناءه. فإذا كنت مبتدئا وتريد دخول المجال، فابدأ بـPython لأنها الأسهل والأوسع انتشارا. وإذا كنت تريد العمل على الأداء العالي والأنظمة المضمنة، فاتجه إلى C++. وإذا كنت مهتما بـتطبيقات الويب، فـJavaScript هي خيارك. أما إذا كنت تعمل في مؤسسة كبيرة، فـJava خيار معتمد. وللبحث العلمي، Julia لغة قوية. وأخيرا، LISP تبقى جزءا من تاريخ المجال، لا من حاضره.
مقالة ذات صلة: تعلم الذكاء الاصطناعي AI مجانًا مباشرةً من أكبر 10 شركات – فرصة ذهبية لعلم المستقبل.
تطبيق الذكاء الاصطناعي في مختلف الأعمال

يمكن استخدام هذا العلم في أعمال مختلفة وسيجلب العديد من الفوائد في كل عمل. وفيما يلي بعض الأمثلة على هذه التطبيقات في كل مجال:
الصحة
الهدف الأساسي لاستخدام الذكاء الاصطناعي في الطب هو تحسين نتائج المرضى مع خفض التكاليف. تتطلع شركات الرعاية الصحية إلى توظيف التعلم الآلي لتحسين وتسريع عملية التشخيص والعلاج. يعد IBM Watson أحد أشهر الأنظمة في الصناعة. تفهم هذه التكنولوجيا اللغة البسيطة ويمكنها الإجابة على الاستفسارات.
يجمع هذا النظام جميع المعلومات المتاحة عن المريض لإنشاء فرضية ثم تقديمها بعد تأكيدها. يمكن للتطبيقات الأخرى التي تعمل بالذكاء الاصطناعي، بما في ذلك برامج الدردشة الآلية، مساعدة المرضى في التخطيط للمواعيد والإجابة على الاستفسارات وإصدار الفواتير وتقديم الملاحظات الطبية كمساعد صحي افتراضي.
الأعمال
من المكن تطبيق تقنيات الأتمتة الروبوتية على العمليات والإجراءات المتكررة للغاية التي يقوم بها الأشخاص في أي مؤسسة. يساعد دمج خوارزميات التعلم الآلي مع التحليلات وإدارة علاقات العملاء في تقديم خدمة أفضل للعملاء من خلال تحديد المعلومات ذات الصلة. يمكن أيضًا استخدام Chatbots لتقديم مساعدة العملاء في الوقت الفعلي على مواقع الويب.
مجال التعليم
مما لاشك في أن الذكاء الاصطناعي في التعليم يساعد في أتمتة تسجيل الطلاب وتصنيفهم، مما يوفر وقت المعلمين. يمكن للذكاء الاصطناعي تقييم التلاميذ والتكيف مع متطلباتهم، والعمل معهم بالسرعة التي تناسبهم. وايضآ يمكن لأنظمة المعلم المعتمدة على الذكاء المتطور أن تساعد الطلاب على الدراسة بشكل أكثر فعالية والبقاء على المسار الصحيح. يتمتع الذكاء الصناعي بالقدرة على تغيير طريقة ومكان دراسة الأطفال، وكذلك بعض أساتذتهم.
الذكاء الاصطناعي في مجال الاقتصاد
قد تقوم خوارزميات الذكاء الاصطناعي في أدوات التمويل الشخصي، مثل Mint أو Turbo Tax، بجمع المعلومات المالية لكل فرد وتقديم المشورة المالية. قد تُستخدم أيضًا تطبيقات أخرى، مثل IBM Watson، أثناء عملية شراء المنزل. اليوم، تشكل البرمجيات جزءًا كبيرًا من التداول في وول ستريت.
القانون والعدالة
كثيرًا ما يواجه البشر صعوبة في اكتشاف المستندات. يمكن أن تساعد الأتمتة والذكاء الاصطناعي في تسريع العملية والاستفادة بشكل أفضل من الوقت. تعمل الشركات الناشئة على تطوير مساعدين حاسوبيين يمكنهم تصفية الاستفسارات والإجابات والرد على الاستفسارات المبرمجة في علم الوجود من خلال مراجعة المواد وتصنيفها.
الإنتاج
هذا هو المجال الذي يمكن للروبوتات فيه تعميم العمل قدر الإمكان. يمكن للروبوتات الصناعية أداء كل مهمة معينة بشكل كامل والعمل بشكل مستقل عن الموظفين البشريين.
إرساء الأمن
تُستخدم تقنيات الذكاء الإصطناعي ومعالجة الصور لبناء الأمن وتعقب المجرمين وتحديد هوياتهم وما إلى ذلك. تستخدم هذه الأنظمة الذكاء الاصطناعي لاكتشاف وجوه الأشخاص المختلفة ووجود الأشياء وما إلى ذلك.
تفسير البيانات
يشير مصطلح “البيانات الضخمة” إلى كميات هائلة من البيانات، المنظمة وغير المنظمة. يمكن استخدام البيانات الضخمة لاستخراج المعلومات المطلوبة للاختيارات الأساسية والحاسمة، وكذلك لتنفيذ الأنشطة الاستراتيجية والحساسة. قد يستخدم عالم البيانات تلك البيانات الضخمة لفحص متطلبات الأشخاص مع التعرف أيضًا على قوانين السوق والاتجاهات الأخرى.
إن تحليل كميات هائلة من البيانات أمر مستحيل بدون نظام ذكي ولا يمكن القيام به إلا من قبل البشر. لأن حجم البيانات ضخم ويتزايد يوما بعد يوم. ونتيجة لذلك فإن استخدام الذكاء الإصطناعي في تفسير البيانات الضخمة يؤدي إلى اكتشاف العديد من المفاهيم الجديدة.
ما الفرق بين التعلم الآلي والتعلم العميق للذكاء الاصطناعي؟
يوضح الجدول التالي الفروق بين الذكاء الإصطناعي والتعلم الآلي والتعلم العميق:
| الميزة | الذكاء الاصطناعي (AI) | التعلم الآلي (ML) | التعلم العميق (DL) |
|---|---|---|---|
| التعريف | محاكاة الذكاء البشري بواسطة الآلات | فرع من الذكاء الاصطناعي يسمح للبرامج بالتعلم من البيانات والتنبؤ | فرع من التعلم الآلي يستخدم الشبكات العصبية الاصطناعية لتعلم الأنماط المعقدة |
| الهدف | إنشاء آلات ذكية | زيادة دقة التنبؤ واتخاذ القرارات | تطوير أنظمة ذكاء اصطناعي أكثر تقدماً |
| طريقة العمل | استخدام تقنيات متنوعة، من القواعد المحددة مسبقًا إلى الخوارزميات المعقدة | التعلم من البيانات السابقة لتعلم الأنماط والتنبؤ بالنتائج الجديدة | استخدام الشبكات العصبية الاصطناعية لمعالجة المعلومات والتعلم |
| البيانات | بيانات متنوعة ذات هيكل محدد أو غير محدد | كميات كبيرة من البيانات المنظمة لتدريب الخوارزمية | كميات هائلة من البيانات المنظمة |
| المثال | التعرف على الوجوه، الروبوتات الصناعية | فلاتر البريد المزعج، أنظمة توصية المنتجات | الترجمة الآلية، التعرف على الكلام، السيارات ذاتية القيادة |
المخاطر التي يشكلها الذكاء الاصطناعي
تُعتبر تكنولوجيا الذكاء الاصطناعي مصدرًا للعديد من المخاطر التي تشمل العواقب الأخلاقية والاجتماعية والاقتصادية. مع زيادة الاعتماد على التشغيل الآلي في مجالات مثل التسويق الرقمي والرعاية الصحية، يواجه العديد من العمال خطر فقدان وظائفهم. على الرغم من أن هذه التكنولوجيا قد تخلق بعض الوظائف الجديدة، إلا أنها غالبًا ما تتطلب مهارات تقنية عالية.
التحيزات والخصوصية
تمثل التحيزات في الأنظمة الذكية تحديًا كبيرًا. على سبيل المثال، تُستخدم خوارزميات الشرطة التنبؤية في الولايات المتحدة لتحديد المناطق المحتملة للجريمة، ولكنها تعتمد على بيانات الاعتقال التي قد تكون متحيزة. بالإضافة إلى ذلك، هناك مخاوف بشأن الخصوصية، حيث يتطلب الذكاء الاصطناعي جمع ومعالجة كميات ضخمة من البيانات، مما يعرضها لخطر الوصول غير المصرح به.
الأثر البيئي
يتطلب تشغيل مراكز البيانات التي تستضيف نماذج الذكاء الإصطناعي كميات هائلة من الكهرباء. على سبيل المثال، يُقدر أن مراكز البيانات ستستهلك حوالي 8% من الكهرباء في الولايات المتحدة بحلول عام 2030. وتعهدت شركات مثل مايكروسوفت بأن تكون محايدة للكربون، لكن انبعاثاتها زادت بشكل ملحوظ.
التشريعات والتنظيم
اعتبارًا من عام 2024، هناك قوانين قليلة تنظم الذكاء الإصطناعي بشكل شامل. تُنظم اللائحة العامة لحماية البيانات (GDPR) وقانون خصوصية المستهلك في كاليفورنيا (CCPA) نماذج AI فقط عندما تستخدم المعلومات الشخصية. في مارس 2024، أقر الاتحاد الأوروبي قانونًا يحظر النماذج التي تقيّم سلوك المواطنين أو تحاول التلاعب بهم، ويتطلب تسجيل النماذج “عالية الخطورة”.
حقوق الطبع والنشر والعمل
أدى الذكاء الاصطناعي إلى قضايا تتعلق بحقوق الطبع والنشر، مثل استخدام الأعمال المحمية لإنشاء محتوى جديد. بدأت قضايا قانونية في 2023 ضد الشركات التي تستخدم الصور غير المرخصة. علاوة على ذلك، تعتمد الكثير من هذه التكنولوجيا على عمال مستغلين في الدول النامية، مثل العمال الكينيين الذين استخدمتهم شركة OpenAI لتصفية محتوى ChatGPT.
ما هي المميزات والتحديات للذكاء الاصطناعي؟
حتى هذه النقطة من المقال، فهمنا “ما هو الذكاء الاصطناعي وكيف يعمل؟“. عند التحدث إلى هذا المساعد المهم الذي أصبح جزءًا من حياتنا اليومية، يجب أن نفكر في جانبه الآخر. الأمر متروك لك لتقرر ما إذا كان أقرب صديق لك أو خصمًا جعلك غير سعيد. ما زلنا نريد أشخاصًا يفهمون كيفية التعامل مع الذكاء الاصطناعي، وفي بيئة اليوم، تعتبر هذه المعرفة كفاءة. لا تقلق، ما زلنا بعيدين عن عالم تحكم فيه الآلات المتقدمة الناس. في الجدول أدناه، نظرنا في مزايا وتحديات الذكاء الاصطناعي:
| مميزات الذكاء الاصطناعي | تحديات الذكاء الاصطناعي |
|---|---|
| الذكاء الاصطناعي فعال جدًا في أداء المهام الدقيقة مثل تشخيص الأمراض. | تطوير واستخدام أنظمة الذكاء الاصطناعي يتطلب استثمارات كبيرة. |
| يمكن للذكاء الاصطناعي معالجة وتحليل كميات ضخمة من البيانات في وقت قصير. | استخدام أدوات الذكاء الاصطناعي يحتاج إلى معرفة ومهارات تخصصية في هذا المجال. |
| الذكاء الاصطناعي يمكنه توفير التكاليف من خلال أتمتة المهام وزيادة الكفاءة. | لا يزال عدد المتخصصين في مجال الذكاء الاصطناعي غير كافٍ. |
| يمكن للذكاء الاصطناعي تقديم الخدمات على مدار الساعة دون الحاجة إلى استراحة. | قد يتعلم الذكاء الاصطناعي التحيزات الموجودة في البيانات ويعززها. |
| يمكن للذكاء الاصطناعي تقديم تجربة مخصصة للمستخدمين. | يؤدي الذكاء الاصطناعي إلى فقدان بعض الأشخاص لوظائفهم. |
| الذكاء الاصطناعي يتعلم ويتطور باستمرار. | قد يقدم الذكاء الاصطناعي نتائج غير دقيقة بسبب التحيزات في البيانات. |
| يمكن للذكاء الاصطناعي مساعدة البشر في المهام الإبداعية مثل الرسم والموسيقى. | مراقبة ومتابعة أداء أنظمة الذكاء الاصطناعي يمكن أن تكون تحدياً. |
| يمكن للذكاء الاصطناعي أن يستخدم في مجالات متنوعة مثل الأمن السيبراني والدفاع الوطني. | |
| يمكن للذكاء الاصطناعي المساهمة في تحسين جودة الحياة في مجالات مثل الرعاية الصحية والتعليم والزراعة. |
ما هو مستقبل الذكاء الاصطناعي؟
إذا كنت مهتمًا بمستقبل الذكاء الاصطناعي، فأنت بلا شك على دراية بعصر الروبوتات والتقنيات الذكية. ورغم اعتقاد البعض بأن الروبوتات ستحل محل الموظفين، إلا أن هذا لم يحدث بعد، على الأقل في العالم العربي ككل؛ لذا اقرأ هذا القسم دون خوف من البطالة أو الهزيمة أمام الذكاء المتطور.
ونظرًا للطريقة التي يتم بها تصويره في وسائل الإعلام وأفلام الخيال العلمي، فمن المعقول أن يحل محل الموظفين في نهاية المطاف. وعلى الرغم من كل مخاطر الذكاء الاصطناعي التي ناقشناها في القسم السابق، ستظل هناك فرص عمل للناس، وليس للذكاء الاصطناعي. يعتقد مارك جيونجيوسي، مؤسس Onetrack.AI، إحدى الشركات الرائدة عالميًا في مجال الذكاء الاصطناعي:
في المستقبل، سيكون تعلم البرمجة مثل تعلم لغة جديدة. إذا كنت لا تعرف البرمجة والبرمجة، فسيكون وضعك أكثر صعوبة.
حتى قبل بضع سنوات، كان مستقبل الذكاء الإصطناعي التوليدي يتمثل في الروبوتات الدرداسة ومولِّدات الصور مثل ChatGPT وMidjourney، التي أصبحت متاحة للجمهور منذ فترة ومن المتوقع تحقيق تطورات كبيرة في السنوات القادمة. على سبيل المثال، تعمل شركة OpenAI على النسخة الخامسة من نموذج اللغة GPT الكبير، والذي يُزعم أنه سيحقق إنجازات في عالم روبوتات درداسة.
في وقت ما، كانت فكرة أن شخصين يتحدثان لغتين مختلفتين يمكنهما التحدث مع بعضهما وفهم بعضهما في نفس الوقت تحققًا فقط في قصص الخيال العلمي وألعاب Mass Effect؛ ولكن من غير المستبعد أن يحول الذكاء المتطور مثل هذه الفكرة إلى واقع.
الشيء الأكثر توقعًا فيما يتعلق بالذكاء الاصطناعي في الخمسين عامًا القادمة هو أنه مثلما أصبح فهم اللغة الإنجليزية مهمًا في عالم اليوم، فإن العمل معه سيصبح أيضًا أمرًا لا بد منه.
هل للذكاء الاصطناعي قدرة على تدمير البشرية؟

أولاً، دعونا نكرر القيود الحالية للذكاء الاصطناعي؛ إذا كان هناك شيء واحد آمل أن تكون قد تعلمته من قراءة هذا، فهو أن نجاح التعلم الآلي أو الذكاء الاصطناعي يعتمد بشكل كبير على النماذج التي نختار تدريبها.
لذا، مع كل التقدم الذي أحرزناه في هذا المجال، إلى متى يتعين علينا انتظار الروبوتات القاتلة مثل Skynet في أفلام Terminator أو HAL 9000 في Space Odyssey؟
إذا كنت تشاهد أفلام وثائقية عن الحياة البرية، فربما لاحظت أنه في نهاية كل منها، يتحدث الناس عن كيف سيتم تدمير هذا الجمال قريبًا من قبل البشر. لهذا السبب، أعتقد أن أي مناقشة مسؤولية AI يجب أن تعالج أيضًا قيوده وتداعياته الاجتماعية.
إذا بنى البشر هذه الشبكات دون اتباع المعايير والمبادئ الأساسية، أو استخدموا بيانات غير صحيحة ومضللة لتدريب هذه التكنولوجيا المتقدمة، فقد يكون لهذه المشاكل آثار كارثية.
الشبكات العصبية العميقة قوية ومرنة بشكل لا يصدق، لكنها ليست سحرية. في حين يمكن استخدام الشبكات العصبية العميقة والشبكات متعددة الطبقات (CNNs) لمجموعة متنوعة من الأغراض، تجدر الإشارة إلى أن البنية الأساسية لهاتين الشبكتين مختلفة تمامًا، وحتى الآن كان على البشر تعريفهما مسبقًا.
لذا، في حين يمكن إعادة تدريب شبكة عصبية عميقة مدربة على التعرف على السيارات للتعرف على الطيور، لا يمكن استخدام هذا النموذج لفهم الكلام.
ببساطة، الأمر أشبه بأننا نفهم كيف تعمل القشرة البصرية والقشرة السمعية، لكن ليس لدينا أي فكرة عن كيفية عمل القشرة المخية ومن أين نبدأ في فهمها. وهذا يعني على الأرجح أننا لن نمتلك ذكاء اصطناعي شبيه بالإنسان على غرار هوليوود في أي وقت قريب.
بالطبع، هذا لا يعني أن التكنولوجيا الذكية الحالية لا يمكن أن يكون لها تأثيرات اجتماعية سلبية. لذا، فإن تعلم المفاهيم الأساسية للذكاء الاصطناعي قد يكون أقل ما يمكننا فعله لإيجاد طريقة لحل مشاكل الـ AI ومنع تدمير الأرض.
كلمة أخيرة
الذكاء الاصطناعي ما هو؟ لم يعد هذا السؤال مرتبطا بالمستقبل البعيد، بل أصبح جزءا من واقعنا الرقمي اليوم. فقد انتقل الذكاء الاصطناعي من كونه مجالا بحثيا متخصصا إلى تقنية تدخل في محركات البحث والهواتف والتطبيقات والطب والتعليم والأعمال والبرمجة وغيرها من المجالات. ومع ذلك، تظل قيمته الحقيقية مرتبطة بالطريقة التي يستخدمها بها الإنسان، فهو يمكن أن يكون أداة قوية لزيادة الإنتاجية وتطوير الأفكار وحل المشكلات، كما قد يؤدي استخدامه بصورة غير مسؤولة إلى أخطاء ومخاطر جديدة.
ومن المهم أيضا ألا ننظر إلى الذكاء الاصطناعي باعتباره بديلا كاملا عن الإنسان في جميع المجالات. فرغم التطور الكبير في قدرات النماذج الحديثة، ما زالت هناك اختلافات جوهرية بين معالجة الآلة للمعلومات والفهم البشري، كما أن جودة النتائج تعتمد على البيانات والنموذج وطريقة استخدام النظام. لذلك، فإن المستقبل لا يتعلق فقط بمدى تطور الذكاء الاصطناعي، بل بكيفية دمجه مع الخبرة البشرية ووضع الضوابط التي تساعد على استخدامه بصورة أكثر أمانا وفائدة.
أما السنوات والعقود القادمة، فمن المتوقع أن يستمر الذكاء الاصطناعي في التطور وأن يدخل مجالات جديدة مع تحسن قدراته على فهم النصوص والصور والصوت والتفاعل مع الأنظمة والأجهزة. ومع ذلك، يبقى شكل هذا المستقبل مفتوحا على احتمالات متعددة، ولذلك فإن السؤال الأهم ليس فقط إلى أين سيصل الذكاء الاصطناعي؟ بل كيف سيستخدمه الإنسان لبناء مستقبل أكثر فائدة وكفاءة، مع الحفاظ على دوره في اتخاذ القرارات وتحمل المسؤولية. ويبقى فهم هذه التقنية وتعلم أساسياتها خطوة مهمة لكل شخص يريد مواكبة التحول الرقمي في السنوات القادمة.