أنواع قواعد البيانات: استكشف 14 شكلًا من تخزين البيانات الحديثة

في عصر تتدفق فيه البيانات بكميات هائلة، وتتزايد المعلومات التي تنتجها التطبيقات والمواقع والأجهزة والخدمات الرقمية باستمرار، أصبحت أنواع قواعد البيانات جزءا أساسيا من عالم التقنية. فبدلا من ترك البيانات مبعثرة داخل ملفات ومصادر مختلفة، توفر قواعد البيانات أنظمة منظمة تساعد على تخزين المعلومات وإدارتها واسترجاعها بطريقة أكثر كفاءة.
ومع ذلك، فإن قواعد البيانات ليست نظاما واحدا يناسب جميع الاستخدامات، بل هي عالم متنوع يضم نماذج وتقنيات متعددة، صمم كل منها لتلبية احتياجات مختلفة. فمن قواعد البيانات العلائقية (Relational Databases) التي تعتمد على الجداول والعلاقات المنظمة، إلى قواعد البيانات غير العلائقية (NoSQL Databases) التي توفر نماذج مختلفة لتخزين البيانات، وصولا إلى قواعد البيانات المتخصصة في التحليلات أو البيانات الزمنية أو التخزين داخل الذاكرة.
وفي هذا المقال، سنستعرض أهم أنواع قواعد البيانات وتصنيفاتها، مع توضيح المعيار الذي يعتمد عليه كل تصنيف، وشرح خصائص كل نوع وأبرز استخداماته، حتى تتمكن من فهم الفروق بينها ومعرفة متى يكون كل نوع مناسبا لطبيعة المشروع والبيانات التي يتعامل معها.
جدول المحتويات
- ما هو مفهوم قواعد البيانات؟
- لماذا توجد أنواع مختلفة من قواعد البيانات؟
- ما الغرض من استخدام أنواع قواعد البيانات؟
- أنواع قواعد البيانات
- أولا: أنواع قواعد البيانات حسب نموذج البيانات
- ثانيا: أنواع قواعد البيانات حسب طريقة تخزين البيانات ومعالجتها
- ثالثا: أنواع قواعد البيانات حسب البنية والتوزيع
- رابعا: أنواع قواعد البيانات حسب بيئة التشغيل والإدارة
- خامسا: قواعد البيانات والتقنيات المتخصصة
- سادسا: قواعد البيانات حسب الترخيص ونموذج التطوير
- ما هي أهمية أنواع قواعد البيانات؟
- الخاتمة
ما هو مفهوم قواعد البيانات؟
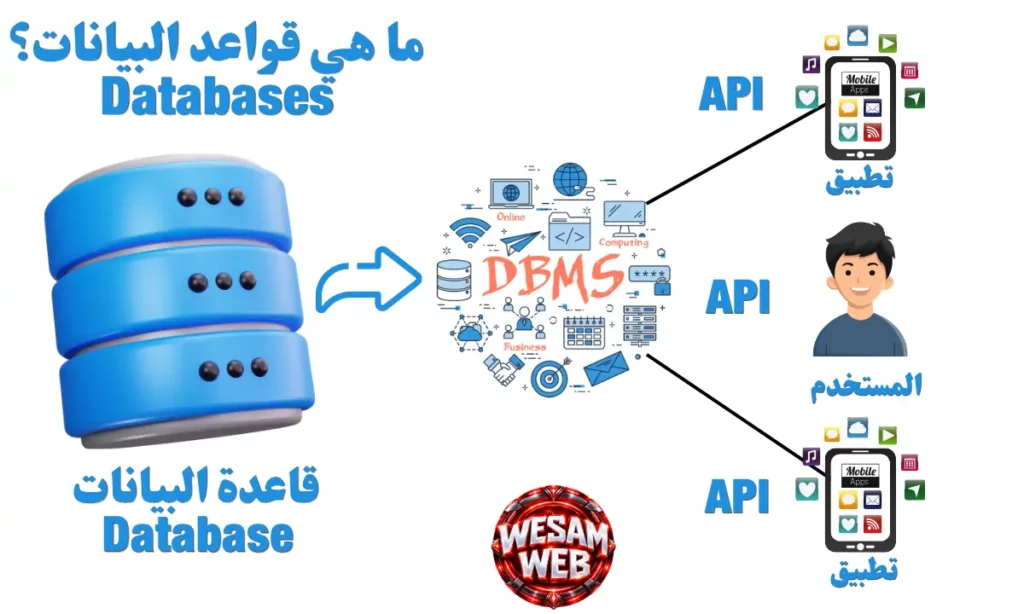
يعد مفهوم قواعد البيانات (Databases) من أهم المفاهيم الأساسية التي يحتاج المبتدئ في مجال التكنولوجيا إلى فهمها، لأنها تمثل جزءا أساسيا من عدد كبير من التطبيقات والأنظمة الرقمية الحديثة. وببساطة، قاعدة البيانات هي مجموعة منظمة من البيانات يتم تخزينها وإدارتها باستخدام نظام مخصص، بما يسمح بالوصول إليها والبحث فيها وتعديلها ومعالجتها وفقا لاحتياجات النظام.
ولا تقتصر قاعدة البيانات على مجرد مكان لتخزين المعلومات، بل تعمل ضمن منظومة تشمل عادة نظام إدارة قواعد البيانات (DBMS)، وهو البرنامج المسؤول عن إنشاء البيانات وإدارتها وتنظيم الوصول إليها وتنفيذ العمليات المختلفة عليها. ويختلف شكل تخزين البيانات وطريقة التعامل معها وفقا لنموذج قاعدة البيانات ونظام إدارة قواعد البيانات المستخدم.
تستخدم قواعد البيانات في عدد هائل من المجالات والتطبيقات. ففي الشركات، يمكن استخدامها لإدارة بيانات العملاء والمخزون والمبيعات والطلبات، بينما تعتمد عليها المواقع والتطبيقات في تخزين بيانات المستخدمين والمحتوى والإعدادات وسجلات العمليات. كما تستخدم في الأنظمة الحكومية والمالية والصحية والصناعية وغيرها من المجالات التي تتطلب إدارة كميات كبيرة من البيانات بصورة منظمة.
لماذا توجد أنواع مختلفة من قواعد البيانات؟
لا توجد قاعدة بيانات واحدة يمكنها تقديم الحل الأفضل لجميع أنواع التطبيقات والبيانات. فقد يحتاج أحد الأنظمة إلى علاقات واضحة بين البيانات ومعاملات دقيقة، بينما يحتاج نظام آخر إلى التعامل مع بيانات شبه منظمة أو إلى توزيع البيانات على عدة خوادم أو إلى تنفيذ عمليات تحليلية على كميات ضخمة من المعلومات.
لهذا ظهرت نماذج وتقنيات متعددة لـ أنواع قواعد البيانات، تختلف في طريقة تنظيم البيانات وتخزينها ومعالجتها وتوزيعها وإدارتها. ومن أشهرها قواعد البيانات العلائقية، وقواعد البيانات غير العلائقية، وقواعد البيانات الموزعة، وقواعد البيانات داخل الذاكرة، إلى جانب أنواع متخصصة أخرى.
ومن المهم هنا الانتباه إلى أن كلمة “نوع” في قواعد البيانات قد تشير إلى أكثر من معيار للتصنيف. فقد نصنف قاعدة البيانات وفقا لنموذج البيانات، أو وفقا لطريقة التخزين والمعالجة، أو وفقا للبنية والتوزيع، أو وفقا لبيئة التشغيل والإدارة. لذلك قد تنتمي قاعدة البيانات نفسها إلى أكثر من تصنيف في الوقت ذاته.
ومع تطور التحول الرقمي، أصبحت قواعد البيانات ليست مجرد أداة مساعدة، بل عنصراً استراتيجياً لا غنى عنه في بناء أي مشروع تقني أو تجاري. وبناء على ذلك، لن نتعامل مع الأنواع التالية على أنها قائمة واحدة من الأنواع المتنافسة، بل سنقسمها وفقا لمعيار التصنيف، حتى يصبح الفرق بينها أكثر وضوحا ودقة.
مقالة ذات صلة: قواعد البيانات(Databases): تعرف على العمود الفقري لكل نظام رقمي
ما الغرض من استخدام أنواع قواعد البيانات؟

تتفاعل التطبيقات مع أنواع قواعد البيانات من خلال كود البرمجة (Programming Code) لتخزين البيانات أو استرجاعها عند الحاجة. على سبيل المثال، عند إنشاء ملف شخصي جديد في إحدى منصات التواصل الاجتماعي، يتم حفظ جميع البيانات التي أدخلتها داخل قاعدة البيانات ليُعاد استخدامها لاحقاً عند تسجيل الدخول أو عرض صفحتك.
أهم استخدامات قواعد البيانات:
- تخزين واسترجاع البيانات: سواء كانت نصوصاً، أرقاماً، صوراً، أو وسائط متعددة
- معالجة البيانات (Data Processing): مثل التجميع (Aggregation)، الفرز (Sorting)، التصفية (Filtering)، والتحضير المسبق للبيانات المستخدمة في التحليلات (Data Analytics)
- حفظ البيانات بأمان (Data Persistence): لضمان بقاء المعلومات متاحة للاستخدام المستقبلي دون فقدانها
- الوصول الآمن والموثوق (Secure Access): عبر أنظمة إدارة صلاحيات تضمن أن البيانات متاحة فقط للمستخدمين المخوّلين
- إدارة العلاقات (Data Relationships): أي تحديد الروابط والارتباطات بين الجداول والبيانات المخزّنة لضمان تكامل المعلومات (Data Integrity)
وبالإضافة إلى ذلك، أصبحت قواعد البيانات اليوم تدعم تطبيقات أكثر تعقيداً مثل: الذكاء الاصطناعي (AI)، تحليل البيانات الضخمة (Big Data Analytics)، والحوسبة السحابية (Cloud Computing). ما يجعلها العمود الفقري للبنية التحتية الرقمية الحديثة.
أنواع قواعد البيانات

تتنوع أنواع قواعد البيانات لتلبية احتياجات مختلفة تتعلق بحجم البيانات، وسرعة المعالجة، وطريقة التخزين، وطبيعة الاستخدام، وآلية توزيع البيانات وإدارتها. لذلك، لا يمكن تصنيف جميع قواعد البيانات وفق معيار واحد، إذ تختلف طريقة تصنيفها بحسب نموذج البيانات، وطريقة التخزين والمعالجة، والبنية والتوزيع، وبيئة التشغيل والإدارة.
في هذا القسم، نستعرض أبرز أنواع وقواعد تصنيفات قواعد البيانات، بدءا من قواعد البيانات العلائقية (Relational Databases) وقواعد بيانات NoSQL، وصولا إلى قواعد البيانات السحابية والزمنية والموزعة، إلى جانب نماذج متخصصة تستخدم في تطبيقات مثل الذكاء الاصطناعي، وإنترنت الأشياء (IoT)، وتحليلات البيانات في الوقت الفعلي. ويساعد فهم الفروقات بين هذه الأنواع والتصنيفات على معرفة طبيعة كل قاعدة بيانات ومتى تكون مناسبة للاستخدام.
أولا: أنواع قواعد البيانات حسب نموذج البيانات
يعد نموذج البيانات (Data Model) أحد أهم المعايير المستخدمة لفهم أنواع قواعد البيانات. فهو يحدد الطريقة التي تنظم بها البيانات والعلاقات بينها داخل النظام. وتختلف هذه النماذج من الجداول والعلاقات في قواعد البيانات العلائقية، إلى المستندات والمفتاح والقيمة والرسم البياني والأعمدة العريضة في بعض قواعد بيانات NoSQL، إضافة إلى النماذج الكائنية والهرمية.
1. قاعدة البيانات العلائقية (Relational Database)

تعد قواعد البيانات العلائقية (Relational Databases) من أشهر أنواع قواعد البيانات، وقد ظهرت فكرتها الأساسية في سبعينيات القرن العشرين وما زالت تستخدم على نطاق واسع حتى اليوم. يعتمد هذا النموذج على تنظيم البيانات في جداول (Tables) مترابطة، ويتكون كل جدول عادة من صفوف (Rows) وأعمدة (Columns)، بحيث يمثل الصف سجلا، بينما يمثل العمود نوعا محددا من البيانات.
ويستخدم نظام إدارة قواعد البيانات العلائقية (Relational Database Management System | RDBMS) لإنشاء قواعد البيانات والجداول وإدارتها وتنفيذ العمليات المختلفة عليها، مثل إضافة البيانات وتعديلها وحذفها واسترجاعها.
وتعد لغة الاستعلام الهيكلية SQL اللغة الأكثر شيوعا للتعامل مع قواعد البيانات العلائقية. وتستخدم لتنفيذ عمليات مختلفة، مثل إنشاء الجداول واسترجاع البيانات وإدخالها وتعديلها وحذفها، مع اختلاف بعض التفاصيل والأوامر المدعومة من نظام إدارة قواعد البيانات المستخدم.
وتدعم العديد من أنظمة قواعد البيانات العلائقية المعاملات (Transactions) وفق خصائص ACID، وهي مجموعة من الخصائص التي تهدف إلى ضمان موثوقية المعاملات وسلامة نتائجها. ويشير الاختصار ACID إلى أربعة مفاهيم رئيسية:
- الذرية (Atomicity): تنفذ المعاملة بالكامل أو يتم التراجع عنها ككل.
- الاتساق (Consistency): تحافظ المعاملة الناجحة على القيود والقواعد التي تفرضها قاعدة البيانات.
- العزل (Isolation): تحد من تأثير المعاملات المتزامنة في بعضها وفقا لمستوى العزل المستخدم.
- المداومة (Durability): تضمن بقاء التغييرات التي تم اعتمادها حتى في حال حدوث أعطال معينة، وفقا لآليات النظام.
وتناسب قواعد البيانات العلائقية بشكل خاص البيانات المهيكلة (Structured Data) التي يمكن تنظيمها ضمن مخطط واضح من الجداول والأعمدة والعلاقات. ومع ذلك، لا يعني ذلك أنها غير قادرة على التعامل مع البيانات غير المهيكلة أو شبه المهيكلة على الإطلاق، إذ توفر بعض الأنظمة العلائقية إمكانات لتخزين ومعالجة أنواع مختلفة من البيانات. لذلك يعتمد اختيار النموذج على طبيعة البيانات ومتطلبات التطبيق.
ومن أمثلة أنظمة إدارة قواعد البيانات العلائقية:
- Microsoft SQL Server
- Oracle Database
- MySQL
- PostgreSQL
- IBM Db2
مميزات قواعد البيانات العلائقية
تتميز قواعد البيانات العلائقية بمجموعة من الخصائص التي جعلتها من أكثر نماذج قواعد البيانات استخداما في التطبيقات والأنظمة المختلفة. ويعود ذلك إلى وضوح نموذجها، وقوة أدوات الاستعلام، ودعمها للعلاقات والقيود والمعاملات في كثير من أنظمة إدارة قواعد البيانات.
ومن أبرز مزايا قواعد البيانات العلائقية ما يلي:
1. بساطة النموذج (Simplicity of the Model)
يعتمد النموذج العلائقي على بنية واضحة تتكون أساسا من الجداول والصفوف والأعمدة والعلاقات، مما يجعل فهم البيانات وإدارتها أسهل، خصوصا عند التعامل مع البيانات المهيكلة.
كما توفر SQL طريقة موحدة نسبيا للتعامل مع البيانات وتنفيذ الاستعلامات، رغم اختلاف بعض التفاصيل بين أنظمة إدارة قواعد البيانات. وتساعد هذه البنية الواضحة المطورين ومحللي البيانات على فهم العلاقات بين البيانات وكتابة الاستعلامات اللازمة للوصول إليها.
2. دقة البيانات وسلامتها (Data Accuracy and Integrity)
توفر قواعد البيانات العلائقية مجموعة من الآليات التي تساعد على الحفاظ على سلامة البيانات (Data Integrity)، مثل المفتاح الأساسي (Primary Key) والمفتاح الخارجي (Foreign Key)، إضافة إلى القيود الأخرى مثل NOT NULL وUNIQUE وCHECK.
ويساعد المفتاح الأساسي على تمييز كل سجل داخل الجدول، بينما يستخدم المفتاح الخارجي لتمثيل العلاقات بين الجداول وربط السجلات المرتبطة ببعضها.
كما يمكن أن يساعد التصميم الجيد واستخدام التطبيع (Normalization) على تقليل التكرار غير الضروري ومشكلات تحديث البيانات. لكن وجود المفاتيح الأساسية والخارجية وحده لا يعني منع تكرار البيانات بشكل كامل، لأن ذلك يعتمد على تصميم قاعدة البيانات والقيود التي يحددها المطور.
3. سهولة الوصول إلى البيانات (Easy Data Access)
توفر SQL مرونة كبيرة في طريقة الوصول إلى البيانات، فلا يضطر المستخدم إلى اتباع مسار ثابت للوصول إلى المعلومات كما يحدث في بعض النماذج ذات البنية الهرمية. ويمكن كتابة استعلامات تسترجع البيانات وفقا لشروط متعددة، أو تجمع بيانات من عدة جداول باستخدام عمليات JOIN.
كما يمكن للمستخدم تحديد الأعمدة والسجلات التي يريد عرضها، وتصفية النتائج وترتيبها وتجميعها وفقا لمتطلبات الاستعلام.
وتجعل هذه المرونة من الممكن استخدام قاعدة البيانات نفسها لتنفيذ مجموعة واسعة من العمليات، بدءا من استرجاع سجل محدد، وصولا إلى إنشاء تقارير تعتمد على بيانات موزعة بين عدة جداول مترابطة.
4. سلامة البيانات (Data Integrity)
تعد سلامة البيانات من أبرز نقاط القوة في النموذج العلائقي، إذ توفر أنظمة إدارة قواعد البيانات مجموعة من القيود والآليات التي تساعد على منع إدخال بيانات غير صحيحة أو مخالفة للقواعد المحددة.
ومن أمثلة ذلك سلامة الكيان (Entity Integrity)، التي ترتبط بالمفتاح الأساسي، والسلامة المرجعية (Referential Integrity)، التي تساعد على الحفاظ على صحة العلاقات بين الجداول باستخدام المفاتيح الخارجية.
وتساعد هذه الآليات على تقليل وجود سجلات غير مكتملة أو علاقات غير صحيحة، لكنها لا تضمن جودة البيانات بشكل كامل، لأن جودة البيانات تعتمد أيضا على التصميم وقواعد العمل وطريقة إدخالها ومعالجتها.
5. المرونة وقابلية التوسع (Flexibility and Scalability)
يتميز النموذج العلائقي بقدر جيد من المرونة، إذ يمكن تعديل بنية قاعدة البيانات وإضافة الجداول والأعمدة والعلاقات عند تغير متطلبات المشروع. كما يمكن توسيع الأنظمة العلائقية لتتعامل مع كميات كبيرة من البيانات، لكن القدرة الفعلية على التوسع تعتمد على نظام إدارة أنواع قواعد البيانات والبنية التحتية وتصميم التطبيق.
ويمكن للمطور إضافة جداول أو أعمدة جديدة، أو تعديل البيانات الموجودة، أو إنشاء فهارس جديدة، وفقا لمتطلبات النظام. ومع ذلك، فإن تغيير مخطط قاعدة البيانات في نظام إنتاجي كبير قد يتطلب تخطيطا دقيقا، لأن التغييرات قد تؤثر في التطبيقات والاستعلامات والخدمات المرتبطة بها.
ولا يوجد حد واحد ثابت لعدد الصفوف أو الأعمدة أو الجداول يمكن تطبيقه على جميع قواعد البيانات العلائقية. إذ تختلف الحدود العملية وفقا لنظام إدارة قواعد البيانات وإصدار البرنامج والموارد المتاحة وتصميم النظام.
6. التطبيع (Normalization)
يمثل التطبيع (Normalization) مجموعة من القواعد والأساليب المستخدمة لتنظيم البيانات داخل الجداول العلائقية بهدف تقليل التكرار غير الضروري والحد من مشكلات إدخال البيانات وتعديلها وحذفها.
ويتم ذلك من خلال الأشكال الطبيعية (Normal Forms)، مثل الشكل الطبيعي الأول والثاني والثالث، حيث يضيف كل مستوى مجموعة من القواعد المتعلقة بتنظيم البيانات والاعتماديات بينها.
يساعد التطبيع على بناء تصميم أكثر اتساقا وتقليل بعض أنواع التكرار ومشكلات تحديث البيانات. ومع ذلك، لا يعني ذلك أن كل قاعدة بيانات يجب أن تصل دائما إلى أعلى مستوى ممكن من التطبيع، إذ قد تستخدم بعض الأنظمة إلغاء التطبيع (Denormalization) بشكل مقصود لتحسين أداء استعلامات معينة.
7. الأمان وإدارة الصلاحيات (Security and Access Control)
توفر أنظمة إدارة قواعد البيانات العلائقية آليات متعددة للتحكم في الوصول إلى البيانات، مثل المستخدمين والأدوار والصلاحيات (Users, Roles and Permissions). ويمكن من خلالها تحديد العمليات التي يسمح لكل حساب بتنفيذها على قواعد البيانات والجداول والبيانات، بحسب إمكانات النظام المستخدم.
فعلى سبيل المثال، يمكن منح حساب معين صلاحية قراءة بيانات جدول محدد، بينما يحصل حساب آخر على صلاحيات القراءة والكتابة، في حين تقتصر الصلاحيات الإدارية على الحسابات التي تحتاج إليها فعليا.
وتساعد هذه الآليات على تطبيق مبدأ الحد الأدنى من الصلاحيات (Least Privilege)، الذي يهدف إلى منح كل مستخدم أو تطبيق الصلاحيات الضرورية فقط لأداء مهامه.
8. دعم التغييرات المستقبلية
يسمح التصميم العلائقي المنظم بتعديل قاعدة البيانات مع تغير متطلبات المشروع. ويمكن، وفقا لتصميم النظام ونظام إدارة قواعد البيانات المستخدم، إضافة جداول أو أعمدة جديدة، أو تعديل العلاقات، أو تحديث البيانات الموجودة لتلبية متطلبات العمل الجديدة.
ومع ذلك، فإن مرونة التعديل لا تعني أن جميع التغييرات يمكن تنفيذها دون تأثيرات جانبية. ففي الأنظمة الكبيرة، قد يعتمد عدد كبير من التطبيقات والاستعلامات على مخطط قاعدة البيانات، ولذلك يجب التخطيط للتغييرات واختبارها قبل تطبيقها في بيئة الإنتاج.
وبفضل هذه الخصائص، أصبحت أنواع قواعد البيانات العلائقية خيارا أساسيا لتطبيقات كثيرة تحتاج إلى بيانات مهيكلة وعلاقات واضحة ومعاملات موثوقة، خصوصا في الأنظمة المالية والتجارية وتطبيقات إدارة العملاء والمخزون والطلبات وغيرها من الأنظمة التي تعتمد على سلامة العلاقات بين البيانات.
2. قاعدة البيانات NoSQL
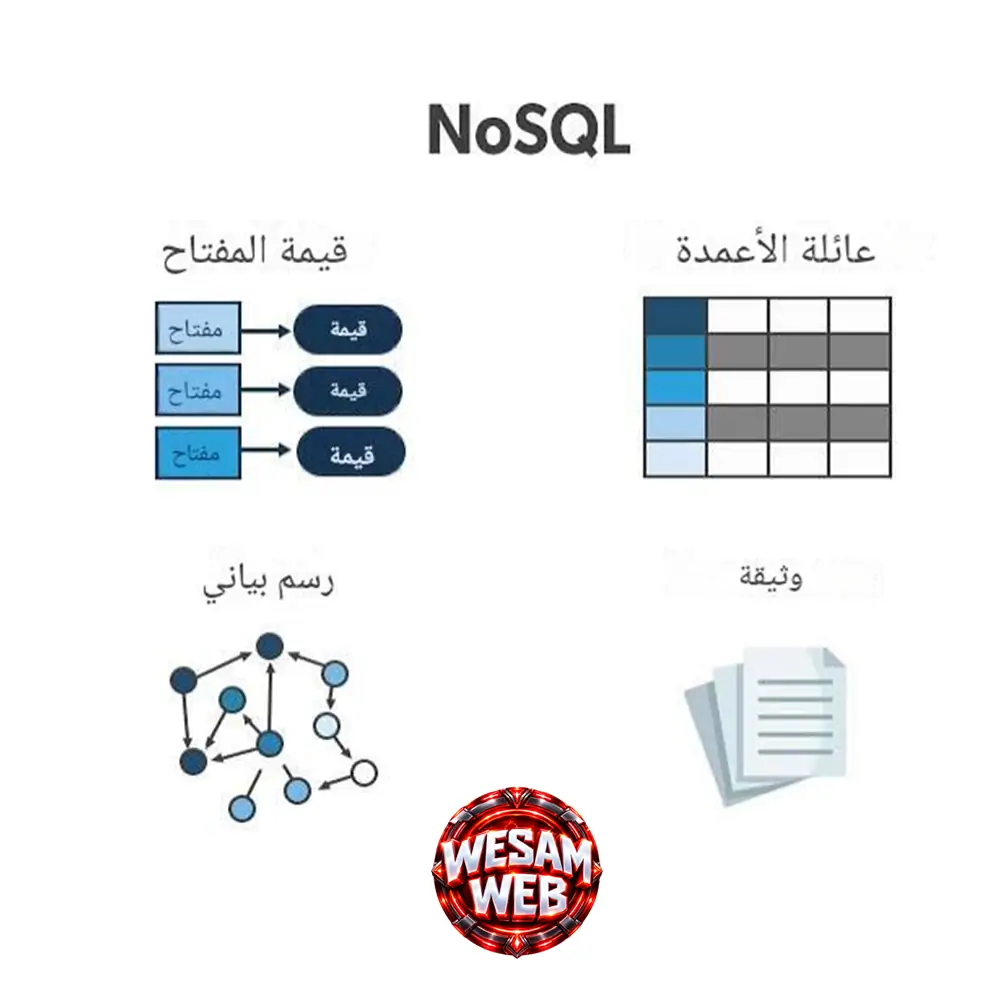
تعد قواعد بيانات NoSQL مجموعة من أنظمة قواعد البيانات التي تستخدم نماذج بيانات مختلفة عن النموذج العلائقي التقليدي. ويشير المصطلح تاريخيا إلى “Not Only SQL”، أي “ليس SQL فقط”، ولذلك لا يعني بالضرورة أن هذه الأنظمة لا تستخدم SQL، فبعض أنظمة NoSQL توفر بالفعل واجهات أو لغات استعلام تشبه SQL أو تدعمها لأغراض معينة.
وعلى عكس النموذج العلائقي الذي يعتمد عادة على جداول ومخطط محدد للعلاقات بين البيانات، تستخدم قواعد بيانات NoSQL نماذج مختلفة لتخزين البيانات، مثل المستندات (Documents) والمفتاح-القيمة (Key-Value) والعائلة العمودية (Wide-Column) والرسم البياني (Graph). وتختلف طريقة تنظيم البيانات والاستعلام عنها من نموذج إلى آخر.
وتوفر بعض قواعد بيانات NoSQL مرونة أكبر في مخطط البيانات (Schema)، مما يجعلها مناسبة للأنظمة التي تتغير فيها بنية البيانات باستمرار، أو التي تتعامل مع بيانات شبه مهيكلة (Semi-structured Data). ومع ذلك، لا يعني ذلك أن جميع قواعد بيانات NoSQL تعمل دون مخطط تماما، فبعضها يفرض قواعد أو هياكل محددة على البيانات بحسب تصميم النظام.
وتستخدم أنواع قواعد البيانات NoSQL في مجموعة واسعة من التطبيقات، خصوصا عندما تكون هناك حاجة إلى التوسع الأفقي (Horizontal Scaling)، أو التعامل مع كميات كبيرة من البيانات، أو توفير استجابة منخفضة التأخير، أو تخزين بيانات لا تناسبها البنية العلائقية بسهولة.
ومن أمثلة أنظمة قواعد بيانات NoSQL:
- MongoDB
- Couchbase
- CouchDB
- Apache Cassandra
- Amazon DynamoDB
- Redis
إلى كم فئة تنقسم قواعد بيانات NoSQL؟
يمكن تقسيم أشهر نماذج قواعد بيانات NoSQL وفقا لطريقة تنظيم البيانات إلى أربع فئات رئيسية:
- قواعد بيانات المستندات (Document Databases)
- قواعد بيانات المفتاح-القيمة (Key-Value Databases)
- قواعد البيانات ذات الأعمدة العريضة (Wide-Column Databases)
- قواعد بيانات الرسم البياني (Graph Databases)
ولا تعني هذه الفئات أن كل نظام NoSQL ينتمي حصرا إلى نموذج واحد في جميع الحالات، إذ توجد أنظمة متعددة النماذج (Multi-Model Databases) يمكنها دعم أكثر من طريقة لتنظيم البيانات.
مميزات قواعد بيانات NoSQL
تقدم قواعد بيانات NoSQL مجموعة من الخصائص التي تجعلها مناسبة لأنواع معينة من التطبيقات. وتختلف هذه الخصائص من نظام إلى آخر، لذلك لا يمكن اعتبار جميع المميزات التالية متوفرة بالطريقة نفسها في كل قاعدة بيانات NoSQL.
قاعدة بيانات ذات مخطط مرن (Flexible Schema)
تتميز العديد من قواعد بيانات NoSQL بمرونة أكبر في بنية البيانات مقارنة بالنموذج العلائقي التقليدي. ويمكن في بعض الأنظمة تخزين سجلات تختلف خصائصها عن بعضها داخل المجموعة أو الحاوية نفسها، دون الحاجة إلى تعديل مخطط مركزي لكل تغيير بسيط.
وتفيد هذه المرونة التطبيقات التي تتغير فيها بنية البيانات باستمرار، مثل بعض تطبيقات الويب والمحتوى الرقمي والأنظمة التي تستقبل بيانات من مصادر متعددة.
المخطط الديناميكي (Dynamic Schema)
يسمح بعض أنظمة NoSQL بتطوير بنية البيانات تدريجيا مع تغير متطلبات التطبيق. فعلى سبيل المثال، يمكن إضافة خصائص جديدة إلى مستندات البيانات دون الحاجة إلى إعادة تصميم جميع السجلات الموجودة مسبقا.
ومع ذلك، لا يعني ذلك أن تغيير بنية البيانات داخل NoSQL لا يحتاج إلى تخطيط. فقد تتطلب التغييرات الكبيرة تعديلات في التطبيق أو عمليات ترحيل للبيانات، بحسب النظام المستخدم وطريقة تصميمه.
دعم البيانات شبه المهيكلة (Semi-structured Data)
تتعامل العديد من قواعد بيانات NoSQL بشكل جيد مع البيانات شبه المهيكلة، مثل المستندات التي تستخدم تنسيقات JSON أو BSON. وتتميز هذه البيانات بوجود بنية عامة يمكن أن تتغير بعض خصائصها من سجل إلى آخر.
أما البيانات غير المهيكلة بالكامل، مثل النصوص والصور والفيديوهات، فلا يعني استخدام NoSQL أن قاعدة البيانات نفسها هي المكان الأفضل لتخزينها دائما. فقد تستخدم التطبيقات قواعد البيانات لتخزين البيانات الوصفية والمراجع، بينما تحفظ الملفات الكبيرة في أنظمة تخزين مخصصة لها.
هيكل الكائنات المتداخلة (Nested Object Structure)
تسمح بعض نماذج NoSQL، وخاصة قواعد بيانات المستندات (Document Databases)، بتخزين الكائنات والقوائم المتداخلة داخل المستند نفسه.
ويمكن أن يقلل ذلك الحاجة إلى تقسيم بعض البيانات المرتبطة منطقيا إلى عدد كبير من الجداول، كما قد يقلل الحاجة إلى تنفيذ عمليات ربط متعددة في بعض سيناريوهات القراءة. ومع ذلك، يعتمد ذلك على طبيعة البيانات وطريقة تصميم التطبيق، ولا يعني أن NoSQL تلغي عمليات الربط أو أن الربط غير موجود فيها دائما.
قابلية التوسع الأفقي (Horizontal Scalability)
تدعم العديد من أنظمة NoSQL التوسع الأفقي، أي إضافة خوادم أو عقد جديدة إلى النظام لتوزيع البيانات وأحمال العمل بينها. وتعد هذه الخاصية من الأسباب المهمة وراء استخدام بعض أنظمة NoSQL في التطبيقات التي تتعامل مع أحجام كبيرة من البيانات أو أعداد ضخمة من الطلبات.
لكن قابلية التوسع تختلف بين الأنظمة، كما أن تحقيقها بكفاءة يعتمد على تصميم قاعدة البيانات وطريقة توزيع البيانات والبنية التحتية المستخدمة.
دعم هياكل البيانات المتنوعة (Support for Diverse Data Structures)
لا تعتمد NoSQL على بنية واحدة لتخزين البيانات، بل توفر نماذج مختلفة تناسب احتياجات متعددة. فقد تعتمد قاعدة البيانات على مستندات، أو أزواج مفتاح-قيمة، أو عائلات أعمدة، أو عقد وروابط تمثل العلاقات بين البيانات.
وتتيح هذه النماذج للمطور اختيار طريقة تخزين أقرب إلى طبيعة التطبيق، بدلا من إجبار جميع البيانات على الالتزام بالبنية الجدولية نفسها.
إدارة التغييرات في بنية البيانات
يمكن أن تكون قواعد بيانات NoSQL مناسبة للأنظمة التي تتغير فيها بنية البيانات بمرور الوقت، خصوصا عندما تكون السجلات الجديدة بحاجة إلى خصائص إضافية لا توجد في السجلات القديمة.
وتختلف طريقة التعامل مع هذه التغييرات من نظام إلى آخر. فقد تعتمد بعض الأنظمة على مرونة المستندات، بينما تستخدم أنظمة أخرى نماذج أكثر تنظيما. لذلك يجب تصميم التطبيق بطريقة تضمن قدرة البيانات القديمة والجديدة على العمل بصورة صحيحة معا.
المرونة في الوصول إلى البيانات
لا تعتمد جميع قواعد بيانات NoSQL على SQL كواجهة الاستعلام الأساسية. فلكل نموذج عادة طريقة أو لغة أو واجهة مناسبة لطبيعة البيانات التي يخزنها.
وعلى الرغم من ذلك، فإن بعض أنظمة NoSQL توفر دعما لـSQL أو لواجهات استعلام شبيهة بها، سواء بشكل أصلي أو من خلال طبقات وأدوات إضافية. لذلك فإن عبارة “NoSQL لا تستخدم SQL” ليست دقيقة كقاعدة عامة، والأصح أن NoSQL تشير إلى نماذج وقواعد بيانات لا تعتمد بالضرورة على النموذج العلائقي التقليدي باعتباره النموذج الأساسي للبيانات.
ما حالات الاستخدام المناسبة لقواعد بيانات NoSQL؟
يمكن أن تكون قواعد بيانات NoSQL مناسبة للتطبيقات التي تتطلب واحدا أو أكثر من الخصائص التالية:
- التعامل مع كميات كبيرة من البيانات.
- مرونة أكبر في بنية البيانات.
- استجابة سريعة في سيناريوهات محددة.
- التوسع الأفقي عبر عدة خوادم أو عقد.
- التعامل مع بيانات شبه مهيكلة.
- تخزين البيانات التي تناسب نماذج المستندات أو المفتاح-القيمة أو الأعمدة العريضة أو الرسم البياني.
- دعم تطبيقات تتغير متطلباتها وبنية بياناتها باستمرار.
لكن اختيار NoSQL لا يعني تلقائيا أنها أفضل من قواعد البيانات العلائقية. فالاختيار الصحيح يعتمد على طبيعة البيانات ونمط الوصول إليها ومتطلبات الاتساق والأداء والتوسع وطبيعة التطبيق.
قواعد بيانات المستندات (Document Databases)

تعد قاعدة بيانات المستندات (Document Databases) أحد أنواع قواعد البيانات NoSQL، حيث يتم تخزينها في صورة مستندات (Documents) بدلا من تنظيمها في جداول وصفوف كما هو الحال في قواعد البيانات العلائقية.
تستخدم هذه المستندات عادة تنسيقات مثل JSON أو BSON أو XML، بحسب نظام قاعدة البيانات المستخدم. ويمكن أن يحتوي المستند الواحد على بيانات متداخلة، مثل القوائم والكائنات والخصائص المختلفة، مما يمنح هذا النموذج مرونة في تمثيل البيانات المرتبطة داخل بنية واحدة.
ولا يشترط في العديد من قواعد بيانات المستندات أن تكون جميع المستندات متطابقة تماما في بنيتها. وهذا يجعلها مناسبة للتطبيقات التي تتغير فيها خصائص البيانات أو التي تتعامل مع سجلات ذات بنية مرنة.
المميزات الرئيسية لقواعد بيانات المستندات
- المرونة (Flexibility): تسمح بتمثيل بيانات متنوعة ومتداخلة داخل المستندات.
- سهولة التطوير: يمكن أن تكون إضافة خصائص جديدة إلى البيانات أكثر مرونة في بعض الأنظمة.
- القابلية للتوسع (Scalability): تدعم بعض أنظمة المستندات التوسع الأفقي وتوزيع البيانات.
- الاستعلام والفهرسة: توفر الأنظمة الحديثة إمكانات متنوعة للاستعلام وإنشاء الفهارس وفقا لطبيعة البيانات.
- تقليل الحاجة إلى الربط: يمكن تخزين البيانات المرتبطة داخل مستند واحد في الحالات التي يناسب فيها ذلك تصميم التطبيق.
أمثلة شائعة
- MongoDB
- Couchbase
- CouchDB
- Amazon DocumentDB
- Firebase Firestore
حالات الاستخدام الشائعة
تستخدم قواعد بيانات المستندات في مجموعة واسعة من التطبيقات، مثل:
- تطبيقات الويب والجوال.
- أنظمة إدارة المحتوى (CMS).
- كتالوجات المنتجات.
- ملفات المستخدمين والملفات الشخصية.
- تطبيقات تتغير فيها خصائص البيانات باستمرار.
- بعض أنظمة التوصيات وتخصيص المحتوى.
وتعد قواعد بيانات المستندات خيارا مناسبا عندما تكون طبيعة البيانات أقرب إلى مستندات مترابطة ومرنة، خصوصا عندما يحتاج التطبيق إلى قراءة مجموعة من البيانات المرتبطة معا في عملية واحدة.
قاعدة البيانات للقيمة الرئيسية (قاعدة بيانات المفتاح والقيمة – Key-Value Database)

قواعد بيانات المفتاح والقيمة (Key-Value Databases) من أبسط أنواع قواعد البيانات NoSQL. وتخزن البيانات في صورة أزواج تتكون من مفتاح (Key) وقيمة (Value)، حيث يستخدم المفتاح للوصول إلى القيمة المرتبطة به.
يمكن أن تكون القيمة عبارة عن نص أو رقم أو بيانات ثنائية أو بنية أكثر تعقيدا، بحسب إمكانات النظام المستخدم. ويتميز هذا النموذج ببساطة طريقة الوصول إلى البيانات، لأن التطبيق يحتاج عادة إلى معرفة المفتاح للوصول إلى القيمة المرتبطة به.
تتميز العديد من قواعد بيانات المفتاح والقيمة بقابلية عالية للتوسع والأداء، ولذلك تستخدم في سيناريوهات تحتاج إلى عمليات قراءة وكتابة سريعة ومتكررة.
ومن الاستخدامات الشائعة لهذا النموذج:
- إدارة جلسات المستخدمين (User Sessions).
- التخزين المؤقت (Caching).
- عربات التسوق الإلكترونية.
- أنظمة الألعاب عبر الإنترنت.
- تخزين الإعدادات والبيانات المؤقتة.
- بعض أنظمة معالجة الطلبات ذات الحجم الكبير.
المميزات الرئيسية لقاعدة بيانات المفتاح والقيمة
سهولة الاستخدام (Simplicity of Use)
تعتمد قاعدة بيانات المفتاح والقيمة على نموذج بسيط للغاية، إذ يتعامل التطبيق بشكل أساسي مع مفتاح وقيمة مرتبطة به. وتقلل هذه البنية من التعقيد عندما يكون نمط الوصول المطلوب هو استرجاع قيمة معينة باستخدام مفتاح معروف.
لكن هذه البساطة تعني أيضا أن هذا النموذج ليس مناسبا بالضرورة للاستعلامات المعقدة التي تتطلب البحث في خصائص متعددة أو تنفيذ علاقات معقدة بين مجموعات كبيرة من البيانات.
السرعة (Speed)
يمكن أن توفر قواعد بيانات المفتاح والقيمة أداء مرتفعا في عمليات القراءة والكتابة المناسبة لطبيعة هذا النموذج، خصوصا عندما يكون الوصول إلى البيانات معتمدا على المفتاح مباشرة.
وتعتمد السرعة الفعلية على النظام المستخدم وحجم البيانات والبنية التحتية وطريقة توزيع البيانات ونمط العمليات التي ينفذها التطبيق.
قابلية التوسع (Scalability)
تدعم العديد من أنظمة المفتاح والقيمة التوسع الأفقي، مما يسمح بتوزيع البيانات وأحمال العمل عبر عدة خوادم أو عقد.
وتعد هذه الخاصية مفيدة في التطبيقات التي تتعامل مع أعداد كبيرة من الطلبات أو تحتاج إلى توزيع البيانات على بنية تحتية واسعة. ومع ذلك، لا يصح القول إن قواعد البيانات العلائقية لا تتوسع أفقيا؛ فبعض الأنظمة العلائقية تدعم أساليب مختلفة للتوسع والتوزيع أيضا، لكن طريقة تحقيق ذلك تختلف حسب النظام.
سهولة التعامل مع البيانات
يسمح النموذج البسيط بإجراء عمليات مباشرة على البيانات باستخدام المفتاح، دون الحاجة إلى بناء علاقات معقدة بين جداول متعددة. وهذا يجعله مناسبا للبيانات التي يكون نمط الوصول إليها معروفا مسبقا.
الموثوقية والتوافر
توفر بعض أنظمة المفتاح والقيمة آليات للتكرار (Replication) وتوزيع البيانات وتحمل الأعطال، مما يمكن أن يساعد على تحسين التوافر واستمرارية الخدمة.
لكن هذه الخصائص ليست متطابقة في جميع الأنظمة، كما أن طريقة تحقيق الموثوقية والاستعادة تختلف حسب قاعدة البيانات وإعداداتها.
أشهر قواعد بيانات المفتاح والقيمة
من أشهر الأنظمة التي تستخدم نموذج المفتاح والقيمة:
- Redis: يستخدم على نطاق واسع في التخزين المؤقت والبيانات التي تحتاج إلى وصول سريع.
- Amazon DynamoDB: قاعدة بيانات سحابية مدارة تدعم نماذج المفتاح والقيمة والمستندات.
- Riak: نظام موزع صمم لتوفير التوسع والتوافر.
- Apache Cassandra: يعتمد أساسا على نموذج Wide-Column، ويمكن التعامل معه في بعض السياقات باعتباره ذا بنية مفتاح-قيمة، لكنه يصنف علميا بصورة أدق ضمن قواعد البيانات ذات الأعمدة العريضة.
قاعدة البيانات ذات الأعمدة العريضة (Wide Column Database)

قواعد البيانات ذات الأعمدة العريضة (Wide-Column Databases) أحد نماذج قواعد بيانات NoSQL، وتعرف ايضا باسم قواعد بيانات عائلة الأعمدة (Column-Family Databases). ويعتمد هذا النموذج على تنظيم البيانات باستخدام مفتاح للصف (Row Key) ومجموعات من الأعمدة التي يمكن تنظيمها ضمن عائلات أعمدة، بدلا من الاعتماد على الجداول العلائقية التقليدية.
ويتميز هذا النموذج بقدرته على التعامل مع كميات ضخمة من البيانات وتوزيعها عبر عدد كبير من الخوادم أو العقد. لذلك يستخدم في الأنظمة التي تحتاج إلى التوسع الأفقي والتعامل مع أحجام كبيرة من عمليات القراءة والكتابة.
ومن أشهر الأمثلة على هذا النوع:
- Apache Cassandra
- Google Cloud Bigtable
- ScyllaDB
- Apache HBase
ومن المهم التفريق بين Wide-Column Databases وColumnar Databases. فالأولى تمثل نموذج بيانات NoSQL يعتمد على عائلات الأعمدة، بينما الثانية تشير إلى طريقة تخزين عمودية تستخدم كثيرا في أنظمة التحليلات ومعالجة البيانات، وقد تكون جزءا من أنظمة مختلفة تماما.
مميزات قواعد البيانات ذات الأعمدة العريضة
قابلية التوسع الأفقي (Horizontal Scalability)
تستطيع العديد من أنظمة الأعمدة العريضة توزيع البيانات على عدة عقد، مما يسمح بإضافة موارد جديدة عند زيادة حجم البيانات أو عدد العمليات.
وتجعل هذه القدرة هذا النموذج مناسبا للأنظمة التي تحتاج إلى العمل على بنية تحتية موزعة بدلا من الاعتماد على خادم واحد.
التعامل مع البيانات الضخمة
صممت العديد من قواعد البيانات ذات الأعمدة العريضة للتعامل مع مجموعات بيانات كبيرة جدا، مع إمكانية توزيع البيانات وعمليات المعالجة عبر مجموعة من الخوادم.
وتختلف الحدود الفعلية للأداء والحجم وفقا للنظام والبنية التحتية وطريقة توزيع البيانات وتصميم التطبيق.
الأداء في عمليات القراءة والكتابة
يمكن أن توفر هذه الأنظمة أداء مرتفعا في أنماط الوصول التي صممت قاعدة البيانات من أجلها، خصوصا عندما يكون مفتاح الصف وطريقة توزيع البيانات متوافقين مع نمط استخدام التطبيق.
ولهذا السبب، يتم عادة تصميم نموذج البيانات في قواعد البيانات ذات الأعمدة العريضة وفقا للاستعلامات وعمليات الوصول المتوقعة، وليس فقط وفقا لشكل البيانات.
التوزيع وتحمل الأعطال
توفر العديد من الأنظمة آليات لتوزيع البيانات والتكرار (Replication) بين العقد، مما يساعد على استمرار الخدمة عند حدوث بعض الأعطال.
وتختلف آليات التكرار والاتساق والتعامل مع الأعطال من نظام إلى آخر، لذلك لا يمكن تعميم مستوى التوافر أو الاتساق على جميع قواعد البيانات ذات الأعمدة العريضة.
حالات استخدام قواعد البيانات ذات الأعمدة العريضة
يمكن استخدام هذا النموذج في العديد من التطبيقات التي تتطلب التوسع والتوزيع، مثل:
- أنظمة تحليل السجلات والأحداث.
- التطبيقات التي تستقبل أعدادا ضخمة من عمليات الكتابة.
- بعض أنظمة إنترنت الأشياء (IoT).
- منصات البيانات واسعة النطاق.
- أنظمة التوصية والتخصيص في بعض السيناريوهات.
- تخزين البيانات التي تحتاج إلى توزيعها على عدد كبير من العقد.
وتعد Apache Cassandra وGoogle Cloud Bigtable من الأمثلة المعروفة على هذا النموذج، مع اختلاف كبير في التصميم والخصائص بين كل نظام وآخر.
قاعدة بيانات الرسم البياني (Graph Database)

قواعد بيانات الرسم البياني (Graph Databases) نوعا من أنواع قواعد البيانات المصممة لتخزين البيانات وتمثيل العلاقات بينها بطريقة مباشرة. ويكون هذا النموذج مناسبا بشكل خاص عندما لا تكون قيمة البيانات في الكيانات نفسها فقط، بل في العلاقات التي تربط هذه الكيانات ببعضها. فبدلا من التعامل مع المعلومات باعتبارها سجلات منفصلة، تمثل قاعدة البيانات الكيانات والعلاقات بينها داخل بنية مترابطة تعرف باسم الرسم البياني (Graph).
تعتمد قواعد بيانات الرسم البياني بصورة أساسية على العقد (Nodes) والعلاقات (Edges أو Relationships) والخصائص (Properties). وتمثل العقد الكيانات التي يحتاج التطبيق إلى تخزينها، مثل الأشخاص والمنتجات والشركات والحسابات، بينما تصف العلاقات كيفية ارتباط هذه الكيانات ببعضها، مثل “صديق لـ” أو “اشترى” أو “يعمل لدى”. أما الخصائص فتستخدم لتخزين المعلومات الإضافية المرتبطة بالعقد أو العلاقات، مثل اسم الشخص أو سعر المنتج أو تاريخ تنفيذ عملية الشراء.
ولتوضيح الفكرة، يمكن في شبكة اجتماعية تمثيل شخص باسم أحمد على أنه عقدة، وشخص آخر باسم محمد على أنه عقدة ثانية، ثم إنشاء علاقة بينهما توضح أن أحمد صديق لمحمد. ويمكن بعد ذلك إضافة علاقات أخرى تربط محمد بأشخاص أو شركات أو منتجات مختلفة. وبهذه الطريقة تتكون شبكة مترابطة من البيانات يستطيع النظام استكشافها للوصول إلى العلاقات والمسارات والروابط التي يحتاج إليها التطبيق.
وتختلف قواعد بيانات الرسم البياني عن قواعد البيانات العلائقية في طريقة تمثيل العلاقات. ففي النموذج العلائقي، تخزن البيانات عادة داخل جداول، ويتم الوصول إلى البيانات المرتبطة باستخدام المفاتيح وعمليات الاستعلام التي قد تتضمن JOIN. أما في قاعدة بيانات الرسم البياني، فتكون العلاقة نفسها جزءا أساسيا من نموذج البيانات، ولذلك يكون التعامل مع البيانات شديدة الترابط أكثر طبيعية في العديد من السيناريوهات.
مميزات قواعد بيانات الرسم البياني
تتميز قواعد بيانات الرسم البياني بمجموعة من الخصائص التي تجعلها مناسبة للتطبيقات التي تعتمد على العلاقات المعقدة والمترابطة. وتظهر أهميتها عندما يحتاج النظام إلى الانتقال بين الكيانات واكتشاف الروابط بينها، بدلا من تنفيذ عمليات بحث تعتمد فقط على خصائص كل سجل بصورة منفصلة.
تمثيل العلاقات بصورة مباشرة
من أهم مميزات هذا النموذج أن العلاقات بين البيانات تكون جزءا أساسيا من بنية قاعدة البيانات. ويمكن للنظام تمثيل العلاقة نفسها مع نوعها وخصائصها، مما يجعل البيانات المترابطة أسهل في النمذجة عندما تكون العلاقات ذات أهمية كبيرة بالنسبة للتطبيق.
كفاءة استكشاف العلاقات
توفر قواعد بيانات الرسم البياني آليات لتنفيذ عمليات اجتياز الرسم البياني (Graph Traversal)، حيث يستطيع الاستعلام الانتقال من عقدة إلى أخرى عبر العلاقات للوصول إلى البيانات المرتبطة بها. ويكون ذلك مفيدا في تطبيقات تحتاج إلى اكتشاف الأشخاص المرتبطين بشخص معين، أو معرفة المسارات بين كيانين، أو تحليل شبكة من العلاقات. ومع ذلك، لا يعني استخدام Graph Database أن الأداء سيكون مرتفعا دائما، لأن الكفاءة تعتمد على حجم البيانات وتصميم الرسم البياني وطبيعة الاستعلام ونظام قاعدة البيانات المستخدم.
مناسبة للبيانات شديدة الترابط
تظهر قوة قواعد بيانات الرسم البياني عندما تكون البيانات عبارة عن شبكة من العلاقات، مثل شبكات التواصل الاجتماعي وأنظمة التوصية واكتشاف الاحتيال وإدارة المعرفة. ففي هذه التطبيقات قد تكون معرفة العلاقة بين الكيانات أهم من معرفة خصائص كل كيان منفردا.
المرونة في تمثيل العلاقات والخصائص
توفر بعض قواعد بيانات الرسم البياني مرونة في إضافة خصائص أو أنواع جديدة من العلاقات مع تطور التطبيق. ومع ذلك، لا يعني ذلك أن جميع هذه الأنظمة تعمل دون مخطط، إذ توفر بعض الأنظمة قيودا ومخططات (Schemas and Constraints) لتنظيم البيانات والحفاظ على صحتها واتساقها.
دعم الاستعلامات المعتمدة على المسارات
يمكن استخدام قواعد بيانات الرسم البياني في الحالات التي يحتاج فيها التطبيق إلى البحث عن مسارات أو سلاسل من العلاقات بين عدة كيانات. وهذا مفيد، على سبيل المثال، عند تحليل شبكة من المستخدمين أو اكتشاف الروابط غير المباشرة بين الحسابات والمعاملات في أنظمة مكافحة الاحتيال.
ومن أشهر الأنظمة التي تعتمد على هذا النموذج Neo4j وAmazon Neptune وJanusGraph وTigerGraph، مع اختلاف خصائص كل نظام في التخزين والاستعلام والتوسع وطريقة إدارة البيانات.
وبذلك فإن قواعد بيانات الرسم البياني ليست مجرد بديل لقواعد البيانات العلائقية، بل هي نموذج متخصص تكون قيمته الحقيقية عندما تمثل العلاقات بين البيانات جزءا مهما من المشكلة التي يحاول التطبيق حلها. أما إذا كانت البيانات منظمة في جداول واضحة وتحتاج أساسا إلى معاملات علائقية تقليدية، فقد يكون النموذج العلائقي أكثر ملاءمة.
3. قاعدة البيانات الكائنية التوجه (Object-Oriented Database)

قواعد البيانات الكائنية التوجه (Object-Oriented Databases) نوعا من أنواع قواعد البيانات التي تم تصميمها لتخزين البيانات على هيئة كائنات (Objects)، بحيث يمكن للكائن أن يجمع بين البيانات والخصائص المرتبطة بها، وأن يمثل العلاقات والسلوكيات المرتبطة بالكيان الذي يمثله. وتدار هذه القواعد بواسطة أنظمة إدارة قواعد البيانات الكائنية التوجه (OODBMS).
يرتبط هذا النموذج ارتباطا وثيقا بمفهوم البرمجة كائنية التوجه (Object-Oriented Programming)، ولذلك يمكن أن يكون مناسبا للتطبيقات التي تتعامل مع كائنات معقدة وهياكل بيانات مترابطة. وتدعم هذه القواعد مفاهيم مثل التغليف (Encapsulation) والوراثة (Inheritance) وتعدد الأشكال (Polymorphism)، بحسب النظام المستخدم، مما يسمح بتمثيل بعض النماذج البرمجية المعقدة داخل قاعدة البيانات بصورة أقرب إلى طريقة تمثيلها داخل التطبيق.
وتتكامل قواعد البيانات الكائنية التوجه بصورة طبيعية مع لغات البرمجة الكائنية مثل Java وC++، إذ يمكن للتطبيق التعامل مع البيانات باعتبارها كائنات بدلا من تحويلها باستمرار بين الكائنات البرمجية والجداول العلائقية. وتدعم بعض أنظمة قواعد البيانات الكائنية المعاملات وخصائص الاتساق والموثوقية، وقد تطبق مبادئ ACID، لكن لا يصح افتراض أن كل نظام كائني يطبقها بالطريقة نفسها.
ومن أمثلة الأنظمة المرتبطة بهذا النموذج ObjectStore، بينما توجد منتجات ومنصات أخرى تجمع بين الخصائص الكائنية ونماذج قواعد بيانات مختلفة. لذلك يجب التمييز بين قواعد البيانات الكائنية التقليدية وبين الأنظمة الحديثة متعددة النماذج التي قد تدعم أكثر من نموذج لتخزين البيانات.
مميزات قواعد البيانات الكائنية التوجه
تتميز قواعد البيانات الكائنية التوجه بقدرتها على تمثيل البيانات المعقدة والعلاقات المتداخلة بصورة قريبة من طريقة بناء التطبيقات الكائنية. فعندما يتكون التطبيق من كائنات مترابطة ومعقدة، يمكن لهذا النموذج تقليل الحاجة إلى تحويل هذه الكائنات إلى جداول متعددة ثم إعادة بنائها عند قراءتها.
إمكانية بناء نماذج بيانات غنية
يسمح النموذج الكائني بتمثيل الكيانات المعقدة باعتبارها كائنات يمكن أن تحتوي على خصائص وعلاقات متعددة. ويمكن للكائن أن يرتبط بكائنات أخرى، بما في ذلك العلاقات التي يصعب تمثيلها بصورة مباشرة عندما تكون البيانات شديدة التعقيد.
إعادة استخدام الهياكل من خلال الوراثة
تدعم بعض قواعد البيانات الكائنية مفهوم الوراثة (Inheritance)، مما يسمح بإنشاء أنواع جديدة اعتمادا على أنواع موجودة ومشاركة الخصائص والسلوكيات بينها. ويمكن أن يساعد ذلك على تقليل التكرار وتسهيل تطوير التطبيقات التي تحتوي على نماذج كائنية معقدة.
التعامل مع أنواع بيانات معقدة
يمكن لهذا النموذج التعامل بصورة طبيعية مع هياكل بيانات معقدة، مثل الكائنات المتداخلة والبيانات الهندسية وبعض أنواع الوسائط والبيانات متعددة الأبعاد، وفقا لقدرات النظام المستخدم. ومع ذلك، فإن تخزين الصور والفيديو والصوت داخل قاعدة البيانات ليس ميزة حصرية لقواعد البيانات الكائنية، إذ تستطيع نماذج أخرى التعامل مع هذه البيانات أيضا بطرق مختلفة.
التكامل مع التطبيقات الكائنية
من أهم مزايا هذا النموذج أنه يقلل ما يعرف باسم عدم التطابق بين الكائنات والعلاقات (Object-Relational Impedance Mismatch) في التطبيقات التي تعتمد على البرمجة كائنية التوجه. ففي قاعدة البيانات العلائقية، يحتاج المطور عادة إلى تحويل الكائنات البرمجية إلى جداول وصفوف والعكس، بينما يسمح النموذج الكائني بتخزين البيانات بطريقة أقرب إلى تمثيلها داخل البرنامج.
إمكانية الوصول إلى الكائنات المرتبطة
تعتمد بعض الأنظمة الكائنية على أسلوب وصول تنقلي (Navigational Access)، حيث يمكن الانتقال من كائن إلى آخر عبر العلاقات المخزنة بينهما. ويمكن أن يكون هذا الأسلوب مناسبا للتطبيقات التي تتعامل مع هياكل مترابطة ومعقدة، إلا أنه لا يعني أن الوصول التنقلي أفضل من SQL في جميع أنواع الاستعلامات.
الأداء في التطبيقات المتخصصة
يمكن أن تقدم قواعد البيانات الكائنية أداء جيدا في تطبيقات معينة، خصوصا عندما تتعامل مع كائنات معقدة وعلاقات مترابطة بصورة متكررة. لكن لا يصح القول بصورة عامة إنها أسرع من قواعد البيانات العلائقية، لأن الأداء يعتمد على نوع التطبيق وحجم البيانات ونمط الاستعلام وتصميم النظام والبنية التحتية.
وتستخدم قواعد البيانات الكائنية التوجه بصورة خاصة في بعض التطبيقات التي تتعامل مع نماذج بيانات معقدة، مثل التصميم بمساعدة الحاسوب (CAD) والتصنيع بمساعدة الحاسوب (CAM) وبعض تطبيقات الأنظمة الجغرافية (GIS) والتطبيقات العلمية والهندسية، إضافة إلى بعض الأنظمة التي تحتاج إلى تمثيل كائنات معقدة ومترابطة.
4. قاعدة البيانات الهرمية (Hierarchical Database)

قواعد البيانات الهرمية (Hierarchical Databases) من أقدم أنواع قواعد البيانات، وتعتمد على تنظيم البيانات في صورة هيكل شجري (Tree Structure) يتكون من مستويات مترابطة. وتستخدم هذه البنية مفهوم الأصل والفرع (Parent-Child)، حيث يمكن للسجل الأصل أن يرتبط بعدد من السجلات الفرعية ضمن مستويات متتابعة.
ويمكن تصور قاعدة البيانات الهرمية على شكل شجرة تبدأ من عقدة أو سجل رئيسي، ثم تتفرع منه سجلات أخرى، وقد تتفرع هذه السجلات بدورها إلى مستويات إضافية. ولذلك يكون النموذج مناسبا للبيانات التي تمتلك علاقات هرمية واضحة وثابتة، مثل بعض الهياكل التنظيمية وبيانات التصنيفات وأنظمة الملفات.
ومن الخصائص الأساسية لهذا النموذج أن العلاقة التقليدية بين الأصل والفرع تكون من نوع واحد إلى كثير (One-to-Many)، بحيث يمكن للسجل الأصل أن يمتلك عدة سجلات فرعية، بينما يرتبط السجل الفرعي في النموذج الهرمي التقليدي بسجل أصل واحد ضمن المسار الهرمي. وهذا يجعل النموذج بسيطا وسريعا في الحالات التي تتوافق فيها طبيعة البيانات مع هذا الهيكل، لكنه يصبح أقل مرونة عندما تحتاج البيانات إلى علاقات متعددة ومعقدة.
ظهر نموذج قواعد البيانات الهرمية في بدايات تاريخ أنظمة إدارة قواعد البيانات، ومن أشهر تطبيقاته التاريخية IBM Information Management System (IMS) الذي طورته IBM في الستينيات، ولا يزال يستخدم في بعض البيئات المؤسسية القديمة.
مميزات قواعد البيانات الهرمية:
- الأداء العالي (High Performance): بسبب البنية البسيطة والعلاقات المحددة مسبقًا بين المستويات
- السرعة في الاسترجاع (Fast Retrieval): الوصول إلى البيانات عبر مسار هرمي محدد يكون سريعًا جدًا
- الكفاءة في التخزين (Storage Efficiency): التخزين الهرمي يقلل من التكرار في البيانات
- المثالية للبيانات ذات البنية الهرمية الطبيعية (Ideal for Naturally Hierarchical Data): مناسبة للبيانات التي تمتلك علاقات هرمية طبيعية مثل الهياكل التنظيمية أو أنظمة الملفات
عيوب قواعد البيانات الهرمية:
- قلة المرونة (Lack of Flexibility): صعوبة في تمثيل العلاقات المعقدة بين البيانات
- التعقيد في التعديل (Modification Complexity): أي تغيير في الهيكل يتطلب إعادة تنظيم كبيرة
- اعتمادية قوية (Strong Dependence): السجلات الفرعية تعتمد كليًا على السجلات الأصلية
ثانيا: أنواع قواعد البيانات حسب طريقة تخزين البيانات ومعالجتها
بعد التعرف على أنواع قواعد البيانات وفقا لنموذج البيانات، يمكن تصنيف بعض قواعد البيانات وفقا لطريقة تخزين المعلومات ومعالجتها ونمط الاستخدام الذي صممت من أجله. ويختلف هذا التصنيف عن تصنيف قواعد البيانات العلائقية وNoSQL، لأن قاعدة البيانات الواحدة قد تجمع بين أكثر من خاصية في الوقت نفسه. فقد تكون قاعدة البيانات علائقية، وفي الوقت نفسه تستخدم تخزينا عموديا أو تعمل داخل الذاكرة أو تكون مخصصة لمعالجة المعاملات.
ويظهر هذا التنوع بوضوح في التطبيقات الحديثة التي تعتمد على الحوسبة السحابية (Cloud Computing) والتحول الرقمي (Digital Transformation)، حيث أصبحت المؤسسات تتعامل مع بيانات تشغيلية وتحليلية وزمنية ضخمة، بينما تحتاج تطبيقات الويب وعمليات تصميم المواقع إلى قواعد بيانات قادرة على الاستجابة السريعة للطلبات وإدارة بيانات المستخدمين والمحتوى والمعاملات.
5. قاعدة البيانات العمودية (Columnar Database)

تعتمد قواعد البيانات العمودية (Columnar Databases) على تخزين البيانات حسب الأعمدة بدلا من تخزين الصفوف كاملة كما يحدث عادة في قواعد البيانات ذات التخزين الصفّي (Row-Oriented Storage). فعلى سبيل المثال، إذا كان لدينا جدول يحتوي على أسماء العملاء وعناوينهم وأرصدة حساباتهم، فإن النظام العمودي يستطيع تخزين قيم الأسماء في بنية تخزين، والعناوين في بنية أخرى، والأرصدة في بنية ثالثة.
وتظهر أهمية هذا الأسلوب عندما تكون الاستعلامات بحاجة إلى قراءة عدد محدود من الأعمدة من مجموعة كبيرة من السجلات. فإذا أراد محلل البيانات حساب إجمالي الأرصدة لجميع العملاء، فلن يحتاج النظام إلى قراءة أسماء العملاء وعناوينهم والحقول الأخرى غير المرتبطة بالاستعلام. ونتيجة لذلك يمكن تقليل عمليات القراءة ونقل البيانات من التخزين، خصوصا عند التعامل مع مجموعات بيانات كبيرة.
وتستخدم قواعد البيانات العمودية بصورة واسعة في مستودعات البيانات (Data Warehouses) ومنصات التحليلات وعمليات OLAP (Online Analytical Processing)، حيث تكون الاستعلامات غالبا موجهة إلى تحليل كميات ضخمة من البيانات وإجراء عمليات التجميع مثل SUM وCOUNT وAVG. كما يساعد تجانس القيم الموجودة في العمود الواحد على تحقيق معدلات ضغط جيدة في العديد من أنظمة التخزين العمودي، مما قد يقلل مساحة التخزين ويحسن كفاءة القراءة.
ومن المهم عدم الخلط بين Columnar Databases وWide-Column Databases التي تحدثنا عنها سابقا. فقاعدة البيانات ذات الأعمدة العريضة هي نموذج من نماذج NoSQL، بينما التخزين العمودي يشير إلى طريقة تنظيم البيانات على مستوى التخزين، ويمكن استخدامه في أنظمة وقواعد بيانات مخصصة للتحليلات.
ومن أشهر التقنيات التي تستخدم التخزين العمودي Amazon Redshift وGoogle BigQuery وClickHouse، وتستخدم هذه الأنظمة في تحليل البيانات الضخمة وذكاء الأعمال والتقارير والمؤشرات التشغيلية، كما أصبحت جزءا مهما من البنية الحديثة للبيانات في المؤسسات التي تعتمد على الحوسبة السحابية.
مميزات قواعد البيانات العمودية (Columnar Database Advantages)
تكيف مع أحمال العمل OLAP (OLAP Workload Adaptation): مناسبة بشكل خاص لعمليات المعالجة التحليلية عبر الإنترنت (Online Analytical Processing).
- ضغط بيانات فعال (Efficient Data Compression): بسبب تجانس البيانات في كل عمود، يمكن تحقيق معدلات ضغط عالية.
- أداء استعلام تحليلي سريع (Fast Analytical Query Performance): مثالية لأحمال العمل التي تتطلب عمليات تجميع واستعلامات معقدة على مجموعات بيانات كبيرة.
- تقليل I/O للقراءة (Reduced Read I/O): يتم قراءة الأعمدة ذات الصلة فقط للاستعلام، مما يقلل من نقل البيانات.
- دعم ممتاز للتجميع (Excellent Aggregation Support): مصممة خصيصًا للعمليات الحسابية على الأعمدة مثل SUM و COUNT و AVG.
آلية العمل
في النظام العمودي، يتم تخزين كل عمود بشكل منفصل ومضغوط، مما يؤدي إلى:
- تحسين كبير في أداء الاستعلامات التحليلية
- توفير مساحة تخزين أكبر بفضل تقنيات الضغط المتقدمة
- سرعة في معالجة البيانات الكبيرة
- كفاءة أعلى في عمليات التجميع والحساب
ما هي الفائدة الرئيسية لقواعد البيانات العمودية؟
بفضل تخزين البيانات حسب الأعمدة، يتم تنفيذ العديد من الاستعلامات بسرعة أكبر، حيث تتيح قواعد البيانات العمودية تخطي بعض الحقول بدلاً من البحث سطرًا بسطر، وفحص فقط البيانات الأكثر صلة. على سبيل المثال، إذا كان من الضروري البحث عن الرصيد المدفوع لجميع الموردين، فيمكن الرجوع مباشرة إلى سجل “الرصيد” وتجاهل سجلات الفواتير والعناوين والبيانات غير ذات الصلة الأخرى.
وبهذه الطريقة، يتم منع انخفاض السرعة. تمتلك معظم المنظمات مصادر بيانات (Data Sources) كثيرة جدًا. وبالتالي، مع نمو حجم البيانات المتزايد، تبرز أهمية قواعد البيانات العمودية أكثر من أي وقت مضى للحفاظ على السرعة والمرونة في تحليل الأعمال.
لخبراء تطوير التكنولوجيا والبرمجيات مثل دينيس فوربس، فإن الميزة الأكبر لاستخدام قواعد البيانات العمودية هي قدراتها في ضغط مجموعات البيانات الكبيرة (Data Compression Capabilities).
أمثلة وتطبيقات
من أشهر أنواع قواعد البيانات العمودية نجد Apache Cassandra وAmazon Redshift وGoogle BigQuery. تُستخدم هذه الأنظمة بشكل واسع في:
- تحليل البيانات الضخمة (Big Data Analytics)
- أنظمة Business Intelligence
- التقارير المالية والإحصائية
- معالجة بيانات IoT (إنترنت الأشياء)
6. قواعد البيانات داخل الذاكرة (In-Memory Databases)
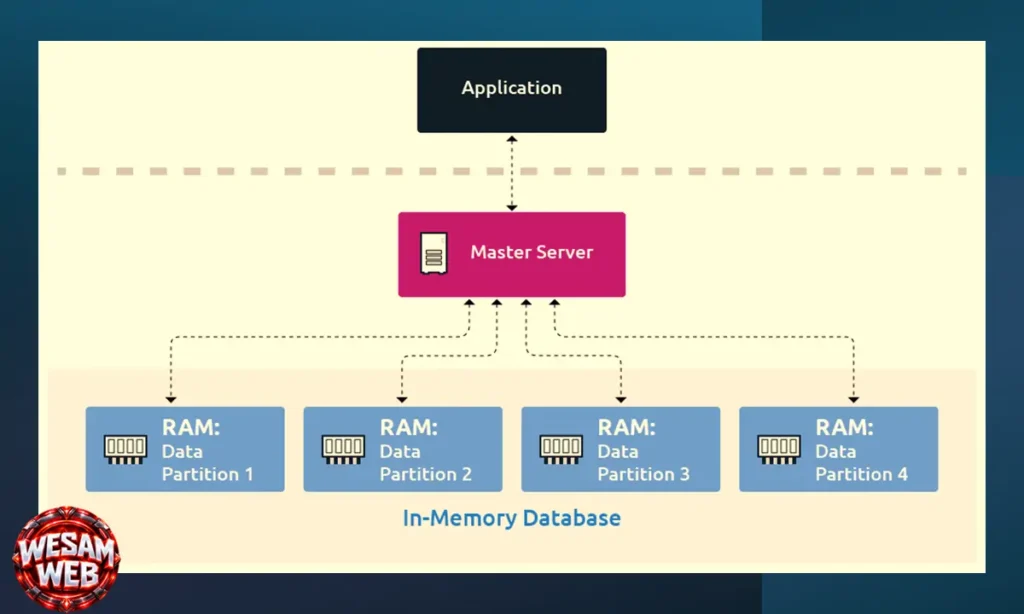
تعتمد قواعد البيانات داخل الذاكرة (In-Memory Databases) على الاحتفاظ بالبيانات التي تحتاج إلى وصول سريع في ذاكرة الوصول العشوائي (RAM) بدلا من الاعتماد على وحدات التخزين التقليدية باعتبارها الموقع الأساسي لكل عملية قراءة وكتابة. وتتميز ذاكرة RAM بزمن وصول أقل بكثير من وحدات التخزين، ولذلك يمكن لهذا الأسلوب تقليل زمن الوصول إلى البيانات في التطبيقات التي تحتاج إلى استجابة سريعة.
وتستخدم قواعد البيانات داخل الذاكرة في الحالات التي يكون فيها الأداء وزمن الاستجابة (Latency) عاملين أساسيين. ومن أمثلتها التخزين المؤقت، وإدارة جلسات المستخدمين، وتحليل البيانات في الوقت الفعلي، وبعض الأنظمة المالية والألعاب والتطبيقات التي تتعامل مع عدد كبير من الطلبات في وقت قصير.
ومن أشهر التقنيات المرتبطة بهذا المجال Redis وSAP HANA، مع اختلاف طبيعة كل نظام واستخداماته. كما يمكن لبعض أنظمة قواعد البيانات التقليدية توفير أوضاع تشغيل تعتمد على الذاكرة أو استخدام طبقات تخزين مؤقتة داخل الذاكرة، لذلك لا يعني وجود بيانات في RAM تلقائيا أن النظام قاعدة بيانات In-Memory متخصصة.
وتحتاج قواعد البيانات داخل الذاكرة إلى التعامل بعناية مع استمرارية البيانات (Durability)، لأن الذاكرة المتطايرة يمكن أن تفقد محتواها عند انقطاع الطاقة أو حدوث عطل. ولهذا توفر الأنظمة المختلفة آليات مثل حفظ البيانات على التخزين الدائم، أو النسخ المتماثل، أو سجلات العمليات، بحسب تصميم النظام.
وتكتسب هذه القواعد أهمية متزايدة في تطبيقات التحول الرقمي والخدمات السحابية التي تحتاج إلى تقديم استجابات سريعة للمستخدمين. كما يمكن استخدامها خلف مواقع الويب والتطبيقات لتسريع عمليات متكررة مثل الجلسات والتخزين المؤقت وقراءة البيانات التي يكثر الوصول إليها.
المميزات
- سرعة وصول فائقة: تقرأ وتكتب في RAM مباشرة، بزمن وصول أقل بكثير من وحدات التخزين التقليدية
- زمن استجابة منخفض (Low Latency): مثالية للتطبيقات التي تحتاج رداً فورياً
- تعامل مع الطلبات الكثيرة: تخدم عدداً كبيراً من الطلبات في وقت قصير دون تأخير ملحوظ
- تقليل عنق الزجاجة: تخفف الضغط عن قواعد البيانات التقليدية عند استخدامها كطبقة تخزين مؤقت
- دعم التحليل الفوري: تتعامل مع البيانات في الوقت الفعلي بدلاً من المعالجة المتأخرة
آلية العمل
- التخزين الأساسي في RAM: تُحفظ البيانات التي تحتاج وصولاً سريعاً في ذاكرة الوصول العشوائي بدلاً من الاعتماد على وحدات التخزين التقليدية
- القراءة والكتابة من الذاكرة: تتم معظم عمليات القراءة والكتابة مباشرة في الذاكرة، لا من القرص
- آليات الاستمرارية (Durability): لأن RAM متطايرة وقد تفقد محتواها عند انقطاع الطاقة، توفر الأنظمة آليات مثل:
- حفظ البيانات على التخزين الدائم
- النسخ المتماثل (Replication)
- سجلات العمليات (Write-Ahead Logs)
- أوضاع تشغيل مرنة: بعض أنظمة قواعد البيانات التقليدية توفر أوضاع تشغيل تعتمد على الذاكرة أو طبقات تخزين مؤقتة داخل الذاكرة، لذلك لا يعني وجود بيانات في RAM تلقائياً أن النظام قاعدة بيانات In-Memory متخصصة
أين تُستخدم؟
- التخزين المؤقت (Caching)
- إدارة جلسات المستخدمين
- تحليل البيانات في الوقت الفعلي
- الأنظمة المالية وبعض الألعاب
- التطبيقات ذات الطلبات الكثيرة في وقت قصير
- الواجهة الخلفية لمواقع الويب والتطبيقات لتسريع العمليات المتكررة مثل الجلسات والتخزين المؤقت وقراءة البيانات كثيرة الوصول
أشهر التقنيات
- Redis
- SAP HANA
مع اختلاف طبيعة كل نظام واستخداماته.
لماذا تكتسب أهمية متزايدة؟
تكتسب هذه القواعد أهمية متزايدة في تطبيقات التحول الرقمي والخدمات السحابية التي تحتاج إلى تقديم استجابات سريعة للمستخدمين. فكلما زاد عدد المستخدمين وتضاعفت الطلبات، أصبح زمن الاستجابة عاملاً حاسماً في تجربة الاستخدام.
7. قاعدة البيانات الزمنية (Time Series Database)

قاعدة البيانات الزمنية (Time Series Database) تعد من أهم أنواع قواعد البيانات المتخصصة، حيث تم تصميمها للتعامل مع البيانات المرتبطة بختم زمني (Time Stamped) أو ما يُعرف بالسلاسل الزمنية. هذا النوع من البيانات يتميز بأنه يتغير باستمرار مع مرور الوقت ويسجَل وفق تسلسل زمني محدد، مما يجعل إدارة هذه البيانات وتحليلها أمرًا بالغ الأهمية في الكثير من التطبيقات الحديثة.
تتضمن أمثلة البيانات الزمنية كلًّا من بيانات الشبكات، وقراءات أجهزة الاستشعار (Sensors)، بالإضافة إلى بيانات مراقبة أداء التطبيقات والأنظمة التقنية. ولأن هذه البيانات غالبًا ما تُجمع بشكل لحظي أو دوري، فإن قواعد البيانات الزمنية توفر إمكانيات متقدمة للتخزين السريع، والاستعلام الفوري، والتحليل العميق.
من أبرز الأمثلة على هذا النوع من قواعد البيانات: InfluxDB و Druid و eXtremeDB، والتي تُستخدم على نطاق واسع في تحليل البيانات المتدفقة والتعامل مع كميات هائلة من السلاسل الزمنية. وتجدر الإشارة إلى أنّ جميع أجهزة الاستشعار المرتبطة بإنترنت الأشياء (IoT) تولّد بشكل مستمر تدفقات ضخمة من البيانات الزمنية، مما يجعل هذا النوع من قواعد البيانات ركيزة أساسية في تشغيل وإدارة البنى التحتية الذكية، سواء في المجالات الصناعية أو الصحية أو حتى في المدن الذكية.
خصائص البيانات الزمنية
البيانات الزمنية تتميز بـ:
- ربط كل نقطة بيانات بطابع زمني
- وصول البيانات بشكل تسلسلي زمني
- حجم كبير من البيانات المتدفقة
- نمط استعلام يركز على النطاقات الزمنية
- الحاجة إلى ضغط فعال للبيانات
التطبيقات الحيوية
قواعد بيانات السلاسل الزمنية تُستخدم في:
- مراقبة الأداء والبنية التحتية
- تحليل بيانات IoT وأجهزة الاستشعار
- مراقبة الأسواق المالية
- تتبع المقاييس التشغيلية
- أنظمة المراقبة الطبية
- تحليل سلوك المستخدمين
الأنظمة المتخصصة
من أشهر قواعد البيانات الزمنية:
- InfluxDB: رائد في هذا المجال
- TimescaleDB: امتداد لـ PostgreSQL
- OpenTSDB: مبني على Apache HBase
- Prometheus: متخصص في مراقبة الأنظمة
تحسينات الأداء
هذه القواعد تستخدم تحسينات خاصة مثل:
- فهرسة زمنية متقدمة
- تقنيات ضغط متخصصة
- تجميع البيانات التلقائي
- إدارة دورة حياة البيانات
8. قواعد البيانات المعاملاتية (Transactional Databases)
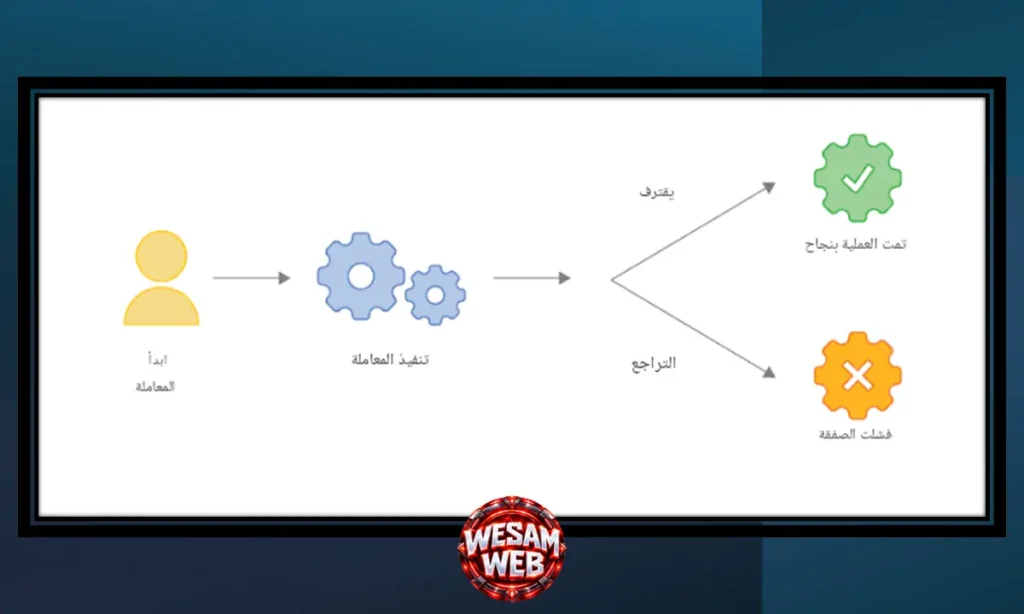
قواعد البيانات المعاملاتية هي الأنظمة المصممة للتعامل مع العمليات التي يجب تنفيذها بصورة موثوقة ومتسقة. مثل تسجيل عمليات الشراء وتحويل الأموال وتحديث المخزون. وتكون المعاملة (Transaction) مجموعة من العمليات التي يجب أن تحقق قواعد محددة قبل اعتبارها ناجحة.
وترتبط هذه القواعد ارتباطاً وثيقاً بمفهوم ACID: الذرية والاتساق والعزل والمتانة. وتساعد هذه الخصائص على ضمان عدم ترك البيانات في حالة غير صحيحة عند فشل إحدى الخطوات. كما تساعد على التعامل مع العمليات المتزامنة.
فعلى سبيل المثال، عند شراء منتج من متجر إلكتروني، قد تحتاج العملية إلى تسجيل الطلب وتحديث المخزون وتسجيل الدفع. وإذا فشلت خطوة حرجة، يضمن النظام عدم تسجيل بعض الخطوات وترك الأخرى بشكل يؤدي إلى حالة غير صحيحة.
وتستخدم هذه القواعد على نطاق واسع في الأنظمة المصرفية والتجارة الإلكترونية وإدارة المخزون والحجوزات. كما تمثل جزءاً أساسياً من البنية الخلفية لمواقع الويب والتطبيقات الحديثة.
ومن المهم الانتباه إلى أن Transactional Database ليست نموذجاً مستقلاً مثل Relational أو Document. بل هي وصف لطبيعة العمل الذي تركز عليه قاعدة البيانات. ولذلك يمكن أن تكون القاعدة العلائقية نظاماً معاملاتياً، كما يمكن لبعض الأنظمة غير العلائقية دعم المعاملات بدرجات مختلفة.
وتزداد أهميتها في عصر التحول الرقمي والحوسبة السحابية. ومع ذلك، فإن اختيارها لا يعتمد على حجم البيانات وحده، بل على طبيعة العمليات ومتطلبات الاتساق والموثوقية.
المميزات
- موثوقية عالية: تنفذ العمليات الحرجة دون ترك البيانات في حالة غير صحيحة
- اتساق صارم: تضمن بقاء البيانات متوافقة مع القواعد المحددة قبل وبعد كل معاملة
- دعم كامل لخصائص ACID: الذرية والاتساق والعزل والمتانة
- تعامل آمن مع التزامن: تدير العمليات المتزامنة وفق مستوى العزل وآليات النظام
- استرجاع بعد الفشل: إذا فشلت خطوة حرجة، لا تُسجل بعض الخطوات وتُترك الأخرى بشكل يفسد البيانات
آلية العمل
- المعاملة (Transaction): مجموعة من العمليات يجب أن تحقق قواعد محددة قبل اعتبارها ناجحة
- الذرية (Atomicity): العملية إما تنجح كاملة أو تفشل كاملة، لا منتصف
- الاتساق (Consistency): البيانات تبقى متوافقة مع القواعد المحددة
- العزل (Isolation): العمليات المتزامنة لا تتداخل مع بعضها وفق مستوى العزل المحدد
- المتانة (Durability): بعد نجاح العملية، تبقى البيانات محفوظة حتى مع الأعطال
- مثال عملي: عند شراء منتج من متجر إلكتروني، قد تحتاج العملية إلى تسجيل الطلب وتحديث المخزون وتسجيل الدفع. إذا فشلت خطوة حرجة، يضمن النظام عدم تسجيل بعض الخطوات وترك الأخرى بشكل يؤدي إلى حالة غير صحيحة
أين تستخدم؟
- الأنظمة المصرفية وتحويل الأموال
- التجارة الإلكترونية وتسجيل عمليات الشراء
- أنظمة إدارة المخزون
- أنظمة الحجوزات
- تطبيقات الأعمال التي تتعامل مع حسابات المستخدمين والطلبات والمدفوعات والمحتوى الديناميكي
ملاحظة مهمة: ليست نموذجاً مستقلاً
Transactional Database ليست نموذجاً مستقلاً للبيانات مثل Relational أو Document بالضرورة. إنها وصف لطبيعة العمل الذي تركز عليه قاعدة البيانات ومتطلبات المعاملات والاتساق. لذلك:
- يمكن أن تكون قاعدة البيانات العلائقية نظاماً معاملاتياً
- يمكن لبعض الأنظمة غير العلائقية أن توفر دعماً للمعاملات بدرجات مختلفة
لماذا تزداد أهميتها؟
تزداد أهمية قواعد البيانات المعاملاتية في عصر التحول الرقمي والحوسبة السحابية، لأن المؤسسات تعتمد على التطبيقات الرقمية لتنفيذ عمليات مالية وتشغيلية بصورة مستمرة.
ومع ذلك، فإن اختيارها لا يعتمد على حجم البيانات وحده، بل على:
- طبيعة العمليات
- متطلبات الاتساق والموثوقية
- طريقة وصول التطبيقات إلى البيانات
ثالثا: أنواع قواعد البيانات حسب البنية والتوزيع
يصف هذا التصنيف كيفية توزيع البيانات ومكونات قاعدة البيانات بين الخوادم والمواقع المختلفة. فقد تكون البيانات وإدارتها متمركزة في نظام واحد، أو موزعة على عدة خوادم وعقد ومراكز بيانات. ويؤثر هذا التصميم في طريقة الوصول إلى البيانات، والتوسع، والتوافر، والتعامل مع الأعطال.
9. قاعدة البيانات المركزية (Centralized Database)

قاعدة البيانات المركزية (Centralized Database) هي قاعدة بيانات تكون بياناتها وإدارتها الأساسية متمركزة في نظام واحد أو موقع مركزي. وقد يكون هذا النظام خادما واحدا، أو بنية مركزية تضم عدة مكونات تعمل معا. ويتصل المستخدمون والتطبيقات بقاعدة البيانات عبر شبكة محلية أو الإنترنت وفقا لطبيعة النظام.
يسهل هذا النموذج إدارة البيانات والتحكم فيها، لأن الإدارة والصلاحيات والنسخ الاحتياطي والصيانة تتم من خلال بنية مركزية. كما يمكن أن يساعد وجود مصدر مركزي للبيانات على تقليل الاختلاف بين نسخ المعلومات، خصوصا عندما لا تكون هناك حاجة إلى توزيع البيانات على مواقع متعددة.
وتناسب قواعد البيانات المركزية العديد من التطبيقات التي لا تتطلب بنية موزعة على نطاق واسع. ويمكن استخدامها في بعض المؤسسات والأنظمة الإدارية والتعليمية والتطبيقات الداخلية، كما يمكن أن تكون مناسبة لبعض مواقع الويب والتطبيقات التي تدار بنيتها من مركز بيانات واحد.
ومع ذلك، فإن الاعتماد على بنية مركزية قد يزيد من تأثير بعض الأعطال. فإذا كانت قاعدة البيانات تعتمد على خادم أو مكون مركزي دون وجود آليات مناسبة للتكرار والتعافي، فقد يؤدي تعطله إلى توقف الخدمة أو التأثير في جزء كبير منها. كما قد تصبح البنية بحاجة إلى التوسع عندما يزداد عدد المستخدمين أو حجم العمليات.
رأيي: قاعدة البيانات المركزية مناسبة للمؤسسات الصغيرة والمتوسطة التي لا تحتاج إلى توزيع البيانات على نطاق واسع، لكنها قد تكون غير عملية للأنظمة الكبرى التي تتطلب سرعة ومرونة عالية.
المميزات الرئيسية لقاعدة البيانات المركزية
- سهولة الإدارة والتحكم من خلال نقطة مركزية واحدة.
- توفير مستوى عالٍ من الأمان نظرًا لمحدودية نقاط الوصول.
- تقليل تكرار البيانات وضمان توحيدها.
- سهولة النسخ الاحتياطي والصيانة مقارنة بالأنظمة الموزعة.
حالات استخدام قاعدة البيانات المركزية
يمكن استخدام قواعد البيانات المركزية في المؤسسات التي تعتمد على نظام بيانات موحد، مثل بعض الأنظمة الحكومية والتعليمية والإدارية. كما يمكن استخدامها في الشركات الصغيرة والمتوسطة، أو في التطبيقات الداخلية التي تعمل ضمن بنية تحتية محدودة.
وتختلف ملاءمة هذا النموذج حسب حجم النظام ومتطلبات التوافر والتوسع. لذلك لا يمكن القول إن قاعدة البيانات المركزية مخصصة للمؤسسات الصغيرة فقط، فقد تستخدم البنى المركزية أيضا في أنظمة كبيرة، مع إضافة تقنيات التكرار والتوافر العالي حسب الحاجة.
أهم حالات استخدام قاعدة البيانات المركزية:
- المؤسسات الحكومية التي تتطلب إدارة موحدة للبيانات.
- البنوك والهيئات المالية التي تحتاج إلى أمان ودقة عالية.
- الشركات الصغيرة والمتوسطة التي لا تتعامل مع فروع متعددة.
- أنظمة تسجيل الطلاب في الجامعات أو المدارس.
10. قاعدة البيانات الموزعة (Distributed Database)

قاعدة البيانات الموزعة (Distributed Database) هي قاعدة بيانات يتم توزيع بياناتها أو مكوناتها على أكثر من خادم أو عقدة، وقد توجد هذه العقد في موقع واحد أو في مواقع جغرافية مختلفة. وعلى الرغم من هذا التوزيع، يمكن أن تعمل المكونات معا لتوفير قاعدة بيانات أو خدمة بيانات متكاملة للتطبيقات والمستخدمين.
يسمح التوزيع ببناء أنظمة تستطيع التوسع عبر عدة خوادم، كما يمكن أن يساعد على تحسين التوافر وتقليل تأثير تعطل بعض المكونات. وفي الأنظمة الموزعة جغرافيا، يمكن أيضا وضع البيانات أو النسخ الأقرب إلى المستخدمين أو الخدمات التي تحتاج إليها، وفقا لتصميم النظام.
ولا يعني توزيع قاعدة البيانات أن كل خادم يحتوي بالضرورة على جزء مختلف من البيانات. فقد يتم تقسيم البيانات (Partitioning أو Sharding) بين العقد، أو يمكن الاحتفاظ بنسخ مكررة من البيانات باستخدام Replication، أو الجمع بين الأسلوبين.
أنماط التوزيع
التوزيع يمكن أن يكون:
1. التوزيع الأفقي (Horizontal Partitioning/Sharding):
- تقسيم البيانات حسب الصفوف
- كل قسم يحتوي على مجموعة من السجلات
- مثال: تقسيم بيانات العملاء حسب المناطق الجغرافية
2. التوزيع العمودي (Vertical Partitioning):
- تقسيم البيانات حسب الأعمدة
- كل قسم يحتوي على مجموعة من الحقول
- مثال: فصل البيانات الشخصية عن البيانات المالية
3. النسخ المتماثل (Replication):
- نسخ نفس البيانات في عدة مواقع
- يحسن من أداء القراءة وتحمل الأخطاء
تحديات التوزيع
إدارة قواعد البيانات الموزعة تواجه تحديات معقدة:
- ضمان تماسك البيانات (Data Consistency)
- إدارة المعاملات الموزعة
- التعامل مع تأخير الشبكة
- توزيع الأحمال بفعالية
الحلول التكنولوجية
تقنيات مثل CAP Theorem توضح المقايضات بين:
- Consistency: تماسك البيانات
- Availability: توفر الخدمة
- Partition Tolerance: تحمل انقطاع الشبكة
مميزات قواعد البيانات الموزعة
من أهم مميزات قواعد البيانات الموزعة قابلية التوسع، إذ يمكن توزيع البيانات والعمليات على عدة خوادم بدلا من الاعتماد على جهاز واحد. وقد يكون ذلك مهما للتطبيقات التي تتعامل مع أحجام كبيرة من البيانات أو أعداد ضخمة من الطلبات.
كما يمكن أن تساعد البنية الموزعة على رفع مستوى التوافر (High Availability)، خصوصا عندما تستخدم آليات التكرار والتعافي من الأعطال. فإذا تعطلت عقدة معينة، يمكن للنظام المصمم بصورة مناسبة الاستمرار في تقديم الخدمة باستخدام عقد أخرى.
وتفيد قواعد البيانات الموزعة أيضا في التطبيقات التي تعمل عبر مناطق جغرافية متعددة. فقد تساعد البنية الموزعة على وضع البيانات أو النسخ بالقرب من الخدمات والمستخدمين، مما قد يقلل زمن الوصول إلى البيانات في بعض السيناريوهات.
تحديات قواعد البيانات الموزعة
رغم هذه المميزات، فإن إدارة قاعدة البيانات الموزعة أكثر تعقيدا من إدارة نظام مركزي في كثير من الحالات. ويحتاج النظام إلى التعامل مع تأخير الشبكة واحتمال انقطاع الاتصال بين العقد، إضافة إلى إدارة النسخ والتوزيع والتزامن.
كما يمثل الحفاظ على اتساق البيانات (Data Consistency) تحديا مهما، خصوصا عندما يتم تحديث البيانات في أكثر من عقدة. وتختلف طريقة التعامل مع الاتساق وفقا للنظام المستخدم ونموذج البيانات ومتطلبات التطبيق.
وتصبح المعاملات الموزعة أكثر تعقيدا أيضا، لأن تنفيذ عملية واحدة قد يتطلب مشاركة أكثر من عقدة. لذلك تحتاج الأنظمة التي تعتمد على هذا النموذج إلى تصميم دقيق يوازن بين الاتساق والتوافر والأداء.
ما علاقة CAP Theorem بقواعد البيانات الموزعة؟
ترتبط قواعد البيانات الموزعة بمفهوم نظرية CAP (CAP Theorem)، وهي نظرية تشرح القيود والمقايضات في الأنظمة الموزعة عند حدوث انقسام شبكي (Network Partition).
وتتكون CAP من ثلاثة مفاهيم رئيسية: الاتساق (Consistency)، والتوافر (Availability)، وتحمل الانقسام (Partition Tolerance). وفي النظام الموزع الذي قد يتعرض لانقسام في الاتصال بين العقد، لا يمكن ضمان جميع هذه الخصائص الثلاث بصورة مطلقة في الوقت نفسه، ولذلك تختار الأنظمة تصميمات مختلفة وفقا لمتطلباتها.
ومن المهم عدم تقديم CAP باعتبارها مجرد اختيار بسيط بين خاصيتين. كما أن Partition Tolerance ليست خاصية يمكن للنظام الموزع الاستغناء عنها عمليا، لأن انقطاع الاتصال بين العقد يمثل أحد الاحتمالات الأساسية التي يجب على الأنظمة الموزعة التعامل معها.
ولهذا السبب، فإن اختيار قاعدة بيانات موزعة لا يعتمد على حجم البيانات فقط. بل يعتمد أيضا على متطلبات الاتساق والتوافر والتوسع وزمن الاستجابة وطبيعة العمليات وموقع المستخدمين. وهذه العوامل تحدد ما إذا كانت البنية المركزية أو الموزعة أكثر ملاءمة للمشروع.
وبالنسبة لموقع أو تطبيق يعمل ضمن الحوسبة السحابية، يمكن أن تصبح قواعد البيانات الموزعة جزءا من البنية التي تسمح بالتوسع والتوافر عبر عدة خوادم أو مناطق. أما في تصميم المواقع، فلا يعني استخدام أكثر من خادم ويب أن قاعدة البيانات نفسها أصبحت موزعة؛ فقد تعمل خوادم الويب المتعددة مع قاعدة بيانات مركزية واحدة.
وهذا التفريق مهم جدا في مقال أنواع قواعد البيانات، لأن التوزيع يتعلق ببنية قاعدة البيانات وطريقة وضع البيانات ومكوناتها، وليس بمجرد عدد خوادم التطبيق.
رابعا: أنواع قواعد البيانات حسب بيئة التشغيل والإدارة
11. قاعدة البيانات السحابية (Cloud Database)

يقصد بقاعدة البيانات السحابية (Cloud Database) قاعدة البيانات التي تعمل ضمن بيئة الحوسبة السحابية، بحيث يمكن الوصول إليها وإدارتها عبر البنية التحتية السحابية. وتوفر هذه القواعد مرونة في تخصيص الموارد، مع إمكانية زيادة أو تقليل القدرة الحوسبية والتخزين السحابي وفقا لحاجة التطبيق. وقد تكون قاعدة البيانات السحابية علائقية أو غير علائقية، لذلك فإن كلمة “سحابية” تصف بيئة التشغيل وطريقة تقديم الخدمة، وليست نموذجا مستقلا لتنظيم البيانات. ومن أمثلتها خدمات مثل Azure SQL Database وAmazon RDS وOracle Autonomous Database.
لا يعني تشغيل قاعدة البيانات في السحابة أنها تقدم دائما ضمن نموذج SaaS (Software as a Service). ففي كثير من الحالات تقدم كخدمة قواعد بيانات مدارة (Managed Database Service)، حيث يتولى مزود السحابة جزءا كبيرا من مهام البنية التحتية والتحديثات والنسخ الاحتياطي والمراقبة. ومع ذلك، تبقى مسؤوليات مثل إدارة المستخدمين والصلاحيات وتصميم قاعدة البيانات وحماية البيانات مرتبطة بإعدادات العميل ومسؤولياته. لذلك تختلف درجة الإدارة التي يتحملها الفريق وفقا للخدمة المختارة ونموذج المسؤولية المشتركة.
مميزات قاعدة البيانات المستندة على السحابة
في هذا القسم، سيتم شرح بعض الجوانب الإيجابية لقواعد البيانات المستندة على السحابة.
قابلية التوسع (High Scalability)
توفر البيئة السحابية إمكانية زيادة الموارد أو تقليلها وفقا لحجم العمل. وقد يشمل ذلك زيادة القدرة الحوسبية أو مساحة التخزين أو عدد العقد في بعض الأنظمة. كما تستطيع بعض الخدمات التعامل مع التوسع وإعادة توزيع البيانات والموارد بصورة آلية أو شبه آلية، مما يقلل الجهد المطلوب من الفريق التقني.
تقليل المسؤوليات الإدارية (Reduced Administrative Responsibilities)
تقلل قواعد البيانات السحابية المدارة من الأعمال المرتبطة بإدارة الخوادم ونظام التشغيل وبعض مهام الصيانة والتحديث والنسخ الاحتياطي. وهذا يسمح للفريق بالتركيز بدرجة أكبر على تصميم البيانات وتطوير التطبيقات وتحسين الاستعلامات. ومع ذلك، لا تلغي هذه الخدمات الحاجة إلى المتخصصين في قواعد البيانات، لأن تصميم النظام والأمان والأداء والصلاحيات تظل مسؤوليات مهمة.
تحسين الأمان وإدارته
يمكن لمزودي الخدمات السحابية توفير أدوات متقدمة للتشفير وإدارة الصلاحيات والمراقبة والنسخ الاحتياطي واكتشاف بعض التهديدات. لكن استخدام قاعدة بيانات سحابية لا يعني تلقائيا أنها أكثر أمانا من قاعدة البيانات المحلية، لأن مستوى الحماية يعتمد أيضا على إعدادات الخدمة وطريقة إدارة الحسابات والصلاحيات والتطبيق. لذلك يجب التعامل مع الأمان باعتباره مسؤولية مشتركة بين مزود الخدمة والجهة التي تستخدم قاعدة البيانات.
على الرغم من أن هذه الإجراءات قابلة للتطبيق، إلا أنه في الواقع معظم الشركات إما لا ترغب في تنفيذها أو تنفذها بشكل ضعيف وغير فعال. لتجنب مثل هذه المشاكل، يمكن اختيار النوع المستند إلى السحابة من بين أنواع قواعد البيانات المختلفة.
نماذج التسعير
تتنوع نماذج التسعير السحابية:
- Pay-as-you-use: دفع حسب الاستخدام
- Reserved Instances: حجز مسبق بخصومات
- Spot Pricing: أسعار متغيرة حسب العرض والطلب
12. قواعد البيانات المدارة (Managed Databases)
يقصد بقواعد البيانات المدارة (Managed Databases) خدمات قواعد البيانات التي يتولى فيها مزود الخدمة جزءا من مهام الإدارة والتشغيل والصيانة بدلا من قيام فريق المؤسسة بتنفيذ جميع هذه المهام بنفسه. وقد تشمل هذه المهام توفير الخوادم، تثبيت نظام قاعدة البيانات، تنفيذ بعض التحديثات، إدارة النسخ الاحتياطية، المراقبة، وإتاحة خيارات للتوسع والتوافر العالي. وتوجد قواعد البيانات المدارة في البيئات السحابية بصورة واسعة، لكنها ليست مرادفا لكلمة “سحابية”، لأن التصنيف هنا يركز على نموذج الإدارة والمسؤوليات.
تساعد هذه الخدمات المؤسسات على تقليل الوقت المطلوب لإدارة البنية التحتية، كما تمنح فرق التطوير طريقة أسرع لتوفير قواعد البيانات وتشغيلها داخل التطبيقات. وتختلف المهام التي يتولاها المزود من خدمة إلى أخرى، لذلك يجب مراجعة حدود المسؤولية قبل اختيار الخدمة. ومن أمثلتها Amazon RDS وAzure SQL Database وGoogle Cloud SQL، حيث توفر هذه الخدمات طبقة مدارة فوق أنظمة قواعد بيانات معروفة، مع اختلاف الخصائص والإمكانات بين كل خدمة وأخرى.
المميزات
- تقليل عبء الإدارة: المزود يتولى التثبيت والتحديثات والصيانة
- نسخ احتياطي تلقائي: إدارة النسخ الاحتياطية والاستعادة دون جهد يدوي
- مراقبة مستمرة: متابعة الأداء والحالة على مدار الساعة
- توسع مرن: إمكانية زيادة الموارد أو تقليلها حسب الحاجة
- توافر عالٍ: خيارات جاهزة للتوافر العالي وتوزيع الأحمال
- توفير الوقت: فرق التطوير تركز على التطبيق لا على البنية التحتية
- أمان مُدار: تحديثات أمنية وتصحيحات من المزود
العيوب
- تكلفة أعلى: مقابل الخدمات المُدارة قد تتجاوز تكلفة الإدارة الذاتية
- تحكم محدود: لا يمكنك الوصول إلى كل إعدادات النظام أو تعديلها
- ارتباط بالمزود: الانتقال من مزود لآخر قد يكون معقداً ومكلفاً
- حدود المسؤولية غير واضحة: يجب مراجعة ما يتحمله المزود وما يبقى على فريقك
- قيود على الإصدارات: قد لا يدعم المزود كل إصدارات قاعدة البيانات أو الإضافات
- قيود جغرافية: قد لا تتوفر الخدمة في كل المناطق أو الدول
- اعتماد على الاتصال: انقطاع الاتصال بالمزود يعني انقطاع الوصول للبيانات
خامسا: قواعد البيانات والتقنيات المتخصصة
تضم هذه الفئة قواعد بيانات أو أنظمة تخزين متخصصة ظهرت لتلبية احتياجات تقنية محددة، ولا يصح اعتبارها جميعا نماذج مستقلة تنافس قواعد البيانات العلائقية أو NoSQL. ومن أبرز الأمثلة قواعد البيانات المرتبطة بتقنية البلوكشين (Blockchain)، التي تعتمد على بنية مختلفة لتسجيل المعاملات والتحقق منها ومشاركة سجل البيانات بين العقد.
13. قواعد بيانات البلوكشين (Blockchain databases)

تستخدم أنظمة البلوكشين بنية موزعة لتسجيل البيانات داخل كتل (Blocks) مرتبطة تشفيرياً ببعضها، مع استخدام آليات إجماع للتحقق من إضافة السجلات إلى السلسلة. ولهذا السبب يصعب تعديل السجلات السابقة دون اكتشاف التغيير أو دون امتلاك السيطرة المطلوبة على آلية الإجماع المستخدمة في الشبكة.
ومع ذلك، لا ينبغي وصف البلوكشين بأنه مجرد “قاعدة بيانات تقليدية غير قابلة للتغيير”، لأن له بنية وآليات تشغيل تختلف عن أنظمة إدارة قواعد البيانات المعتادة.
تستخدم تقنية البلوكشين في العملات الرقمية مثل Bitcoin وEthereum، كما يمكن استخدامها في تتبع سلاسل التوريد وإدارة الأصول الرقمية والعقود الذكية (Smart Contracts) وغيرها من التطبيقات التي تحتاج إلى سجل موزع يمكن التحقق منه.
وتتمثل أبرز مزاياها في إمكانية التحقق المشترك من السجلات، ومقاومة التلاعب، وتوفير سجل تاريخي للمعاملات، خاصة عندما لا تكون هناك جهة واحدة تدير السجل بالكامل.
ومع ذلك، لا تناسب البلوكشين جميع التطبيقات التي تحتاج إلى تخزين البيانات. فقد تكون عمليات الكتابة والاستعلام أقل كفاءة من قواعد البيانات التقليدية في بعض الاستخدامات، كما قد تظهر تحديات تتعلق بحجم البيانات والخصوصية وقابلية التوسع واستهلاك الطاقة في بعض آليات الإجماع. لذلك تستخدم البلوكشين عندما تكون خصائصها الخاصة مطلوبة فعلاً، وليس باعتبارها بديلاً عاماً لقواعد البيانات التقليدية.
المميزات
- التحقق المشترك: يمكن لعدة أطراف التحقق من السجلات دون جهة مركزية
- مقاومة التلاعب: تعديل السجلات السابقة يكشفه التشفير وارتباط الكتل
- سجل تاريخي كامل: كل معاملة تُسجل وتبقى قابلة للتتبع
- اللامركزية: لا تحتاج إلى جهة واحدة تدير السجل بالكامل
- الشفافية: يمكن التحقق من صحة السلسلة بشكل مستقل
- العقود الذكية: تنفيذ اتفاقيات تلقائية دون وسيط
العيوب
- ليست بديلاً عاماً: لا تصلح لكل تطبيقات تخزين البيانات
- كفاءة أقل: عمليات الكتابة والاستعلام قد تكون أبطأ من قواعد البيانات التقليدية
- تحديات التوسع: حجم البيانات المتنامي قد يبطئ الشبكة
- استهلاك الطاقة: بعض آليات الإجماع مثل Proof of Work تستهلك طاقة كبيرة
- الخصوصية محدودة: السجل الموزع قد يكشف بيانات لا يُراد نشرها
- تكلفة الكتابة: إضافة سجلات جديدة قد تكون مكلفة خاصة في الشبكات المزدحمة
- تعقيد الإدارة: تحتاج خبرة في التشفير وآليات الإجماع
سادسا: قواعد البيانات حسب الترخيص ونموذج التطوير
14. قاعدة البيانات مفتوحة المصدر (Open Source Database)

تشير قاعدة البيانات مفتوحة المصدر (Open Source Database) إلى نظام قاعدة بيانات يكون مصدره متاحا وفقا لترخيص مفتوح المصدر معتمد، بما يسمح باستخدامه وتعديله وإعادة توزيعه ضمن الشروط التي يحددها الترخيص. ويمنح هذا النموذج المؤسسات والمطورين قدرة أكبر على فحص الشيفرة وتخصيص النظام والمشاركة في تطويره. ومع ذلك، فإن كلمة “مفتوح المصدر” لا تعني بالضرورة أن البرنامج يخلو من جميع القيود أو التكاليف، لأن لكل مشروع ترخيصه وشروطه الخاصة.
توجد العديد من أنظمة قواعد البيانات مفتوحة المصدر، ومن أبرزها PostgreSQL وMySQL وMariaDB، إضافة إلى مشاريع أخرى تختلف في نموذج البيانات والاستخدام. ومن المهم هنا تصحيح تصنيف بعض الأمثلة؛ فـ MongoDB يستخدم حاليا SSPL، وهو ترخيص متاح المصدر لكنه ليس ترخيصا مفتوح المصدر معتمدا من OSI، لذلك لا يصح تقديمه كمثال مباشر على قاعدة بيانات مفتوحة المصدر بالمعنى الدقيق. كما تغيرت تراخيص Redis عبر السنوات، وأصبحت الإصدارات الحديثة من Redis 8 متاحة أيضا بموجب AGPLv3 إلى جانب تراخيص أخرى، لذلك يجب تحديد الإصدار عند الحديث عن ترخيص Redis.
ومن أهم مزايا قواعد البيانات مفتوحة المصدر المرونة في التخصيص، وانخفاض تكاليف الترخيص في كثير من الحالات، وإمكانية فحص الشيفرة، وتوافر مجتمعات تقنية واسعة. كما يمكن استخدامها في مشاريع الويب والأنظمة المؤسسية والبيئات السحابية والموزعة، لكن اختيارها يجب أن يعتمد أيضا على خبرة الفريق ومتطلبات الأمان والدعم والصيانة. لذلك لا يكفي أن يكون النظام مفتوح المصدر، بل يجب التأكد من أن الترخيص والإمكانات الفنية ودورة التطوير تناسب طبيعة المشروع.
أشهر قواعد البيانات مفتوحة المصدر
- PostgreSQL: نظام علائقي متقدم يتميز بإمكانات قوية في SQL والتوسع.
- MySQL: نظام علائقي واسع الاستخدام، خصوصا في تطبيقات الويب.
- MariaDB: نظام علائقي مفتوح المصدر نشأ كفرع متوافق مع MySQL في بدايته.
- SQLite: قاعدة بيانات مدمجة وخفيفة تستخدم داخل التطبيقات والأجهزة.
- Apache Cassandra: قاعدة بيانات موزعة من نموذج Wide-Column ومصممة للتوسع الأفقي.
المزايا الاقتصادية والتقنية
تمنح قواعد البيانات مفتوحة المصدر المؤسسات مرونة أكبر في اختيار بيئة التشغيل والتخصيص، كما يمكن أن تقلل تكاليف تراخيص البرمجيات مقارنة ببعض المنتجات التجارية. كذلك توفر المشاريع النشطة مجتمعات واسعة ومصادر تعليمية وأدوات مساعدة، مما يسهل عملية التطوير والصيانة.
اعتبارات مهمة
عند اختيار قاعدة بيانات مفتوحة المصدر، يجب النظر إلى الترخيص، ومستوى الدعم الفني، وخبرة الفريق، والأمان، والتوافق مع المشروع، واستراتيجية الصيانة طويلة المدى. كما يجب التأكد من نوع الترخيص المستخدم في الإصدار المحدد، لأن بعض المشاريع غيرت تراخيصها عبر الزمن، وقد تختلف الشروط بين إصدار وآخر
ما هي أهمية أنواع قواعد البيانات؟
تكمن أهمية أنواع قواعد البيانات في أنها ليست مجرد وسائل لتخزين المعلومات، بل أدوات استراتيجية مصممة لتلبية احتياجات مختلفة ومتنوعة في عالم التقنية وإدارة الأعمال. كل نوع من قواعد البيانات وجد لحل مشكلات معينة أو لتقديم مزايا تناسب بيئات محددة، وهذا ما يجعل فهمها ضروريًا للمبتدئين والمحترفين على حد سواء.
أولًا، تساعدنا الأنواع المختلفة على اختيار النظام الأمثل بناءً على طبيعة البيانات التي نتعامل معها. على سبيل المثال، قواعد البيانات العلائقية (Relational Databases) مناسبة للتعامل مع الجداول والبيانات المنظمة، بينما قواعد البيانات غير العلائقية (NoSQL) تستخدم عند الحاجة إلى المرونة والتعامل مع بيانات ضخمة أو غير منظمة، مثل بيانات وسائل التواصل الاجتماعي أو تطبيقات الذكاء الاصطناعي.
ثانياً، تسهم هذه الأنواع في تحسين الأداء والكفاءة. فقاعدة البيانات الموزعة (Distributed Database) تسمح بتخزين البيانات على خوادم متعددة لزيادة السرعة وتقليل الأعطال. بينما قواعد بيانات السلاسل الكتلية (Blockchain Databases) تقدم مستوى عالياً من الشفافية والأمان في العمليات المالية والمعاملات. هذا التنوع يجعل المؤسسات قادرة على اختيار ما يتناسب مع أهدافها: السرعة، الأمان، أو سهولة التوسع.
وأخيرًا، فإن فهم أنواع قواعد البيانات يفتح الباب أمام تطوير حلول مبتكرة، إذ يمكن دمج أكثر من نوع في نظام واحد لتحقيق توازن بين المرونة والأمان والكفاءة. وبذلك، تصبح معرفة هذه الأنواع ليست مجرد معرفة نظرية، بل مهارة عملية تساعد على بناء أنظمة قوية وفعّالة تلبي احتياجات العصر الرقمي.
الخاتمة
تشكل أنواع قواعد البيانات الركيزة الأساسية في عالم التقنية الحديثة. فهي القلب النابض لكل تطبيق أو نظام يعتمد على معالجة البيانات وتخزينها بطرق آمنة وفعّالة. ومع تنوع أنواعها بين قواعد البيانات العلائقية، والموزعة، والبلوكشين، والرسومية وغيرها، أصبح بإمكان المؤسسات والأفراد اختيار النموذج الأمثل الذي يتناسب مع احتياجاتهم وأهدافهم. إن فهم هذه الأنواع واستيعاب مزاياها وعيوبها يفتح أمامنا آفاقاً واسعة لتطوير حلول مبتكرة، وبناء أنظمة أكثر قوة ومرونة. وفي النهاية، يبقى الاستثمار في تعلم وإتقان التعامل مع قواعد البيانات خطوة استراتيجية لكل من يسعى إلى مواكبة الثورة الرقمية وصناعة مستقبل أكثر ذكاءً.
ومع تسارع التحول الرقمي، لم تعد قواعد البيانات مجرد أداة مساعدة، بل أصبحت عنصراً استراتيجياً في بناء أي مشروع تقني أو تجاري. فاختيار النوع المناسب لا يقتصر على حجم البيانات وحده، بل يمتد إلى طبيعة العمليات، ومتطلبات الاتساق، وطريقة وصول التطبيقات إلى البيانات. ومن هنا، تظهر أهمية الفهم العميق للأنواع المختلفة قبل اتخاذ أي قرار تقني. فالقرار الصحيح في بداية المشروع يوفر وقتاً وجهداً وتكلفة أكبر بكثير من محاولة تصحيحه لاحقاً.
وأخيراً، فإن إتقان التعامل مع قواعد البيانات لم يعد حكراً على المطورين والمهندسين فقط. بل أصبح مهارة أساسية لكل من يعمل في مجال التقنية أو إدارة الأعمال. فالمعرفة النظرية وحدها لا تكفي، بل يجب أن تترافق مع تطبيق عملي وممارسة مستمرة. وبهذا، نتمكن من بناء أنظمة قوية وفعّالة، تواكب احتياجات العصر الرقمي، وتساهم في صناعة مستقبل أكثر ذكاءً ومرونة.