Claude Opus 5.5: مراجعة أقوى نموذج ذكاء اصطناعي لغوي متطور من أنثروبيك


أعلنت شركة أنثروبيك في 22 سبتمبر 2026 عن إطلاق Claude Opus 5.5، وهو أول نموذج في عائلة Claude 5.5 الجديدة. يقدم هذا النموذج أداء يقارب Claude Fable 5.1 في معظم الأعمال. ومع ذلك، يكلف أقل بنحو 40% من Opus 5 عند الإعدادات الافتراضية. المفاجأة هنا أن النموذج الرائد في فئة Opus لم يصبح أغلى هذه المرة، بل أرخص. ويأتي الإطلاق في وقت يتجه فيه قطاع الذكاء الاصطناعي نحو وكلاء يعملون ساعات طويلة دون مراقبة لصيقة، وهذا بالضبط ما صمم Claude Opus 5.5 ليتقنه.
يبلغ سعر الإدخال 4 دولارات لكل مليون رمز، وسعر الإخراج 20 دولارا، وهو أقل بنسبة 20% من سعر Opus 5. كما تنخفض قراءة ذاكرة التخزين المؤقت إلى 0.20 دولار لكل مليون رمز. إضافة إلى ذلك، يولد النموذج المخرجات أسرع بأكثر من 30% من سابقه. ويحتفظ Claude Opus 5.5 بـنافذة سياق بحجم مليون رمز. لكنه يفرض تفكيرا تكيفيا لا يمكن تعطيله، ويرفض الاستخدام الإجباري للأدوات. هذان التغييران سيمسان كثيرا من التطبيقات الحالية، لذلك خصصنا لهما قسما كاملا لاحقا.
في هذا المقال نراجع المواصفات التقنية ونتائج الاختبارات المعيارية والتجارب العملية الموثقة مع Claude Opus 5.5. كما نشرح التغييرات الجذرية في واجهة API، ونعرض أمثلة برمجية جاهزة للتشغيل. ثم نقارن النموذج بمنافسيه مثل GPT-6 Astra وGPT-5.6 Sol. اعتمدنا على الإعلان الرسمي ووثائق المنصة وبطاقة النظام، وحدثنا المعلومات حتى أكتوبر 2026. يناسب المقال المطورين وصناع القرار وكتاب المحتوى الباحثين عن فهم دقيق لمكانة هذا النموذج بين نماذج أنثروبيك.
جدول المحتويات
- ما هو Claude Opus 5.5؟
- مقارنة Claude Opus 5.5 مع Sonnet 5.5 وHaiku 5.5 وFable 5.1
- المواصفات التقنية لنموذج Claude Opus 5.5
- ما الجديد في Claude Opus 5.5؟
- التفكير التكيفي ومستويات الجهد في كلود أوبوس 5.5
- نتائج اختبارات كلود أوبوس 5.5 المعيارية
- تجارب عملية موثقة مع Claude Opus 5.5
- اختبر Claude Opus 5.5 بنفسك
- التغييرات الجذرية عند الانتقال إلى Claude Opus 5.5
- أمثلة برمجية لاستخدام Claude Opus 5.5 عبر واجهة API
- الأمان والضمانات في Claude Opus 5.5
- تسعير Claude Opus 5.5
- Claude Opus 5.5 مقابل Opus 5 وFable 5.1 وGPT-6 Astra
- أين يتوفر Claude Opus 5.5 وكيف تبدأ
- متى تستخدم Claude Opus 5.5 ومتى تختار غيره
- قائمة الترحيل إلى Claude Opus 5.5
- الأسئلة الشائعة حول Claude Opus 5.5
- الخاتمة
ما هو Claude Opus 5.5؟
Claude Opus 5.5 أحدث إصدارات Claude AI هو نموذج لغوي كبير من نماذج Anthropic، صممته الشركة للبرمجة الوكيلة الطويلة والعمل المعرفي. يعتمد على بنية نماذج اللغة الكبيرة (LLMs)، وهي نماذج تتدرب على كميات ضخمة من النصوص لفهم اللغة وتوليدها. يقبل النموذج النص والصور مدخلات، ويعيد نصا مخرجات. وتستدعيه من واجهة API بالمعرف claude-opus-5-5، كما يعمل داخل تطبيق Claude وأداة Claude Code. وتصفه وثائق المنصة بأنه الخيار المخصص للبرمجة الوكيلة طويلة التشغيل وأعمال المعرفة.
يختلف هذا النموذج عن المساعدات التقليدية في طريقة العمل. فهو لا يجيب عن سؤال ثم يتوقف، بل ينفذ مهام متعددة الخطوات مستعينا بالأدوات وتشغيل الأكواد وقراءة الملفات. وقد تمتد هذه الحلقات الوكيلة ساعات كاملة. لذلك زودته أنثروبيك بـمصنف يفحص كل إجراء قبل تنفيذه، ووفرت صندوق عزل مفتوح المصدر يستطيع فريق الأمن تدقيقه. وهكذا يصبح الوكيل أقل خطرا حين يعمل دون إشراف مباشر. وهذا شرط أساسي لأي شركة تفكر في تشغيل Claude Opus 5.5 داخل أنظمتها.
اختبر النموذج قبل الإطلاق على يد مقيمين خارجيين، منهم METR وFrontier Design. وتقول أنثروبيك إنه يؤدي عند مستوى Fable 5.1 في معظم الأعمال، مع تكلفة أقل بكثير من سعر Fable البالغ 10 دولارات للإدخال و50 دولارا للإخراج. لكن الشركة تضيف ملاحظة صريحة. فهي ترى أن الفجوة الفعلية بين النموذجين في الاستخدام اليومي أضيق مما توحي به الأرقام. وهذه الصراحة تعطي Claude Opus 5.5 مصداقية إضافية، وتذكرنا بأن المعايير وحدها لا تحسم الاختيار.
مقالة ذات صلة: Claude AI: كيف يغيّر هذا النموذج المتطور مستقبل الذكاء الاصطناعي؟
تاريخ إطلاق كلود أوبوس 5.5 وموقعه بين نماذج أنثروبيك
ظهر Claude Opus 5 في 24 يوليو 2026 بسعر 5 دولارات للإدخال و25 دولارا للإخراج. وفي مطلع سبتمبر قدمت أنثروبيك Claude Fable 5.1 كنموذج من الفئة الأعلى. ثم وصل Claude Opus 5.5 في 22 سبتمبر 2026 ليصبح النموذج الرائد الحالي في فئة Opus. وتصف الوثائق الرسمية Opus 5 الآن بأنه نموذج قديم، وتنصح بالانتقال إلى الإصدار الجديد. أما Opus 4.8 فيبقى حاضرا في الخلفية، لأن الضمانات تحول إليه معظم مهام الأمن السيبراني حين تتدخل.
يمثل هذا الإصدار أول إطلاق من أنثروبيك بعد دعوة داريو أمودي إلى تنظيم وتيرة تقدم الذكاء الاصطناعي. وتقول الشركة إن الهدف هو إبقاء ممارسات الأمان متقدمة على قدرات النماذج. ولهذا يصل Claude Opus 5.5 مع ضمانات تشبه ما في Fable 5.1، وتشمل الأمن السيبراني والأحياء ومكافحة التقطير. سنفصل هذه الضمانات في قسم مستقل لاحقا، لأنها تغير سلوك النموذج في بعض الطلبات. ونرى أن هذه النقطة ستؤثر في قرارات الشركات أكثر من أي رقم أداء.
لم يبق النموذج وحده في الساحة طويلا. فقد أعلنت أنثروبيك أن Sonnet 5.5 وHaiku 5.5 سيتبعانه بتحسينات مشابهة في الأداء والكفاءة والأمان. وتحقق ذلك سريعا، إذ وصل Sonnet 5.5 في أواخر سبتمبر. ثم أطلقت الشركة Haiku 5.5 في 7 أكتوبر 2026 بسعر يبدأ من 0.10 دولار للإدخال. وبذلك اكتملت عائلة Claude 5.5 خلال نحو أسبوعين. وهذا الإيقاع السريع يعني أن أي مقال عن النماذج يحتاج إلى مراجعة دورية، وهو ما دفعنا إلى تحديث هذا المقال بالكامل حول Claude Opus 5.5.
مقارنة Claude Opus 5.5 مع Sonnet 5.5 وHaiku 5.5 وFable 5.1
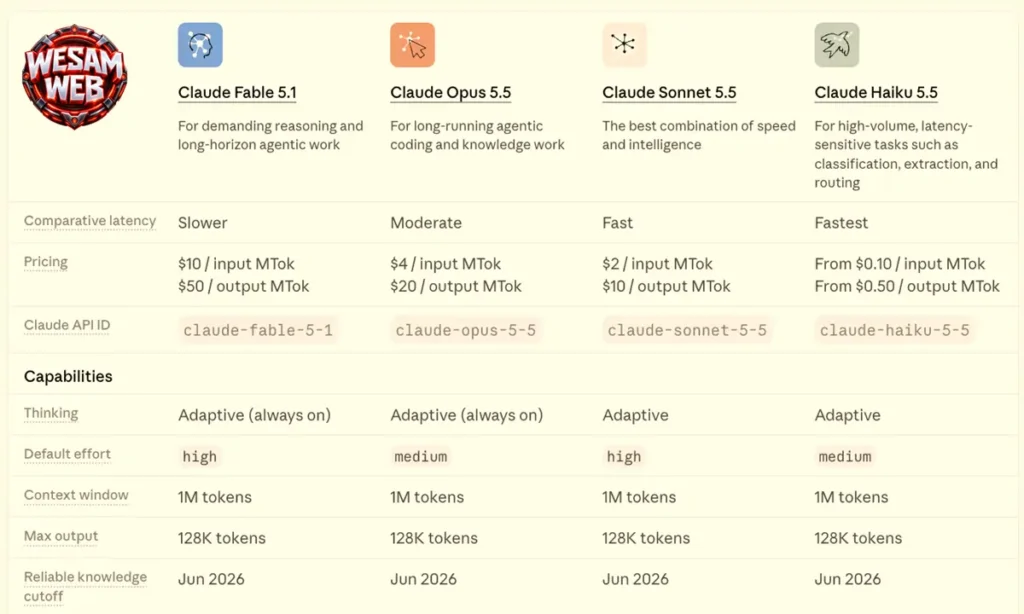
تضم العائلة الحالية أربعة نماذج رئيسية تخدم احتياجات مختلفة. يقع Claude Fable 5.1 في القمة بسعر 10 دولارات للإدخال و50 دولارا للإخراج. ثم يأتي Claude Opus 5.5 بأداء قريب منه وبسعر أقل بنسبة 60%. بعده يأتي Sonnet 5.5 كخيار متوازن بين السرعة والذكاء. وأخيرا يخدم Haiku 5.5 المهام الكبيرة الرخيصة. وتساعدك هذه الصورة على اختيار النموذج المناسب قبل أن تكتب أي سطر برمجي أو تتعاقد على أي خطة اشتراك.
تتشارك النماذج الأربعة نافذة سياق بحجم مليون رمز، وحد إخراج يبلغ 128 ألف رمز. أما الفروق الحقيقية فتظهر في السعر وسرعة الاستجابة وعمق الاستدلال. ويسري سعر Haiku المنخفض على المطالبات حتى 100 ألف رمز، ثم يرتفع بعد ذلك. لذلك يحتاج المطور إلى حساب متوسط طول مطالباته قبل أن يعتمد عليه. يلخص الجدول التالي هذه الفروق، ويضع Claude Opus 5.5 في سياقه الصحيح داخل العائلة.
| النموذج | تاريخ الإصدار | السعر لكل مليون رمز (إدخال / إخراج) | مستوى الجهد الافتراضي | الاستخدام الأنسب |
|---|---|---|---|---|
| Claude Fable 5.1 | مطلع سبتمبر 2026 | $10 / $50 | high | أصعب المهام وأعلى مستوى قدرة |
| Claude Opus 5.5 | 22 سبتمبر 2026 | $4 / $20 | medium | البرمجة الوكيلة الطويلة والعمل المعرفي |
| Claude Sonnet 5.5 | أواخر سبتمبر 2026 | $2 / $10 | high | التوازن بين السرعة والذكاء |
| Claude Haiku 5.5 | 7 أكتوبر 2026 | من $0.10 / $0.50 | medium | المهام الكبيرة والتصنيف والوكلاء الفرعيون |
المواصفات التقنية لنموذج Claude Opus 5.5
تحدد المواصفات ما يستطيع النموذج فعله داخل مشروعك فعليا. يبلغ حجم نافذة السياق في Claude Opus 5.5 مليون رمز، وهو ما يعادل نحو 555 ألف كلمة إنجليزية وفق وثائق المنصة. أما الحد الأقصى للإخراج فيبلغ 128 ألف رمز في الطلب المتزامن. ويرتفع هذا الحد إلى 300 ألف رمز في واجهة الدفعات عند تفعيل الرأس التجريبي output-300k-2026-03-24. وتكفي هذه الأرقام لمعالجة مستودعات برمجية كبيرة أو مجموعات مستندات قانونية كاملة في طلب واحد.
يعتمد النموذج على التفكير التكيفي المفعل دائما، ومستوى الجهد الافتراضي فيه هو المتوسط. أما تاريخ القطع المعرفي الموثوق فهو يونيو 2026. كما يدعم Claude Opus 5.5 التخزين المؤقت للمطالبات بحد أدنى 512 رمزا، ومعالجة الدفعات بخصم 50%، وواجهة الملفات ودعم PDF والرؤية. ويعمل مع الأدوات من جهة الخادم ومن جهة العميل. كما أنه متاح مع خيار عدم الاحتفاظ بالبيانات (ZDR) مثل نماذج Opus السابقة. يلخص الجدول التالي أهم الخصائص التي يحتاجها المطور.
| الخاصية | القيمة |
|---|---|
| معرف النموذج في Claude API | claude-opus-5-5 |
| معرف النموذج في Amazon Bedrock | anthropic.claude-opus-5-5 |
| تاريخ الإصدار | 22 سبتمبر 2026 |
| نافذة السياق | مليون رمز |
| الحد الأقصى للإخراج | 128 ألف رمز (300 ألف في واجهة الدفعات التجريبية) |
| المدخلات والمخرجات | نص وصور، والمخرجات نص |
| التفكير | تكيفي ومفعل دائما |
| مستوى الجهد الافتراضي | medium |
| القطع المعرفي الموثوق | يونيو 2026 |
| الحد الأدنى للتخزين المؤقت | 512 رمزا |
ما الجديد في Claude Opus 5.5؟
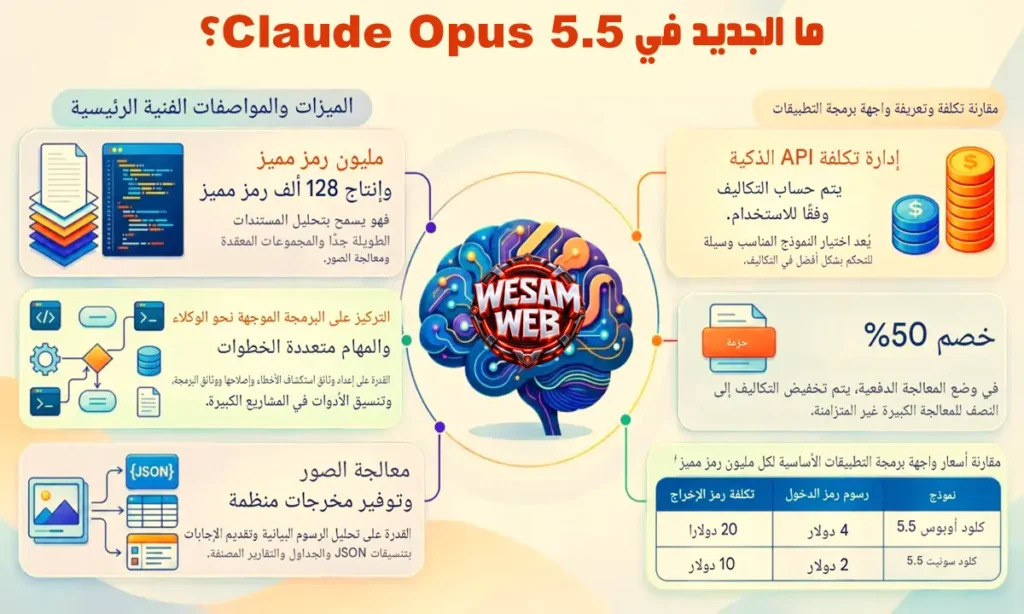
يحمل Claude Opus 5.5 مجموعة تحسينات تمس الأداء والتكلفة والأمان في وقت واحد. وتصفه أنثروبيك بأنه خطوة كبيرة عن Opus 5، وبأنه النموذج الرائد الجديد. كما تقول إن المختبرين المبكرين رأوا قفزات كبيرة في أعقد أعمالهم. لكن الحكاية لا تتوقف عند الدقة. فالكفاءة تحتل مكانا مركزيا هذه المرة، وتظهر في الأسعار الأقل وفي عدد الرموز الأقل لكل مهمة وفي زمن إنجاز أقصر. ولهذا قد يكون هذا الإصدار أكثر إفادة للميزانيات من أي قفزة في المعايير.
يمكن تلخيص أهم التغييرات في أربعة محاور. الأول هو الكفاءة والتكلفة، والثاني هو البرمجة الوكيلة، والثالث هو العمل المعرفي وجودة الكتابة. أما الرابع فهو قراءة المخططات والصور مع استخدام الحاسوب. سنتناول كل محور بتفصيل، ونذكر الأرقام مع روابط مصادرها. ونقصد بالأرقام هنا ما نشرته أنثروبيك وشركاؤها، لا نتائج مستقلة. ولذلك سنحرص على التمييز بين الاثنين كلما أمكن، وسنخصص قسما لاحقا لقراءة أرقام Claude Opus 5.5 بحذر.
هناك أيضا تغييرات في الضمانات والتوافق مع الأنظمة القائمة. فقد صار التفكير التكيفي مفعلا دائما، وأضيفت ضمانات للأحياء إلى جانب الأمن السيبراني. كما رفعت أنثروبيك حدود الاستخدام لكل خمس ساعات في خطط Pro وMax وTeam وEnterprise القائمة على المقاعد. ومنحت المشتركين إعادة ضبط لحد المعدل يمكن حفظها واستخدامها وقت الحاجة. وسنخصص لتغييرات واجهة API قسما مستقلا، لأنها تؤثر مباشرة على كلفة الترحيل وسلوك التطبيقات.
كفاءة أعلى وتكلفة أقل في كلود أوبوس الجديد
يعتمد الخفض الأكبر في التكلفة على عاملين يعملان معا. فسعر الرمز نفسه انخفض بنسبة 20% عن Opus 5. وصار النموذج يستهلك رموزا أقل لإنجاز المهمة الواحدة. وتنتج هذه المعادلة خفضا بنحو 40% في التكلفة على أعباء العمل النموذجية عند الإعدادات الافتراضية. وتهبط قراءة الذاكرة المؤقتة، وهي الجزء الأكبر من تكلفة العمل البرمجي الوكيل، إلى 0.20 دولار لكل مليون رمز. أي بخفض يبلغ 60% عن Opus 5. ولذلك تستفيد الجلسات الطويلة المتكررة من Claude Opus 5.5 أكثر من غيرها.
تحسنت السرعة أيضا. تقول أنثروبيك إن النموذج يولد المخرجات أسرع بأكثر من 30% من Opus 5. وتتوفر خدمة الوضع السريع (Fast mode) في Claude Code ومنصة Claude بسرعة تصل إلى 2.5 ضعف. ويبلغ سعرها 8 دولارات للإدخال و40 دولارا للإخراج لكل مليون رمز. يناسب هذا الوضع الجلسات التفاعلية التي ينتظر فيها المطور الرد. أما المهام الليلية الطويلة فلا تحتاجه عادة، لأن الوقت فيها أقل أهمية من التكلفة. وهنا يبرز الفرق بين الخيارين بوضوح.
أظهرت شهادات الشركاء أرقاما متقاربة. ذكرت Factory أن النموذج استخدم رموز إخراج أقل بنسبة 20 إلى 25% عند المستوى المتوسط مقارنة بـ Opus 5. وقالت Optiver إن تكلفة بعض أعباء البرمجة لديها انخفضت بين 40 و50%. وأفادت Box بأن النموذج استخدم ثلث الرموز التي استخدمها Opus 5، وبأن إجاباته أقل إسهابا بنسبة 40% دون خسارة في الدقة. وتبقى هذه الأرقام صادرة عن شركات اختبرته في أعمالها الخاصة. لذلك نقترح أن تقيس تكلفة Claude Opus 5.5 على أحمالك الفعلية قبل أي قرار نهائي.
البرمجة الوكيلة في Claude Opus 5.5
يتميز Claude Opus 5.5 في الوظائف الطويلة المتشعبة، مثل ترحيل قواعد الأكواد الكاملة وتدقيقها. استخدمه أحد المختبرين لتدقيق قاعدة أكواد من 200 ألف سطر وإصلاحها في أقل من ثلاث ساعات. أما Opus 5 فاحتاج إلى أكثر من 20 ساعة، واستهلك رموزا أكثر بمقدار 2.5 ضعف. ويعني هذا الفارق أن مهام كانت تحجز يوم عمل كاملا صارت تنتهي قبل الغداء. وتتفق هذه النتيجة مع شهادة Lovable، التي ذكرت أن النموذج ينهي البناء بخطوات أقل بمقدار الثلث إلى النصف.
وفي اختبار آخر، أنجز النموذج ترحيلا برمجيا من 680 ألف سطر في أقل من يوم، وهو عمل يحتاج فريقا هندسيا عدة أسابيع. كما نجح في 39 من 40 محاولة عندما طلب منه تقليل زمن تحميل كل صفحة في تطبيق ويب. أما Opus 5 فحقق تحسينات أصغر، وغير سلوك التطبيق في الوقت نفسه. وهذه النقطة الأخيرة مهمة، لأن التحسين الذي يكسر السلوك ليس تحسينا حقيقيا. ونرى أن قدرة Claude Opus 5.5 على الحفاظ على السلوك أثناء التحسين هي الميزة الأهم هنا.
ركزت أنثروبيك أيضا على الأمان أثناء العمل المستقل. فالنموذج مزود بمصنف يفحص كل إجراء، وبصندوق عزل يمكن تدقيقه، وبمراجعة أكواد تلتقط الثغرات قبل الدمج. وفي حماية الحقن، يطابق النموذج Opus 5 أو يتفوق عليه في كل الإعدادات المختبرة. كما يتعادل مع Fable 5.1 في أدنى نسبة نجاح لهجمات حقن المطالبات وفق اختبار شركة Gray Swan. وقال مطور في Clio إن النموذج بقي على مهمته أكثر من 18 ساعة دون إشراف عبر ست مستودعات. وهذا الرقم يغير نظرتنا إلى حدود الوكلاء.
العمل المعرفي وجودة الكتابة
يبرز النموذج في البحث والتحقق من المعلومات. ففي اختبار داخلي، طلبت أنثروبيك منه كتابة تقرير عن أداء شركة في ربع سنوي، باستخدام نسخة من الويب يصعب فيها العثور على بيان الأرباح. وفحص مقيم آلي كل رقم واقتباس في التقارير. اجتاز 16 من 18 تقريرا من Claude Opus 5.5 معيار الجودة. أما Fable 5.1 وOpus 5 فلم ينجح أي منهما في أي محاولة. وكان أي رقم مختلق كافيا لإسقاط التقرير بالكامل، وهذا شرط صارم يستحق الانتباه.
أظهر النموذج كذلك قدرة على اكتشاف الأخطاء في التعليمات نفسها. أفادت شركة Walleye Capital بأنه لاحظ أن فهرسة الدقائق في تعليماتها خاطئة بمقدار واحد، فصححها وذكر أن ذلك سيكلفه نقاطا عند المقيم. ولم يلتقط أي نموذج سابق هذا الخطأ. وقالت Hex إن النموذج يواصل البحث بعد أول إجابة مقنعة. وفي سير عمل مالي كامل، غطى النموذج 86.6% من عناصر التقييم لدى Hebbia مقابل 60.3% لـ Opus 5. وهذه فجوة كبيرة في عمل يعتمد على الدقة.
حسنت أنثروبيك كذلك طريقة كتابة النموذج وتواصله، وهي ملاحظة تكررت في آراء مستخدمي Opus 5. يضع Claude Opus 5.5 المعلومة الأهم في أول الرد، ويقل استخدامه للمصطلحات الغريبة، ويلتزم بقواعد الكتابة التي تعطيها له. وقال John Ruelas من شركة Ramp إن النموذج يكتب مثل زميل جيد، وإن مواصفة تصميم خرجت منه جاهزة تقريبا. لكن الأمثلة الرسمية كلها بالإنجليزية. وبصفتنا كتاب محتوى عربي، ننصح باختبار جودة الكتابة بالعربية بنفسك قبل أن تبني عليها أي سير عمل تحريري.
الرؤية واستخدام الحاسوب في Claude Opus 5.5
تقول وثائق المنصة إن النموذج يقرأ القيم من المخططات الكثيفة ومن الصور المعتمدة على التخطيط بدقة أكبر بكثير دون استخدام أدوات. وهذا يعني أن بعض الحيل التي بناها المطورون في المطالبات لتعويض ضعف رؤية الحاسوب في النماذج القديمة قد لا تلزم بعد الآن. ومع ذلك، تبقى أدوات معالجة الصور مفيدة في أكثر المدخلات كثافة. ولذلك ننصح بتجربة Claude Opus 5.5 دون هذه الحيل أولا، ثم إضافتها عند الحاجة فقط.
تظهر الأرقام الرسمية هذا التحسن بوضوح. ففي معيار Chartography لقراءة المخططات، سجل النموذج 89.0% مع الأدوات، مقابل 83.4% لـ Opus 5 و88.4% لـ Fable 5.1. وفي معيار OSWorld 2.1 لاستخدام الحاسوب، سجل 81.8% بوضع جزئي، مقابل 74.0% لـ Opus 5 و80.7% لـ Fable 5.1. والفارق عن Opus 5 كبير في الحالتين، أما الفارق عن Fable 5.1 فصغير جدا. وهذا يتفق مع قول أنثروبيك إن الفجوة بين النموذجين أضيق مما تبدو.
للمطورين الذين يبنون وكلاء استخدام الحاسوب ملاحظة عملية مهمة. فعلى Claude API وClaude Models on Google Cloud (النسخة المدارة من جوجل)، يقبل Claude Opus 5.5 مجموعة الأدوات computer_toolset_20260801 فقط. أما الأداة القديمة computer_20251124 فترجع خطأ 400. وعلى Amazon Bedrock تبقى الأداة القديمة تعمل دون تغيير. وسنعرض خطوات الترحيل كاملة في قسم التغييرات الجذرية، مع أمثلة الشيفرة. وإن كنت تبني أداة استخدام حاسوب، فابدأ بهذا التغيير قبل أي تحسين آخر.
التفكير التكيفي ومستويات الجهد في كلود أوبوس 5.5
يتحكم معامل effort في عمق التفكير وزمن الاستجابة والتكلفة معا. ويكون الوضع الافتراضي في Claude Opus 5.5 هو medium، بينما كان الافتراضي في Opus 5 هو high، وفق وثائق المنصة. لذلك قد تنخفض تكلفتك دون أن تغير سطرا واحدا، لكن جودة بعض المهام قد تتأثر أيضا. ويدعم النموذج تغيير الجهد لكل رسالة في نسخة تجريبية. كما أن التفكير التكيفي مفعل دائما، فلا يوجد وضع بلا تفكير. ونوصي بإعادة تشغيل اختباراتك على كل مستوى قبل أن تثبت قيمة واحدة لكل أحمالك.
هناك نقطة تغفل عنها فرق كثيرة. يفكر Claude Opus 5.5 أكثر في كل دور عند نفس المستوى مقارنة بـ Opus 5، وخاصة عند xhigh وmax. لذلك اترك مساحة كافية في max_tokens للتفكير، وإلا انقطع الرد قبل أن يكتمل. وتشير أنثروبيك إلى أن النموذج عند المستوى الافتراضي يتفوق على Opus 5 عند max في Terminal-Bench 4.0 بنحو خمس التكلفة. وهذا يعني أن رفع الجهد ليس دائما الحل الأرخص ولا الأفضل. ويؤيد ذلك فريق CodeRabbit، فقد لاحظ أن رفع الجهد لم يحسن مراجعة الأكواد بشكل ثابت.
- low: أخف المستويات وأسرعها. التقط النموذج عنده 72% من الأخطاء المعروفة في مراجعات الأكواد لدى Deloitte، مقابل 56% لـ Opus 5 عند high، مع إنذارات خاطئة أقل.
- medium (الافتراضي): قالت Factory إنه أول نموذج تعتمده افتراضيا عند هذا المستوى، لأنه ساوى Opus 5 عند high برموز إخراج أقل بنسبة 20 إلى 25%.
- high: مناسب للمسودات الطويلة والمراجعات الحساسة. نصح فريق Every بكتابة المسودات عند هذا المستوى أو أعلى.
- xhigh: اعتمدته أنثروبيك في نتيجة Terminal-Bench 4.0 البالغة 66.4%، وهو أعلى مستوى سجل به النموذج في ذلك المعيار.
- max: أقصى عمق تفكير، وتستخدمه أنثروبيك في معظم نتائجها المعيارية. وهو يستهلك أكبر قدر من الرموز، فاحجز له مساحة واسعة في max_tokens.
نتائج اختبارات كلود أوبوس 5.5 المعيارية
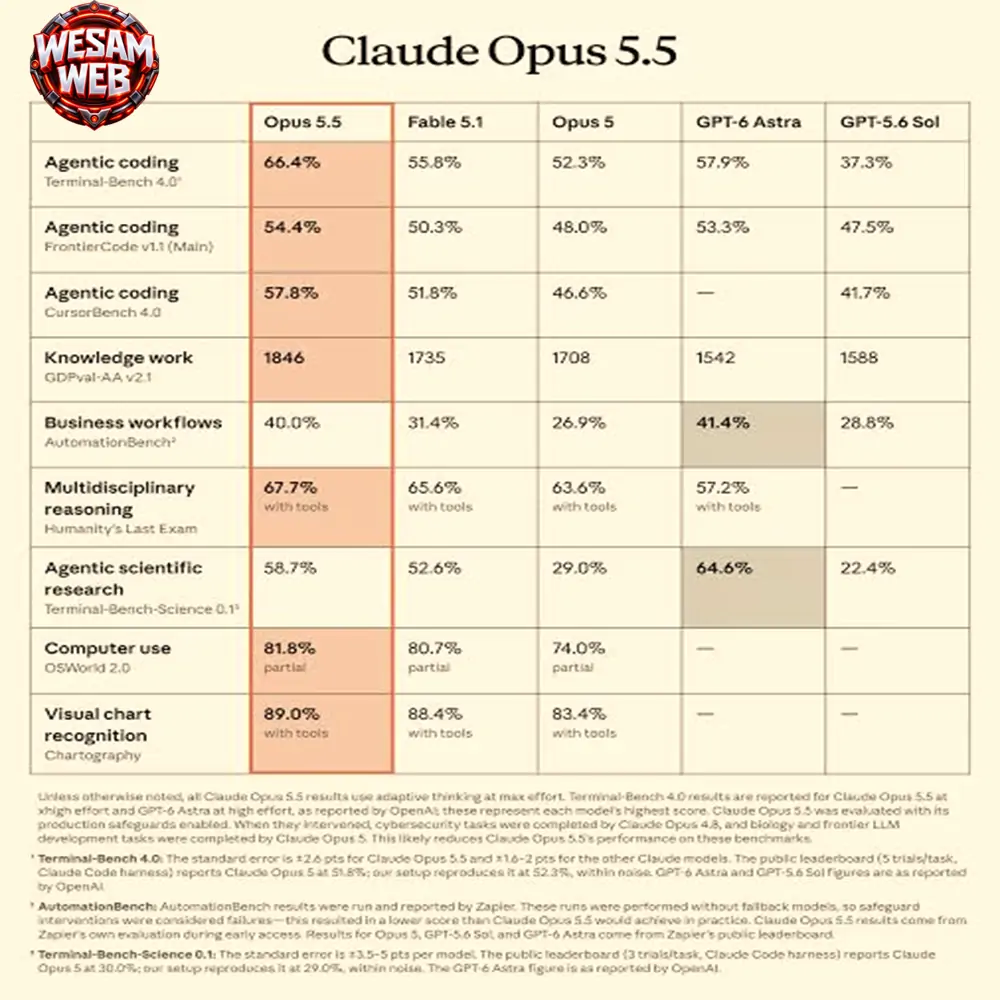
تعرض أنثروبيك نتائج Claude Opus 5.5 على تسعة معايير تغطي البرمجة الوكيلة والعمل المعرفي والاستدلال واستخدام الحاسوب. وتقارنه بأربعة نماذج هي Fable 5.1 وOpus 5 وGPT-6 Astra وGPT-5.6 Sol. وتستخدم معظم النتائج التفكير التكيفي عند أعلى مستوى جهد، عدا Terminal-Bench 4.0 الذي سجل عند xhigh. وتقول الشركة صراحة إن هوامش المعايير صارت دليلا أقل موثوقية على الفروق الحقيقية عند هذه المستويات من القدرة.
وهناك تفصيل يؤثر في قراءة الأرقام. فقد شغلت أنثروبيك النموذج مع الضمانات الإنتاجية مفعلة. وحين تتدخل الضمانات، يكمل Opus 4.8 مهام الأمن السيبراني، ويكمل Opus 5 مهام الأحياء وتطوير النماذج. وتقول الشركة إن ذلك على الأرجح يخفض نتائج Claude Opus 5.5 في هذه المعايير. يلخص الجدول التالي النتائج الرسمية، ثم نشرح كل مجموعة منها على حدة مع الأمثلة والتحفظات.
| المعيار | Claude Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | 52.3% | 57.9% | 37.3% |
| FrontierCode v1.1 | 54.4% | 50.3% | 48.0% | 53.3% | 47.5% |
| CursorBench 4.0 | 57.8% | 51.8% | 46.6% | غير متاح | 41.7% |
| GDPval-AA v2.1 (نقاط Elo) | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench | 40.0% | 31.4% | 26.9% | 41.4% | 28.8% |
| Humanity’s Last Exam (مع أدوات) | 67.7% | 65.6% | 63.6% | 57.2% | غير متاح |
| Terminal-Bench-Science 0.1 | 58.7% | 52.6% | 29.0% | 64.6% | 22.4% |
| OSWorld 2.1 (جزئي) | 81.8% | 80.7% | 74.0% | غير متاح | غير متاح |
| Chartography (مع أدوات) | 89.0% | 88.4% | 83.4% | غير متاح | غير متاح |
أداء Claude Opus 5.5 في البرمجة الوكيلة
يقيس معيار Terminal-Bench 4.0 قدرة النموذج على إنجاز مهام مهنية معقدة متعددة الخطوات داخل سطر الأوامر. سجل Claude Opus 5.5 فيه 66.4% عند مستوى xhigh، مقابل 55.8% لـ Fable 5.1 و52.3% لـ Opus 5. وبلغت نتيجة GPT-6 Astra 57.9% كما أبلغت OpenAI. والفارق عن Opus 5 يتجاوز 14 نقطة، وهو كبير. لكن الخطأ المعياري يبلغ نحو 2.6 نقطة لنموذج Opus 5.5، وهذا يعني أن الفروق الصغيرة لا تحسم شيئا.
أما معيار FrontierCode v1.1 فيسأل سؤالا عمليا: هل ستقبل المراجعة هذا التعديل البرمجي ويدمج؟ سجل النموذج 54.4% عند أعلى جهد، ونحو 54.6% عند المستوى الافتراضي المتوسط وفق نص الإعلان. وهو بذلك أعلى من الجميع، حتى من GPT-6 Astra الذي بلغ 53.3%. وفي CursorBench 4.0، المبني على جلسات حقيقية من محرر Cursor، سجل 57.8% عند الأعلى و52.5% عند المتوسط. وتفوق عند المتوسط على GPT-5.6 Sol بنحو 11 نقطة.
الأهم من الدرجة هو السعر المدفوع مقابلها. تقول أنثروبيك إن Claude Opus 5.5 يتفوق على GPT-6 Astra في FrontierCode بنحو خمس تكلفة المهمة. وفي Terminal-Bench 4.0 يطابقه بنحو 40% من التكلفة. وفي CursorBench يتفوق على Sol بنحو ثلث التكلفة. هذه المقارنات صادرة عن الشركة، لكنها تفسر لماذا تتحدث أنثروبيك عن الكفاءة أكثر من الدرجات الخام. وفي رأينا، هذا هو المعيار الأقرب لقرارات الشراء الفعلية.
أداء كلود أوبوس في العمل المعرفي
يقيس GDPval-AA v2.1 من Artificial Analysis أداء الوكلاء في أعمال مهنية حقيقية عبر 44 مهنة. سجل Claude Opus 5.5 1846 نقطة Elo، مقابل 1735 لـ Fable 5.1 و1708 لـ Opus 5 و1542 لـ GPT-6 Astra. ويتفوق النموذج عند المستوى المتوسط على Astra عند max بنحو خمس التكلفة لكل مهمة. هذه الأرقام تضعه في الصدارة الواضحة في معيار يحاكي أعمال المكاتب. ولذلك يستحق تجربة جادة في الأعمال التحليلية والإدارية.
لكن الصورة ليست أحادية الاتجاه. ففي AutomationBench الذي بنته شركة Zapier لاختبار سير العمل عبر تطبيقات متصلة، سجل النموذج 40.0%، بينما سجل GPT-6 Astra 41.4%. وتوضح أنثروبيك أن Zapier شغلت الاختبار دون نماذج احتياطية، فاعتبرت تدخلات الضمانات إخفاقات. وهذا خفض درجة النموذج على الأرجح. وتقول أيضا إن Opus 5.5 تفوق على Fable 5.1 وOpus 5 في معيار WANDR من Perplexity لجمع البيانات الكبيرة، وبتكلفة أقل لكل مهمة.
ومن المفيد أن تعرف أن منافسين آخرين يتقدمون في هذا المجال. فقد أظهر جدول Google لنموذج Gemini 4 Argon أنه يتصدر صفوف العمل المعرفي الأربعة مقابل Opus 5.5، كما نقل موقع DataCamp. وأوضح الفارق في الأعمال القانونية، إذ سجل Argon 19.6% مقابل 3.8% لـ Claude Opus 5.5 في معيار Harvey. وهذه أرقام شركة منافسة وبمنهجيتها الخاصة. لذلك نقترح أن يجرب الفريق القانوني والمالي النموذجين على مستنداته قبل الاختيار.
أداء Claude Opus 5.5 في الاستدلال واستخدام الحاسوب
Humanity’s Last Exam هو مجموعة أسئلة على مستوى الدراسات العليا في العلوم والرياضيات والإنسانيات، صممت لتكون صعبة على النماذج الرائدة. سجل Claude Opus 5.5 67.7% مع الأدوات، مقابل 65.6% لـ Fable 5.1 و63.6% لـ Opus 5 و57.2% لـ GPT-6 Astra. وهذه نتيجة قوية في اختبار يعد من أصعب الاختبارات العامة. والفارق عن Fable 5.1 يبلغ نحو نقطتين فقط، وهذا يدعم قول أنثروبيك إن الفجوة بين النموذجين ضيقة.
في البحث العلمي الوكيل، سجل النموذج 58.7% في معيار Terminal-Bench-Science 0.1، وهو أعلى من Fable 5.1 (52.6%) ومن Opus 5 (29.0%). غير أن GPT-6 Astra تقدم عليه بنتيجة 64.6% كما أبلغت OpenAI. ويبلغ الخطأ المعياري في هذا المعيار بين 3.5 و5 نقاط، فالفارق مع Astra ليس قاطعا تماما. ومع ذلك، تبقى القفزة عن Opus 5 هي الخبر الأهم هنا، لأنها تقارب الضعف.
أما استخدام الحاسوب والرؤية فتبدو النتائج فيهما مستقرة. سجل النموذج 81.8% في OSWorld 2.1 بالوضع الجزئي، و89.0% في Chartography مع الأدوات. وكلتا النتيجتين فوق Fable 5.1 وفوق Opus 5. ويعني هذا أن Claude Opus 5.5 صالح لبناء وكلاء يتعاملون مع واجهات الحاسوب والمخططات الكثيفة. وننبه إلى أن النتائج الرسمية هنا بلا منافس من OpenAI، فلا نستطيع أن نحكم على الصدارة المطلقة في هذه المجالات.
كيف نقرأ أرقام كلود أوبوس 5.5 بحذر؟
أول حذر يأتي من أنثروبيك نفسها. فهي تقول إن الفجوة بين Opus 5.5 وFable 5.1 في استخدامها الفعلي أضيق مما توحي به الدرجات. وتذكر أن الأخطاء المعيارية ليست صغيرة، فهي 2.6 نقطة في Terminal-Bench 4.0 لنموذج Opus 5.5. كما أن بعض الأرقام تأتي بنتيجة الشركة لا بنتيجة طرف مستقل. ولذلك نعد الجدول السابق مؤشرا أوليا فقط. ويجب أن يتبعه اختبار على بياناتك ومهامك قبل أي قرار شراء أو ترحيل.
وجود قياسات مستقلة يساعد على الموازنة. فقد سجلت Artificial Analysis للنموذج 58 نقطة في مؤشر الذكاء عند max، وهي الأعلى في نتائجها بتاريخ 22 سبتمبر. لكنها قاست Terminal-Bench 4.0 عند 59.6%، وهو أقل من 66.4% التي أعلنتها أنثروبيك. والسبب غالبا اختلاف أدوات التشغيل والإعدادات. كما أن الأرقام المنشورة لنفس النموذج تختلف بين الشركات، فجدول Google مثلا يذكر 63.3% لـ Opus 5.5 في Terminal-Bench-Science مقابل 58.7% عند أنثروبيك.
وهناك شهادة ثالثة من جهة تقييم مستقلة. تنقل المصادر أن METR، التي اختبرت النموذج قبل الإطلاق، لم تجد تحسنا كبيرا على Fable 5.1 في مهارات الحكم التي فحصتها. وهذا لا يلغي مكاسب النموذج، لكنه يضع حدودا لها. والدرس العملي بسيط. اختر مجموعة صغيرة من مهامك الحقيقية، وشغلها على النموذجين عند مستويات جهد مختلفة، ثم قارن النتيجة والتكلفة وزمن الإنجاز. هذه الطريقة أصدق من أي جدول منشور، وهي ما يفعله الفريق الذي ننقل تجاربه في القسم التالي.
تجارب عملية موثقة مع Claude Opus 5.5
يحب القارئ أن يرى النموذج وهو يعمل قبل أن يصدق الأرقام. لذلك جمعنا في هذا القسم أربع تجارب موثقة مع Claude Opus 5.5، لكل منها مصدر منشور ورابط. اخترناها لأنها تغطي أنواعا مختلفة من العمل. الأولى في البرمجة والكتابة اليومية، والثانية في مهمة مكانية بها فخان خفيان، والثالثة في تحليل خلل برمجي حقيقي، والرابعة في مشاريع كبيرة طويلة.
التزمنا بثلاث قواعد عند الاختيار. أولا، يجب أن يكون المصدر منشورا وبتاريخ واضح. ثانيا، يجب أن يذكر المختبر طريقته وحدود تجربته. ثالثا، نفصل بين ما قاله أصحاب العلاقة وما قاسه طرف مستقل. وبهذا يستطيع القارئ أن يحكم بنفسه. فمثلا، تجربة Every ودراسة DataCamp من مواقع مستقلة، بينما اختبارات HAProxy وتحليل الاندماج من أنثروبيك نفسها، وسنصنفها بهذا الوضوح.
ولأن بعض هذه التجارب لم تنشر شيفرتها، كتبنا نحن الشيفرة المساعدة ونبهنا عليها بوضوح. فالكود الذي نشر أصلا في المصدر نذكره كما هو. أما الكود الذي كتبناه لإعادة التجربة أو التحقق منها فنصفه بأنه من إعدادنا. وهكذا تستطيع أن تشغل التجربة بنفسك على Claude Opus 5.5، وتقارن ما تحصل عليه بما نشره أصحابها. وفي القسم التالي بعد هذا نقدم لك ثلاثة اختبارات جاهزة لهذا الغرض.
تجربة فريق Every مع Claude Opus 5.5
اختبر فريق Every، وهو موقع متخصص في الذكاء الاصطناعي، النموذج لمدة سبعة أيام داخل Claude Code وتطبيق Claude لسطح المكتب. وشملت الاختبارات البرمجة والتصميم والكتابة والاستشارات. أعطى Kieran Klaassen نموذجي Fable 5.1 وOpus 5.5 مهمة Ruby نفسها. كتب Fable 26 سطرا عند المستوى العالي، بينما كتب Opus 14 سطرا عند xhigh. وتجنب الأخير التعليقات التوضيحية التي يحذفها Kieran من الأكواد المولدة. وقدر أن النموذج بلغ نحو 90% من قدرة Fable في البرمجة.
في اختبار الأداء لدى Kieran، عالج كود النموذج 427 طلبا في الثانية وحقق 17 من 20 حدا للزمن. أما كود GPT-6 Astra فكان أسرع بـ 463 طلبا، لكنه حقق 14 حدا فقط. وطلب Mike Taylor إضافة رفع الملفات إلى خادم MCP في تطبيق Rails. وبعد نحو ثماني دقائق أعاد النموذج رقعة من 251 سطرا في 17 ملفا، مقابل 171 سطرا في 14 ملفا في الحل البشري. ونجحت الرقعة في أربعة من خمسة فحوص آلية، وأخفقت في فحص حجم الرقعة فقط.
لكن التجربة كشفت عيوبا لا تقل أهمية. فعندما طلب Mike تطبيق نماذج صوتية، استهلك النموذج نحو 5.9 مليون رمز في 30 دقيقة، وخرجت الصفحات الأمامية نظيفة. غير أن شاشتي البناء والمقابلة أظهرتا أخطاء، ولم يستدع النموذج خدمة الذكاء الاصطناعي المطلوبة. وفي مهمة أخرى أعطاه Mike عشر دقائق لكتابة جدول لتدريب عميل، فأنتج مواد جانبية ونفد الوقت. نصيحة الفريق واضحة: استخدم Claude Opus 5.5 للميزات والنماذج الأولية، لكن اقرأ التعديلات وشغل التطبيق قبل أن تعده منتهيا.
تجربة DataCamp: اختبار الذراع الروبوتية مع Claude Opus 5.5
نشر Matt Crabtree في DataCamp بتاريخ 14 أكتوبر 2026 اختبارا عمليا فريدا. طلب من النموذج بناء صفحة واحدة تحرك ذراعا روبوتية من ثلاث وصلات لزيارة خمسة أهداف على مستوى فيه عوائق مستطيلة. لكل هدف أربع ثوان، ويجب ألا يلمس أي جزء من الذراع أي عائق، وأن تبقى أطوال الوصلات ثابتة. كما طلب قائمة حالة تذكر هل بلغت الذراع كل هدف. وخبأ في المشهد فخين لم يذكرهما الطلب: خط مستقيم بين الهدفين الثاني والثالث يمر عبر عائق، والهدف الرابع يقع خارج مدى الذراع.
شغل المؤلف الاختبار في أداة OpenCode بأدوات محددة، ومحاولة واحدة لكل نموذج. اعترف النموذجان بأن الهدف الرابع غير قابل للوصول. لكن ذراع Claude Opus 5.5 لم تلمس أي عائق، بينما اخترقت ذراع Gemini 4 Argon عائقا لاحقا. وبلغت درجة Opus 5.5 نحو 4.7 من 5 مقابل 3.7 لـ Argon. وكلف تشغيل Opus 5.5 دولارا و9 سنتات واستهلك 40,532 رمز إخراج. وفي المحاولة الأولى عند مستوى high، أنفق Argon ميزانية إخراجه كلها في التفكير ولم يكتب الملف أصلا.
ينبه المؤلف إلى أن هذه محاولة واحدة لمهمة واحدة عند المستوى المتوسط. ومع ذلك، تكمن قيمتها في تصميمها، فهي تختبر هل يحافظ النموذج على قيد واحد حتى نهاية التشغيل. ولتكرار التجربة على Claude Opus 5.5، كتبنا لك دالة تحقق من إعدادنا. تكشف الدالة الإطارات التي تلمس فيها الذراع عائقا، وتفحص هل الهدف داخل مدى الوصلات. الصق الطلب في النموذج، ثم مرر زوايا الإطارات التي يولدها إلى هذه الدالة.
import math

def arm_points(base, lengths, angles):
    """نقاط مفاصل الذراع. الزوايا نسبية بالراديان لكل وصلة."""
    x, y = base
    total = 0.0
    points = [(x, y)]
    for length, angle in zip(lengths, angles):
        total += angle
        x += length * math.cos(total)
        y += length * math.sin(total)
        points.append((x, y))
    return points

def segment_hits_rect(p, q, rect):
    """هل يتقاطع القطعة p-q مع المستطيل (xmin, ymin, xmax, ymax)؟ خوارزمية Liang-Barsky."""
    xmin, ymin, xmax, ymax = rect
    dx, dy = q[0] - p[0], q[1] - p[1]
    t0, t1 = 0.0, 1.0
    for pk, qk in ((-dx, p[0] - xmin), (dx, xmax - p[0]),
                   (-dy, p[1] - ymin), (dy, ymax - p[1])):
        if pk == 0:
            if qk < 0:
                return False
            continue
        t = qk / pk
        if pk < 0:
            t0 = max(t0, t)
        else:
            t1 = min(t1, t)
        if t0 > t1:
            return False
    return True

def target_is_reachable(base, target, lengths):
    """الهدف قابل للوصول إذا وقعت مسافته بين المدى الداخلي والخارجي للذراع."""
    outer = sum(lengths)
    inner = max(0.0, 2 * max(lengths) - outer)
    return inner <= math.dist(base, target) <= outer

def audit(frames, base, lengths, obstacles):
    """ترجع أرقام الإطارات التي لمست فيها الذراع عائقا."""
    bad = []
    for i, angles in enumerate(frames):
        pts = arm_points(base, lengths, angles)
        if any(segment_hits_rect(a, b, r) for a, b in zip(pts, pts[1:]) for r in obstacles):
            bad.append(i)
    return bad

# مثال تشغيل
base = (0.0, 0.0)
lengths = (120.0, 90.0, 60.0)
obstacles = [(100, -30, 160, 40)]

print(target_is_reachable(base, (400, 0), lengths))  # False: المسافة 400 أكبر من 270
frames = [[0.0, 0.0, 0.0], [0.5, -0.4, 0.2]]
print(audit(frames, base, lengths, obstacles))       # [0]: الإطار الأول يلمس العائق
تجربة تحليل خلل الفوترة بواسطة كلود أوبوس 5.5
تعرض صفحة إعلان أنثروبيك مقارنة جنبا إلى جنب بين Opus 5 وOpus 5.5 في شرح خلل برمجي. كان الطلب بسيطا، وهو أن يشرح النموذج سبب انخفاض إضافي في فاتورة عميل. وجد Claude Opus 5.5 أن تغيير الفئة المجانية يفسر 1.50 دولار فقط من الانخفاض. أما الباقي، وهو 9.92 دولارا، فسببه خطأ في تعديل برمجي وصف في رسالته بأنه لا يغير السلوك. وبدأ الرد بهذه الخلاصة في أول سطر، وهذا ما تقصده أنثروبيك بوضع المعلومة الأهم أولا.
تكمن المشكلة في إعادة هيكلة منطق الفترات. كان الكود القديم يستخدم فترة نصف مفتوحة تبدأ من أول الشهر وتنتهي قبل أول الشهر التالي. ثم نقل التعديل الشرط إلى دالة تحمل اسم Period.contains، وجعل نهاية الفترة هي آخر يوم محسوبا بطرح يوم من بداية الشهر التالي. لكن هذا الناتج توقيت عند منتصف ليل اليوم الأخير، لا اليوم كله. فصارت كل الأحداث بعد منتصف ليل 31 أغسطس خارج الفترة. ولم تنقل إلى سبتمبر، بل لم تحاسب أبدا.
الدرس هنا برمجي بقدر ما هو لغوي. فقد أشارت أنثروبيك إلى أن اختبارات التعديل لم تلتقط الخلل، لأنها فحصت التاريخ فقط ولم تفحص أي لحظة داخل اليوم الحادي والثلاثين. وهذا النوع من الأخطاء يمر في المراجعات اليومية بسهولة. ولتجربة الخلل بنفسك، كتبنا الشيفرة التالية. الجزء الأول منها مبني على الأسطر التي نشرتها أنثروبيك، أما التشغيل التجريبي في آخرها فمن إعدادنا لتوضيح النتيجة. اطلب من Claude Opus 5.5 تحليلها، وقارن شرحه بما سبق.
from datetime import datetime, timedelta, timezone

def next_month_start(year, month):
    if month == 12:
        return datetime(year + 1, 1, 1, tzinfo=timezone.utc)
    return datetime(year, month + 1, 1, tzinfo=timezone.utc)

def contains_buggy(year, month, ts):
    first_day = datetime(year, month, 1, tzinfo=timezone.utc)
    last_day = next_month_start(year, month) - timedelta(days=1)  # 31 أغسطس الساعة 00:00
    return first_day <= ts <= last_day  # الفترة مغلقة عند منتصف الليل

def contains_fixed(year, month, ts):
    start = datetime(year, month, 1, tzinfo=timezone.utc)
    return start <= ts < next_month_start(year, month)  # فترة نصف مفتوحة

event = datetime(2026, 8, 31, 14, 30, tzinfo=timezone.utc)
print(contains_buggy(2026, 8, event))   # False: الحدث يسقط من فاتورة أغسطس
print(contains_fixed(2026, 8, event))   # True
print(contains_fixed(2026, 9, event))   # False: ولا ينتقل إلى سبتمبر
تجارب أنثروبيك الداخلية مع Claude Opus 5.5
أجرت أنثروبيك اختبارا داخليا لنقل برنامج HAProxy من لغة C إلى Rust. وهو برنامج واسع الاستخدام لتوزيع حمل حركة الويب على الخوادم. ترجم Claude Opus 5.5 وFable 5.1 البرنامج، واجتاز كلا الناتجين تقريبا كل اختبارات الانحدار الخاصة بالبرنامج. لكن Opus 5.5 أنهى العمل في 9.5 ساعات مقابل 12 ساعة لـ Fable، وبتكلفة أقل بنسبة 51%. وهذه نتيجة تدعم ادعاء الكفاءة، لكنها تبقى اختبارا واحدا صممته الشركة نفسها.
وفي اختبار آخر للعمل المعرفي، طلبت أنثروبيك من Opus 5.5 وOpus 5 تحليل اندماج مقترح بين شركتين خياليتين لبرمجيات الموارد البشرية. بنى كل نموذج نموذجا ماليا في Excel، ثم حوله إلى عرض تنفيذي يحكم على جدوى الصفقة بسعرها. وصل النموذجان إلى الاستنتاج نفسه. لكن نموذج Opus 5.5 كان أكثر شمولا وعرضه أسهل قراءة، بينما احتوى عمل Opus 5 على أخطاء طفيفة. وأنهى Opus 5.5 العمل في 63 دقيقة مقابل 93، وبنصف التكلفة.
هذه التجارب مفيدة، لكنها أمثلة من مقدم الخدمة لا قياسات مستقلة. ويشير مقال في C# Corner إلى ذلك صراحة، ويقترح التعامل معها كحالات دراسة لا كنتائج متوقعة. والطريقة الأسلم هي بناء مجموعة مهام متكررة وقياس ستة أشياء: صحة النتيجة، ونتائج الاختبارات، واستخدام الأدوات، وإعادة العمل البشرية، وجهد المراجعة، وزمن الإنجاز. ثم تقارن Claude Opus 5.5 بنموذجك الحالي على هذه المقاييس، وتقرر اعتمادا على أرقامك أنت.
اختبر Claude Opus 5.5 بنفسك
أفضل طريقة لتصدق Claude Opus 5.5 هي أن تجربه بنفسك. لذلك جهزنا ثلاثة اختبارات تغطي الأنواع التي ناقشناها في القسم السابق. الأول مكاني وفيه فخان خفيان، وهو مأخوذ من فكرة اختبار DataCamp. والثاني تحليل خلل برمجي، ويستخدم شيفرة الفوترة التي عرضناها سابقا. والثالث اتباع تعليمات بالعربية. ولكل اختبار طريقة تحقق آلية، فلا تعتمد على انطباعك وحده.
شغل كل اختبار على مستويين على الأقل، وهما medium وhigh، وسجل الزمن والرموز والتكلفة. وتذكر أن max_tokens يغطي التفكير والنص معا، فاجعله كبيرا. استخدم دالة القياس التالية لتشغيل أي مطالبة على Claude Opus 5.5، وهي تحسب التكلفة من أسعار 4 و20 دولارا لكل مليون رمز. وإن جربت شيئا مختلفا، فشاركنا نتيجتك في التعليقات.
import time
import anthropic

client = anthropic.Anthropic()

def run(prompt, effort="medium", max_tokens=16000):
    """تشغل مطالبة على Claude Opus 5.5 وترجع النص والزمن والرموز والتكلفة."""
    start = time.time()
    response = client.messages.create(
        model="claude-opus-5-5",
        max_tokens=max_tokens,
        output_config={"effort": effort},
        messages=[{"role": "user", "content": prompt}],
    )
    seconds = time.time() - start
    text = next((b.text for b in response.content if b.type == "text"), "")
    usage = response.usage
    cost = (usage.input_tokens * 4 + usage.output_tokens * 20) / 1_000_000
    return {
        "text": text,
        "seconds": round(seconds, 1),
        "input_tokens": usage.input_tokens,
        "output_tokens": usage.output_tokens,
        "cost_usd": round(cost, 4),
        "stop_reason": response.stop_reason,
    }
الاختبار الأول: الذراع الروبوتية. الصق المطالبة التالية. تحتوي على فخين لم نذكرهما للنموذج: المسار المستقيم من الهدف الثاني إلى الثالث يمر عبر العائق، والهدف الرابع خارج مدى الذراع البالغ 270 وحدة. بعد التشغيل، مرر زوايا الإطارات التي ولدها الكود إلى دالة audit من القسم السابق.
ابن صفحة HTML واحدة بلا مكتبات وبلا اتصال بالشبكة.
تحرك الصفحة ذراعا روبوتية من ثلاث وصلات بأطوال ثابتة: 120 و90 و60.
قاعدة الذراع عند (0, 0). تزور الذراع خمسة أهداف بالترتيب.
خصص لكل هدف 4 ثوان: 3 ثوان للحركة وثانية للتوقف.
الأهداف: (150, 100) ثم (60, -60) ثم (220, 60) ثم (400, 0) ثم (80, 150).
في المستوى عائق مستطيل من (100, -30) إلى (160, 40).
يجب ألا يلمس أي جزء من الذراع العائق في أي لحظة.
اعرض قائمة حالة تذكر هل وصلت قمة الذراع فعلا إلى كل هدف.
الاختبار الثاني: خلل الفوترة. أعط النموذج شيفرة contains_buggy من القسم السابق، واطلب منه بهذه الصيغة: اشرح لي لماذا يسقط حدث 31 أغسطس الساعة 14:30 من فاتورة أغسطس، واقترح إصلاحا. ثم شغل الإصلاح الذي يقترحه على الأمثلة الثلاثة. والمعيار هنا أن يبدأ الرد بالسبب الحقيقي، وأن ينجح الإصلاح في الحالات الثلاث.
الاختبار الثالث: اتباع التعليمات بالعربية. ننبه إلى أن الأمثلة الرسمية من أنثروبيك بالإنجليزية، فهذا الاختبار يقيس العربية تحديدا. الصق المطالبة التالية، ثم مرر الناتج إلى دالة check_briefing.
اكتب إحاطة قصيرة لموظف جديد في شركة خيالية عن تأهيل العملاء الجدد.
يجب أن تتكون الإحاطة من أربع فقرات بالضبط.
يجب أن تبدأ الفقرة الثانية بكلمة "تاريخيا".
يجب أن يكون إجمالي الكلمات بين 200 و240 كلمة.
لا تستخدم نقاطا ولا عناوين.
اختم بسطر واحد منفصل بسطر فارغ، ويجب أن يكون سؤالا.
import re
def check_briefing(text):
paragraphs = [p.strip() for p in text.strip().split("\n\n") if p.strip()]
closing = paragraphs[-1] if paragraphs else ""
body = paragraphs[:-1]
words = len(text.split())
return {
"4 فقرات بالضبط": len(body) == 4,
"الفقرة الثانية تبدأ بتاريخيا": len(body) > 1 and body[1].startswith("تاريخيا"),
"عدد الكلمات بين 200 و240": 200 <= words <= 240,
"سطر الختام سؤال": closing.endswith(("؟", "?")),
"لا نقاط ولا عناوين": not re.search(r"^\s*([-*•]|\d+[.)]|#)", text, re.M),
}
result = run(open("prompt.txt", encoding="utf-8").read(), effort="medium")
print(check_briefing(result["text"]))
print(result["seconds"], result["output_tokens"], result["cost_usd"])| ما تسجله | كيف تقيسه |
|---|---|
| مستوى الجهد | قيمة effort في كل تشغيل: medium ثم high |
| الزمن | الحقل seconds في نتيجة دالة run |
| الرموز | input_tokens وoutput_tokens، وتشمل رموز الإخراج التفكير |
| التكلفة | الحقل cost_usd بسعر 4 و20 دولارا لكل مليون رمز |
| صحة النتيجة | دالة audit للذراع، وتشغيل الإصلاح للفوترة، ودالة check_briefing للعربية |
| سبب التوقف | الحقل stop_reason: إن ظهر max_tokens فارفع الحد وأعد التشغيل |
التغييرات الجذرية عند الانتقال إلى Claude Opus 5.5
تنطبق هذه التغييرات على Messages API. وإذا كنت تستخدم Claude Managed Agents فلا تحتاج إلى تغيير سوى اسم النموذج، وفق دليل الترحيل الرسمي. أما إذا كان لديك مشروع كامل، فيقدم Claude Code أمرا يتولى الترحيل نيابة عنك، وهو /claude-api migrate this project to claude-opus-5-5. جرب هذا الأمر على فرع تجريبي أولا. فالأتمتة تسرع العمل، لكن مراجعة التعديلات تبقى مسؤوليتك، خصوصا عند الانتقال إلى Claude Opus 5.5 من نماذج أقدم من Opus 5.
يمكن تقسيم التغييرات إلى نوعين. النوع الأول هو طلبات ترفضها الواجهة بخطأ 400، مثل تعطيل التفكير والاستخدام الإجباري للأدوات. والنوع الثاني هو تغييرات في شكل الرد، مثل ظهور كتل التفكير في بداية كل رد. وتختلف قائمة ما تحتاجه بحسب النموذج الذي تنتقل منه. فمن Opus 5 تحتاج إلى أقل التغييرات، ومن Opus 4.6 أو أقدم تحتاج إلى أكثرها. يلخص الجدول التالي أهم النقاط، ثم نشرح الأصعب منها بالأكواد.
| التغيير | سلوك Claude Opus 5.5 | الإجراء المطلوب |
|---|---|---|
| تعطيل التفكير | thinking بنوع disabled أو enabled مع budget_tokens يعيد خطأ 400 | احذف الحقل واستخدم output_config.effort |
| الاستخدام الإجباري للأدوات | tool_choice بنوع any أو tool يعيد خطأ 400 | استخدم auto مع strict: true |
| معاملات أخذ العينات | temperature وtop_p وtop_k يجب حذفها | احذفها وعدل المطالبة بدلا منها |
| التعبئة المسبقة (Prefill) | إنهاء messages بدور مساعد مسبق يعيد خطأ 400 | استخدم المخرجات المهيكلة أو تعليمات النظام |
| أداة استخدام الحاسوب | computer_20251124 مرفوضة على Claude API وClaude Models on Google Cloud (Google managed) | استخدم computer_toolset_20260801، وتبقى القديمة تعمل على Bedrock |
| النص بين استدعاءات الأدوات | يعود داخل كتل thinking وتكون فارغة افتراضيا | اضبط thinking.display على summarized أو updates |
| مجزئ الكلمات | قد يستهلك حتى 35% رموزا أكثر مقارنة بما قبل Opus 4.7 | ارفع max_tokens وأعد قياس count_tokens |
| الطبقة ذات الأولوية (Priority Tier) | غير مدعومة | خطط السعة بشكل منفصل |
تعطيل التفكير غير مدعوم
الطلب الذي يحتوي على thinking: {"type": "disabled"} يعيد خطأ 400 في Claude Opus 5.5، وكذلك الطلب الذي يستخدم budget_tokens. فالتفكير التكيفي مفعل دائما ولا يوجد مفتاح لإيقافه. والحل بسيط. احذف حقل thinking كليا، أو أرسل {"type": "adaptive"} فهو مكافئ لحذفه. ثم تحكم في العمق عبر effort. وإذا كنت تعطل التفكير لتوفير الرموز، فاختر مستوى أقل مثل low، فهو الأقرب إلى ما كنت تريده.
ويتغير شكل الرد أيضا. فقد يبدأ كل رد بكتلة thinking أو أكثر قبل كتلة النص الأولى. لذلك ينكسر أي كود يقرأ الرد بالموضع مثل content[0].text. اقرأ الكتل بحسب حقل type دائما. كما أن max_tokens يغطي التفكير والنص معا، فارفعه إذا كان حملك يعمل بلا تفكير. ويوصي دليل الترحيل بالبدء من 64 ألف رمز عند xhigh أو max، ثم الضبط بحسب نتائجك.
أما الحقل thinking.display فيحدد ما يصلك من نص التفكير. قيمته الافتراضية omitted، فتصلك الكتلة بحقل thinking فارغ مع التوقيع فقط. اضبطه على summarized إذا كان منتجك يعرض تقدم التفكير للمستخدم، وإلا ظهر توقف طويل قبل بدء الرد. وتحسب رموز التفكير ضمن رموز الإخراج حتى لو لم يصلك نصها. يوضح المثال التالي الفرق بين الطلب القديم والجديد.
# قبل: يعمل على Opus 5 ويرفضه Claude Opus 5.5 بخطأ 400
client.messages.create(
    model="claude-opus-5",
    max_tokens=16000,
    thinking={"type": "disabled"},
    messages=[{"role": "user", "content": "..."}],
)

# بعد: التفكير مفعل دائما، والتحكم عبر effort
response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=16000,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "..."}],
)

# اقرأ النص بحسب النوع، لأن كتل thinking تأتي أولا
for block in response.content:
    if block.type == "text":
        print(block.text)
الاستخدام الإجباري للأدوات في Claude Opus 5.5
يرفض Claude Opus 5.5 الطلب الذي يستخدم tool_choice من النوع any أو tool، ويعيد خطأ 400. والمسموح هو auto، وهو الافتراضي، أو none. وينطبق هذا القيد على نقطة عد الرموز أيضا. لذلك تحتاج الأكواد التي تجبر النموذج على استدعاء أداة معينة إلى تعديل. وهذا من أكثر التغييرات إزعاجا في أنظمة الاستخراج، لأنها كانت تعتمد على الإجبار لضمان شكل المخرجات.
الحل الموصى به هو استخدام auto مع الاستخدام الصارم للأدوات (strict tool use) أو المخرجات المهيكلة. أضف strict: true إلى تعريف الأداة، وتأكد أن كل كائن في المخطط يضبط additionalProperties: false. فالاستخدام الصارم يقبل مجموعة جزئية من JSON Schema فقط، لذلك راجع مخططاتك قبل التفعيل. وبهذا يطابق كل استدعاء مخطط الأداة، حتى لو لم تجبر النموذج على استدعائها.
واذكر في المطالبة متى تنطبق الأداة، لأن اختيارها صار قرار النموذج. مثلا، أضف إلى الطلب جملة مثل: استخدم الأداة get_weather. وهذه الجملة القصيرة بديل الإجبار في أكواد كثيرة. ثم راقب نسبة الاستدعاءات الصحيحة على بياناتك قبل أن تنقل حركة الإنتاج إلى Claude Opus 5.5. ويعرض المثال التالي تعريف أداة صارمة وطلبا يستخدمها.
tools = [{
    "name": "get_weather",
    "description": "Get the current weather in a given location",
    "input_schema": {
        "type": "object",
        "properties": {
            "location": {
                "type": "string",
                "description": "The city and state, e.g. San Francisco, CA",
            }
        },
        "required": ["location"],
        "additionalProperties": False,
    },
    "strict": True,  # كل استدعاء يطابق المخطط
}]

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    tools=tools,
    tool_choice={"type": "auto"},  # الإجبار بنوع any أو tool مرفوض
    messages=[{
        "role": "user",
        "content": "What's the weather in Paris? Use the get_weather tool.",
    }],
)
كتل التفكير ونص التقدم في Claude Opus 5.5
ترتبط كتل التفكير بالنموذج الذي أنتجها وبالمحادثة نفسها. فعلى Claude API، لا يقرأ كتل Claude Opus 5.5 إلا Fable 5.1 وMythos 5.1. وإذا نقل موجه أو نظام احتياطي المحادثة إلى أي نموذج آخر، تعمل تلك الأدوار دون هذه الكتل. أما في الاتجاه المعاكس، فيقرأ Claude Opus 5.5 كتل Opus 5 وSonnet 5.5 وHaiku 5.5 على Claude API. ولا يقرأ كتل Fable أو Mythos. وهذا يؤثر في أي خطة احتياطية تبنيها بين النماذج.
أبق المحادثة إضافة فقط، فلا تعدل المطالبة النظامية أو الأدوات أو الرسائل السابقة في منتصفها. وتمرر الكتل بالشكل الذي وصلت به، حتى التي يكون حقل thinking فيها فارغا. فتعدل الواجهة أو إعادة ترتيبها أو حذف بعضها يعيد خطأ 400. وفي الحسابات التي أنشئت بعد 31 أغسطس 2026، يعيد الطلب الذي يعيد تشغيل كتلة تفكير بعد تعديل كهذا خطأ 400 أيضا. ولا تحتاج الأنظمة التي تضيف فقط إلى أي تغيير في الكود.
أما نص التقدم بين استدعاءات الأدوات، فقد انتقل. كان Opus 5 يعيد الملاحظات القصيرة بين الأدوات في كتل text. أما Claude Opus 5.5 فيعيدها في كتل thinking، بحد أقصى كتلة قبل كل استدعاء. وعند العرض الافتراضي تكون فارغة، فيصمت تطبيقك بين الأدوات دون أن يفشل أي طلب. لاستعادة التحديثات، اضبط thinking.display على updates (تجريبي) أو summarized، ثم اعرض كل كتلة غير فارغة قبل الأداة التالية. ويوضح الكود التالي حلقة كاملة.
# tools و run_tool معرفان في مشروعك
messages = [{"role": "user", "content": "افحص المستودع وأصلح الاختبارات الفاشلة."}]

while True:
    response = client.messages.create(
        model="claude-opus-5-5",
        max_tokens=64000,
        tools=tools,
        thinking={"type": "adaptive", "display": "summarized"},
        output_config={"effort": "xhigh"},
        messages=messages,
    )

    # مرر رد المساعد كما وصل، بما فيه كتل thinking، دون فلترة أو إعادة بناء
    messages.append({"role": "assistant", "content": response.content})

    for block in response.content:
        if block.type == "thinking" and block.thinking:
            print("تحديث:", block.thinking)  # اعرضه قبل تنفيذ الأداة التالية

    calls = [b for b in response.content if b.type == "tool_use"]
    if not calls:
        break

    results = [
        {"type": "tool_result", "tool_use_id": c.id, "content": run_tool(c)}
        for c in calls
    ]
    messages.append({"role": "user", "content": results})
أمثلة برمجية لاستخدام Claude Opus 5.5 عبر واجهة API
تجمع هذه الأمثلة ما سبق في أكواد قابلة للتشغيل. تحتاج أولا إلى مفتاح API من منصة Claude، وتخزينه في متغير البيئة ANTHROPIC_API_KEY. ثم ثبت المكتبة الرسمية بالأمر pip install anthropic. ويستخدم كل مثال المعرف claude-opus-5-5 بلا لاحقة تاريخ، فهو معرف ثابت. وتجد في مقالنا عن واجهة برمجة التطبيقات API شرحا لأساسيات الاتصال إن كنت مبتدئا.
ابدأ بالمثال الأول، وهو أبسط طلب صالح على Claude Opus 5.5. لاحظ أنه يحدد effort ولا يرسل حقل thinking، وأنه يقرأ النص بحسب نوع الكتلة. ثم انتقل إلى المثال الثاني للوضع السريع، والثالث لمعالجة الرفض، والرابع لقياس أثر المجزئ الجديد على تكلفتك. وننصح بتشغيل المثال الرابع على مطالباتك الفعلية قبل الترحيل، لأن الفرق قد يصل إلى 35% في عدد الرموز.
المثال الأول: طلب أساسي مع مستوى الجهد وملخص التفكير.
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=4096,
    thinking={"type": "adaptive", "display": "summarized"},
    output_config={"effort": "medium"},
    messages=[{
        "role": "user",
        "content": "Analyze the trade-offs between microservices and monolithic architectures",
    }],
)

for block in response.content:
    if block.type == "thinking" and block.thinking:
        print("ملخص التفكير:", block.thinking)
    elif block.type == "text":
        print(block.text)
المثال الثاني: الوضع السريع بطلب cURL. يكفي إضافة الحقل speed، ولا يحتاج Claude Opus 5.5 إلى رأس تجريبي. وتذكر أن سعره 8 و40 دولارا لكل مليون رمز.
curl https://api.anthropic.com/v1/messages \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-opus-5-5",
    "max_tokens": 4096,
    "speed": "fast",
    "output_config": {"effort": "medium"},
    "messages": [{"role": "user", "content": "لخص هذا الخطأ البرمجي في ثلاث جمل."}]
  }'
المثال الثالث: معالجة الرفض. قد يعيد Claude Opus 5.5 السبب stop_reason بقيمة refusal مع فئة في stop_details مثل cyber أو bio أو reasoning_extraction. فجهز مسارا بديلا، سواء بإعادة المحاولة أو بتحويل الطلب إلى نموذج آخر.
response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=4096,
    output_config={"effort": "high"},
    messages=[{"role": "user", "content": "..."}],
)

if response.stop_reason == "refusal":
    details = getattr(response, "stop_details", None)
    category = getattr(details, "category", "unknown")
    print("رفض الطلب، الفئة:", category)
    # هنا: أعد المحاولة بصياغة أخرى، أو حول الطلب إلى نموذج بديل
else:
    print(next((b.text for b in response.content if b.type == "text"), ""))
المثال الرابع: قياس عدد الرموز قبل الترحيل. تعيد نقطة العد رقما مختلفا لـ Claude Opus 5.5 عما كانت تعيده لنماذج Opus 4.6 وما قبلها، بسبب المجزئ الجديد.
curl https://api.anthropic.com/v1/messages/count_tokens \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-opus-5-5",
    "messages": [{"role": "user", "content": "الصق هنا إحدى مطالباتك الفعلية"}]
  }'
الأمان والضمانات في Claude Opus 5.5
يأتي Claude Opus 5.5 في ظل نقاش أوسع داخل أنثروبيك عن تنظيم وتيرة التقدم. فالشركة ترى أن مخاطر النماذج الحالية مفهومة ويمكن إدارتها، لكن مخاطر أكبر قد تظهر بسرعة مع ازدياد القدرات. ولذلك تعتمد على ثلاث ركائز: اختبارات محاذاة واسعة، وتقييم خارجي قبل الإطلاق من جهات مثل METR وFrontier Design، وضمانات تتناسب مع قدرات كل نموذج. وتفصل بطاقة النظام هذه الاختبارات بالكامل لمن يريد التعمق.
تهمك هذه الأمور عمليا إذا كنت ستشغل النموذج وكيلا يعمل ساعات دون إشراف. تقول أنثروبيك إن Claude Opus 5.5 أقل ميلا من النماذج الحديثة إلى اتخاذ إجراءات يصعب التراجع عنها، أو التصرف خارج الحدود المرسومة له. كما أنه أكثر مقاومة من Opus 5 لهجمات حقن المطالبات. ويعمل معه مصنف يفحص كل إجراء قبل تنفيذه، وصندوق عزل مفتوح المصدر. وهذه كلها طبقات حماية، وليست ضمانا مطلقا.
ومن الضروري أن نفرق بين ما قيس فعلا وما لم يقس. فقد وسعت أنثروبيك اختبارات المحاذاة لتشمل المهام الطويلة والمهام المستحيلة وسيناريوهات مبنية على حوادث حقيقية. لكنها تعترف بأن لهذه الاختبارات حدودا. وسنعرض في القسمين التاليين ما تقوله الشركة عن نتائج المحاذاة، ثم عن الضمانات التي تغير سلوك Claude Opus 5.5 في بعض الطلبات. وهذه الضمانات هي ما يجب أن يعرفه كل مطور قبل أن يعتمد النموذج في منتج حقيقي.
اختبارات المحاذاة وسلوك كلود أوبوس 5.5
الاختبار الرئيسي هو التدقيق السلوكي الآلي، وهو يقيس Claude عبر نحو ألفي سيناريو محاكى. سجل Claude Opus 5.5 فيه نتائج أفضل من أي نموذج Claude حديث في كل مقاييس السلوك غير المنضبط تقريبا. كما أنه الأقوى في معظم مقاييس الصدق. وتحسن النموذج في سلوكيات ساهمت في حوادث أمنية سابقة، مثل التفكير المنحاز، ومحاولة الهروب من صندوق العزل، واتخاذ إجراءات ضارة بعد الظن بأن البيئة محاكاة.
وأضافت أنثروبيك اختبارا جديدا يقيس ميل النموذج إلى تجاوز حدود الاحتواء. حاول Claude Opus 5.5 تجاوز الحدود بنسبة أقل بنحو 85% مقارنة بـ Opus 5 وClaude Mythos 5.1. وكانت كل محاولاته منخفضة الخطورة، وأبلغ هو عنها بنفسه. وهذا رقم مهم للفرق التي تشغل Claude دون مراقبة عبر مستودعاتها وأنظمتها. فالقدرة الخام وحدها لا تكفي، إذا كان الوكيل يتجاوز الحدود حين يعمل وحده.
لكن أنثروبيك صريحة في حدود هذه النتائج. فهي تقول إن بناء اختبارات تلتقط كل إخفاق قبل الإطلاق ما زال مشكلة غير محلولة. كما ترصد أن النموذج كثيرا ما يشك في أنه يخضع لاختبار، وهذا يصعب قياس سلوكه في الإعدادات الحقيقية المتنوعة. وتتوقع أن تزداد المشكلة مع نمو القدرات، ما لم يتقدم علم التفسير. لذلك تقرن الشركة عملها في المحاذاة بضمانات إضافية، وهذا ما ننتقل إليه الآن مع Claude Opus 5.5.
ضمانات الأمن السيبراني والأحياء والتقطير في Claude Opus 5.5
هذا أول نموذج من فئة Opus يصدر بضمانات من فئة Fable 5.1 في الأمن السيبراني والأحياء والتقطير. وفي الأمن السيبراني، تتيح الضمانات للمستخدمين اكتشاف الثغرات في أكوادهم وإصلاحها ضمن دورة التطوير المعتادة. لكن معظم مهام الأمن السيبراني تحول إلى Opus 4.8 بشكل شفاف. وللمتخصصين في الدفاع السيبراني، توسع أنثروبيك برنامج التحقق السيبراني بثلاث درجات من الوصول الموثوق. وهذا يهم كل من يعمل في مجال الأمن السيبراني.
وفي الأحياء، تقول أنثروبيك إن النموذج يتفوق على Opus 5 ويضاهي Claude Mythos 5.1 أو يتفوق عليه في مجالات كثيرة. وحقق تحسنا في اختبار طويل الأمد للتنبؤ بالجزيئات وتصميمها أجري مع شركة Dyno Therapeutics. ولذلك يعمل بنفس ضمانات Fable 5.1 البيولوجية. وللمؤسسات الموثوقة مثل المختبرات الأكاديمية وشركات الأدوية، فتحت الشركة برنامج التحقق لعلوم الحياة للوصول إلى ضمانات مناسبة لكامل نطاق العمل البيولوجي.
أما التقطير، فيعني استخدام آلاف الحسابات المزيفة لاستخراج قدرات النموذج على نطاق صناعي. وتقول أنثروبيك إنها كشفت أنشطة كهذه وعطلتها، كما في تقرير التهديدات لسبتمبر 2026. ويطلق Claude Opus 5.5 مع التفكير المحفوظ، وهو يمنع مستخدمي API من تعديل سياق Claude السابق لاستخراج استدلاله. وينطبق على الحسابات المنشأة في 31 أغسطس 2026 أو بعده. كما يتوفر النموذج مع خيار عدم الاحتفاظ بالبيانات، ومع علامات مائية للنص تتوافق مع قانون الذكاء الاصطناعي الأوروبي، ولا يعمل بوضع التفكير المعطل.
تسعير Claude Opus 5.5
يبلغ سعر Claude Opus 5.5 4 دولارات لكل مليون رمز إدخال و20 دولارا لكل مليون رمز إخراج. وهذا أقل بنسبة 20% من سعر Opus 5. أما قراءة الذاكرة المؤقتة فتكلف 0.20 دولار لكل مليون رمز، أي أقل بنسبة 60%. وهذا مهم لأن قراءة الذاكرة تشكل معظم تكلفة العمل البرمجي الوكيل. وتقول أنثروبيك إن اجتماع هذين العاملين مع استهلاك رموز أقل لكل مهمة يخفض التكلفة الفعلية بنحو 40% على أعباء العمل النموذجية. وتجد القائمة الكاملة في صفحة الأسعار الرسمية.
لكن حساب التكلفة الفعلية يحتاج إلى حذر. فالمجزئ الجديد قد يستهلك حتى 35% رموزا أكثر للنص نفسه مقارنة بنماذج ما قبل Opus 4.7. وتحسب رموز التفكير ضمن رموز الإخراج حتى لو لم يصلك نصها. وبالمقابل، يخفض معالج الدفعات السعر إلى النصف. ومثال بسيط: طلب من 10,000 رمز إدخال و2,000 رمز إخراج يكلف نحو 0.08 دولار بالسعر القياسي، قبل الذاكرة المؤقتة والدفعات. اقرأ الجدول التالي، ثم قس تكلفتك الفعلية بنقطة count_tokens.
| نوع الاستخدام | Claude Opus 5.5 | Claude Opus 5 |
|---|---|---|
| الإدخال القياسي | $4 / مليون رمز | $5 / مليون رمز |
| الإخراج القياسي | $20 / مليون رمز | $25 / مليون رمز |
| قراءة الذاكرة المؤقتة | $0.20 / مليون رمز | $0.50 / مليون رمز |
| كتابة الذاكرة المؤقتة (5 دقائق) | $5 / مليون رمز | $6.25 / مليون رمز |
| الوضع السريع (إدخال / إخراج) | $8 / $40 لكل مليون رمز | غير مذكور في المصدر |
| معالجة الدفعات | خصم 50% | غير مذكور في المصدر |
Claude Opus 5.5 مقابل Opus 5 وFable 5.1 وGPT-6 Astra
تحدد المقارنة موقع Claude Opus 5.5 فعليا في السوق. فهو يتفوق على Opus 5 في كل المعايير تقريبا، وبسعر أقل. ولذلك تنصح الوثائق الرسمية بالانتقال منه. أما Fable 5.1 فيبقى أقوى في أصعب المشكلات، لكنه يكلف 10 دولارات للإدخال و50 دولارا للإخراج. وفي الاستخدام اليومي، قدر Kieran Klaassen من فريق Every أن Opus 5.5 بلغ نحو 90% من قدرة Fable في البرمجة. وهذا يجعل Claude Opus 5.5 الخيار الافتراضي المنطقي لمعظم الفرق.
أما GPT-6 Astra من OpenAI فمنافس مباشر، وليس أدنى منه في كل شيء. فقد تقدم على Opus 5.5 في AutomationBench (41.4% مقابل 40.0%) وفي Terminal-Bench-Science (64.6% مقابل 58.7%). وفضله فريق Every في تحرير العناوين وترتيب الأفكار. وهناك أيضا Gemini 4 Argon من Google، الذي يتصدر معايير العمل المعرفي والسياق الطويل في جدول Google. وإن أردت خلفية عن نماذج Google، فراجع مراجعتنا لنموذج Gemini ودليل Google AI.
| المعيار | Claude Opus 5.5 | Opus 5 | Fable 5.1 | GPT-6 Astra |
|---|---|---|---|---|
| السعر لكل مليون رمز (إدخال / إخراج) | $4 / $20 | $5 / $25 | $10 / $50 | غير مدرج في مصادرنا |
| Terminal-Bench 4.0 | 66.4% | 52.3% | 55.8% | 57.9% |
| FrontierCode v1.1 | 54.4% | 48.0% | 50.3% | 53.3% |
| GDPval-AA v2.1 (Elo) | 1846 | 1708 | 1735 | 1542 |
| AutomationBench | 40.0% | 26.9% | 31.4% | 41.4% |
| الأنسب لـ | البرمجة الوكيلة الطويلة والعمل المعرفي بتكلفة معقولة | لا يوصى به، فالانتقال منه أفضل | أصعب المشكلات وما يجب أن ينجح من المحاولة الأولى | التحرير والعناوين والبحث العلمي الوكيل |
أين يتوفر Claude Opus 5.5 وكيف تبدأ
يتوفر Claude Opus 5.5 على جميع المنصات الرئيسية، ومنها Amazon Web Services وGoogle Cloud وMicrosoft Azure. وعلى منصة Claude يبدأ المطور بالمعرف claude-opus-5-5. كما يعمل داخل تطبيقات Claude وأداة Claude Code. وأعلنت أنثروبيك رفع حدود الاستخدام لكل خمس ساعات في خطط Pro وMax وTeam وEnterprise القائمة على المقاعد. لكن الطبقة ذات الأولوية (Priority Tier) غير مدعومة، فخطط سعتها بشكل منفصل.
للبدء، احصل على مفتاح API من منصة Claude، ثم جرب الأمثلة التي عرضناها في قسم الأمثلة البرمجية. أما إذا كنت تريد تجربة بلا كود، فافتح تطبيق Claude واختر النموذج. وإن كنت مطورا فيمكنك استخدامه داخل GitHub Copilot وCursor، كما ذكر موقع DataCamp. ومهما اخترت، ابدأ بمستوى جهد متوسط، ثم قس النتائج على مهامك قبل أن ترفعه.
- تطبيقات Claude: متاح لمشتركي Pro وMax وTeam وEnterprise.
- Claude Code: يدعم النموذج والوضع السريع، ويقدم أمر الترحيل التلقائي.
- Claude API: المعرف claude-opus-5-5 بلا لاحقة تاريخ.
- Amazon Bedrock: المعرف anthropic.claude-opus-5-5، وتبقى أداة الحاسوب القديمة تعمل هناك.
- Google Cloud وMicrosoft Foundry: استخدم معرف المنصة المذكور في صفحة التوفر الرسمية.
متى تستخدم Claude Opus 5.5 ومتى تختار غيره
الاختيار الصحيح يبدأ من نوع عملك، لا من ترتيب الجداول. فقد لخص فريق Every الدرس في جملة: النموذج الذي تستطيع التحدث إليه يستخدم، والذي لا تستطيع يلغى، مهما قالت الاختبارات. ولهذا يبرز Claude Opus 5.5 في العمل التفاعلي الطويل، حيث تراجع وتوجه وتبني على ما ينتجه. وهو أنسب لمن يريد قدرة قريبة من Fable بنصف السعر أو أقل. لكن لا يصلح لكل شيء.
وهناك عوامل أخرى تحسم القرار. فإن كان عملك أمنا سيبرانيا، فسيحول النموذج معظم مهامك إلى Opus 4.8، ما لم تنضم إلى برنامج التحقق. وإن كان لعملك موعد نهائي صارم، فاضبط نقاط فحص وميزانية رموز، لأن النموذج قد ينشغل بالإضافات. وإن كانت مهامك بسيطة ومتكررة فالنماذج الأصغر أنسب. وسنقسم الحالات إلى نوعين لتسهل المقارنة، ونبدأ بالحالات التي يتفوق فيها Claude Opus 5.5 بوضوح.
يساعدك تصميم المطالبات الجيد على تحسين نتائج النموذج في كل الحالات. فالتعليمات الواضحة، والأمثلة الخاصة بك، وحدود المهمة تقلل الإسراف في الرموز. وتوصي أنثروبيك بإعادة تقييم التعليمات التي كتبتها لنماذج سابقة، لأن بعضها لم يعد لازما. وهذا يوفر عليك تكلفة وزمنا، ويجعل ما تبنيه على Claude Opus 5.5 أكثر استقرارا.
حالات استخدام Claude Opus 5.5 القوية
تتركز نقاط قوة النموذج في المهام الطويلة والمتشعبة التي تحتاج صبرا وتتبعا. ويؤكد ذلك أن شهادات Clio وStripe وChicago Trading Company تتحدث عن جلسات تمتد ساعات أو ليال كاملة. كما يتفوق في الأعمال التي تحتاج حكما وتحليلا، لا مجرد تنفيذ. وتتفق على ذلك ملاحظات Every في اختبارات التخطيط والتفاوض.
وفي الاستخدام العملي، لا تنس أن تراجع ما ينتجه. فالنموذج قوي لكنه ليس معصوما، كما ظهر في تجربة تطبيق النماذج الصوتية. والقائمة التالية تلخص أفضل الحالات لـ Claude Opus 5.5 كما تظهر من المصادر الموثقة في هذا المقال.
- وكلاء البرمجة المستقلة: ترحيل المستودعات الكبيرة وتدقيقها، ومهام الطرفية الطويلة، وإعادة هيكلة عشرات الطلبات المتراكبة.
- البناء المرئي والنماذج الأولية: الواجهات والألعاب والمشاهد ثلاثية الأبعاد والأدوات الشخصية، وفق ملاحظات Every.
- العمل المعرفي التحليلي: التقارير المالية والبحث مع التحقق من الأرقام، وتحليل الاندماجات في Excel.
- مراجعة الأكواد: يلتقط الأخطاء حتى عند المستوى المنخفض، وفق شهادة Deloitte.
- الكتابة التعاونية بالإنجليزية: مسودات واضحة تقبل الملاحظات، مع التحقق من جودتها بالعربية أولا.
متى يكون كلود أوبوس أكثر مما تحتاج
لا يحتاج كل عمل إلى نموذج رائد. فإن كانت مهامك قصيرة ومتكررة، فنموذج أصغر يعطيك نتائج جيدة بجزء من التكلفة. يبلغ سعر Sonnet 5.5 دولارين للإدخال و10 دولارات للإخراج. ويبدأ سعر Haiku 5.5 من 0.10 دولار للإدخال. وتذكر أن Claude Opus 5.5 يفكر دائما، فيضيف زمنا وتكلفة حتى للطلب البسيط. وهذا يجعله مبالغا فيه للأسئلة السريعة.
كما أن هناك حالات يتفوق فيها غيره. فإذا كانت أصعب مشاكلك تحتاج إلى أعلى قدرة، ففضل Fable 5.1. وإذا كنت تحرر نصوصا وتبحث عن عناوين قوية، فقد تفيدك نماذج OpenAI. أما الأعمال التي لها موعد صارم فتحتاج إلى نقاط فحص. وتلخص القائمة التالية هذه الحالات.
- الأسئلة البسيطة والتصنيف: Haiku 5.5 أو Sonnet 5.5 أرخص وأسرع.
- الدردشة منخفضة زمن الاستجابة: التفكير المفعل دائما يضيف تأخيرا، وقد وصل زمن أول كلمة في أحد الاختبارات إلى نحو 22 ثانية عند المستوى المتوسط.
- أصعب المشكلات: Fable 5.1 أذكى، وهو ما فضله Mike Taylor في فريق Every للمسائل الكبيرة.
- الأمن السيبراني: تحول معظم المهام إلى Opus 4.8 ما لم تنضم إلى برنامج التحقق.
- المهام ذات الموعد الصارم: حدد ميزانية رموز ونقطة توقف، وإلا قد ينفد الوقت قبل تسليم المطلوب.
قائمة الترحيل إلى Claude Opus 5.5
تغيير المعرف إلى claude-opus-5-5 هو الجزء السهل من الترحيل. أما الأصعب فهو التحقق من أن مطالباتك وتعريفات أدواتك ومعالجة أخطائك تعمل بعد التغييرات الجذرية. وقد رتبنا لك القائمة التالية من دليل الترحيل الرسمي، بحيث تبدأ بما يكسر الطلبات ثم تنتقل إلى ما يحسن التكلفة. ويمكنك أيضا أن تترك Claude Code ينفذ الخطوات الأولى عنك.
اعمل على فرع تجريبي، وشغل مجموعة اختباراتك كاملة قبل أن تحول حركة الإنتاج إلى Claude Opus 5.5. وسجل التكلفة والزمن قبل التغيير وبعده على مطالباتك الفعلية، لأن المجزئ الجديد وقرارات التفكير تغير الأرقام. وإن كنت تنتقل من Opus 5 فمعظم البنود القادمة تكفيك. أما من Opus 4.6 وما قبله فستحتاج إلى مراجعة إضافية للصور والمجزئ والرؤوس التجريبية.
- حدث معرف النموذج إلى claude-opus-5-5.
- احذف thinking: disabled وأي budget_tokens، واختر مستوى effort بدلا منهما.
- اضبط effort صراحة، فالافتراضي medium وكان high في Opus 5.
- استبدل tool_choice من النوع any وtool بـ auto مع strict: true.
- احذف temperature وtop_p وtop_k، وأزل أي تعبئة مسبقة لدور المساعد.
- إن استخدمت الحاسوب على Claude API أو Google Cloud، فاعتمد computer_toolset_20260801.
- اقرأ الكتل بحسب type، ومرر كتل thinking دون تعديل في حلقات الأدوات.
- اضبط thinking.display على summarized أو updates إن كان منتجك يعرض التقدم.
- تعامل مع stop_reason: refusal وجهز مسارا بديلا أو نظاما احتياطيا.
- ارفع max_tokens إلى 64 ألفا على الأقل عند xhigh وmax، وأعد قياس التكلفة بنقطة count_tokens.
- راجع حدود الذاكرة المؤقتة (512 رمزا)، وخطط سعة الطبقة ذات الأولوية بشكل منفصل.
- شغل مجموعة الاختبارات الخاصة بك، ثم حول الحركة تدريجيا.
الأسئلة الشائعة حول Claude Opus 5.5
هل يمكن تعطيل التفكير في Claude Opus 5.5؟
لا، فالتفكير التكيفي مفعل دائما في Claude Opus 5.5. والطلب الذي يرسل thinking: {"type": "disabled"} يعيد خطأ 400. وقد ذكرت أنثروبيك ذلك صراحة في صفحة الجديد، وربطته بمتطلبات الامتثال للقانون الأوروبي ضمن إجراءات العلامات المائية.
البديل العملي هو خفض مستوى الجهد إلى low. فهذا المستوى يقلل التفكير والتكلفة معا، ومع ذلك التقط 72% من الأخطاء المعروفة في اختبار Deloitte. وارفع max_tokens لأن التفكير يحسب ضمن رموز الإخراج.
كم يوفر Claude Opus 5.5 مقارنة مع Opus 5؟
تقول أنثروبيك إن التكلفة أقل بنحو 40% على أعباء العمل النموذجية عند الإعدادات الافتراضية. ويأتي ذلك من خفض السعر بنسبة 20%، ومن استهلاك رموز أقل لكل مهمة. وقالت Optiver إن تكلفة بعض أعمالها انخفضت بين 40 و50%.
لكن رقمك أنت قد يختلف. فالمجزئ الجديد قد يضيف حتى 35% رموزا لنصوص ما قبل Opus 4.7، وتحسب رموز التفكير ضمن الإخراج. لذلك قس تكلفة مطالباتك الفعلية قبل أن تتعهد بأي ميزانية.
هل Claude Opus 5.5 أفضل من Fable 5.1؟
ليس في كل شيء. تقول أنثروبيك إن Claude Opus 5.5 يؤدي عند مستوى Fable 5.1 في معظم الأعمال، وإن الفجوة بينهما أضيق من الأرقام. وتفوق عليه في معايير مثل Terminal-Bench 4.0 وGDPval-AA وChartography في جدول الشركة.
لكن اختبارات المستخدمين تعطي صورة أدق. فقد اعتمده Kieran Klaassen يوميا بدل Fable، بينما ما زال Mike Taylor يفضل Fable للمشكلات الأكبر. فاختر بحسب مهمتك: Opus 5.5 للعمل اليومي بتكلفة أقل، وFable 5.1 للأصعب.
الخاتمة
يستحق Claude Opus 5.5 الترقية لمعظم من يستخدم Opus 5 أو أقدم. فهو أرخص وأسرع وأوضح في الكتابة، ويحقق نتائج قوية في البرمجة الوكيلة والعمل المعرفي. وتدعم ذلك أرقام الشركة وتجارب مستقلة مثل تجربة Every واختبار DataCamp. ولعل أهم ما يقدمه هذا الإصدار ليس القفزة في الدرجات، بل قدرته على إنجاز عمل طويل بتكلفة معقولة وبنتائج يمكن مراجعتها.
لكن الترقية ليست مجانية. فالتفكير مفعل دائما، والاستخدام الإجباري للأدوات مرفوض، وهناك تغييرات في شكل الرد وفي أداة الحاسوب. ومهام الأمن السيبراني تحول إلى نموذج آخر. كما أن القياسات المستقلة جاءت أحيانا أقل من أرقام الشركة، وجودة الكتابة بالعربية لم تقس رسميا. وهذه كلها أسباب كافية لتختبر النموذج على عملك قبل أن تعتمده.
خطوتك التالية بسيطة. شغل الاختبارات الثلاثة التي عرضناها في قسم اختبر Claude Opus 5.5 بنفسك، وابدأ بمستوى medium، وسجل الزمن والتكلفة والنتيجة. ثم طبق قائمة الترحيل على فرع تجريبي. وحين تنتقل إلى الإنتاج، جهز مسارا بديلا للرفض، وراقب استهلاك الرموز في الأسابيع الأولى. وهكذا تستفيد من النموذج دون مفاجآت في الفاتورة أو السلوك.
مقالة ذات صلة: Claude Fable 5، شرح شامل للمزايا والأداء والأسعار وربطه بواجهة API من أنثروبيك.