الذكاء الاصطناعي المحلي (Local AI): ما هو وكيف يعمل وكيف تثبته على جهازك

عندما يفكر أغلب المستخدمين في الذكاء الاصطناعي، فإن أول ما يتبادر إلى أذهانهم هو خدمة سحابية بعيدة تستقبل طلباتهم وتعالجها ثم ترسل النتائج عبر الإنترنت. لكن هذا التصور بدأ يتغير بسرعة مع انتشار الذكاء الاصطناعي المحلي، الذي يتيح تشغيل نماذج الذكاء الاصطناعي مباشرة على الحاسوب أو الهاتف أو الخادم، دون الحاجة إلى إرسال البيانات إلى خوادم خارجية مع كل طلب.
لكن ما هو الذكاء الاصطناعي المحلي؟ يعني المفهوم تشغيل نماذج الذكاء الاصطناعي على أجهزتك الخاصة، مثل أجهزة الكمبيوتر المكتبية والمحمولة والهواتف والخوادم. وبذلك، يمكن للمستخدم الحصول على تحكم أكبر في بياناته، وتقليل الاعتماد على الخدمات السحابية، وتشغيل النماذج دون اتصال بالإنترنت عند توفر المتطلبات اللازمة، مع الاستفادة من تطور مكونات الهارد وير وقدرات المعالجة المتاحة للمستخدم العادي.
ولا يعد هذا التحول مجرد اتجاه تقني مؤقت، بل يرتبط بتطور العتاد (Hardware) وكفاءة النماذج وتقنيات ضغطها، مما جعل تشغيل نماذج متقدمة محليا أكثر واقعية من أي وقت مضى. ومع ذلك، تختلف القدرة على تشغيل هذه النماذج حسب قوة المعالج ووحدة معالجة الرسومات والذاكرة وحجم النموذج، لذلك فإن اختيار البيئة المناسبة يمثل جزءا أساسيا من تجربة الذكاء الاصطناعي المحلي.
يجمع هذا الدليل بين الجانب النظري والتطبيقي لتقديم صورة واضحة عن هذا المجال، بدءا من مفهوم الذكاء الاصطناعي المحلي وكيف يعمل، ثم الفرق بين التشغيل المحلي والتشغيل السحابي من حيث الخصوصية والأداء والتكلفة، وصولا إلى تشغيل النماذج والأدوات المستخدمة لإدارتها. كما نستعرض أشهر النماذج والأدوات في عام 2026، مثل Ollama وLM Studio وOpen WebUI، إلى جانب الاستخدامات العملية في البرمجة وتحليل المستندات وإنشاء المحتوى والأمن السيبراني.
ما هو الذكاء الاصطناعي المحلي؟
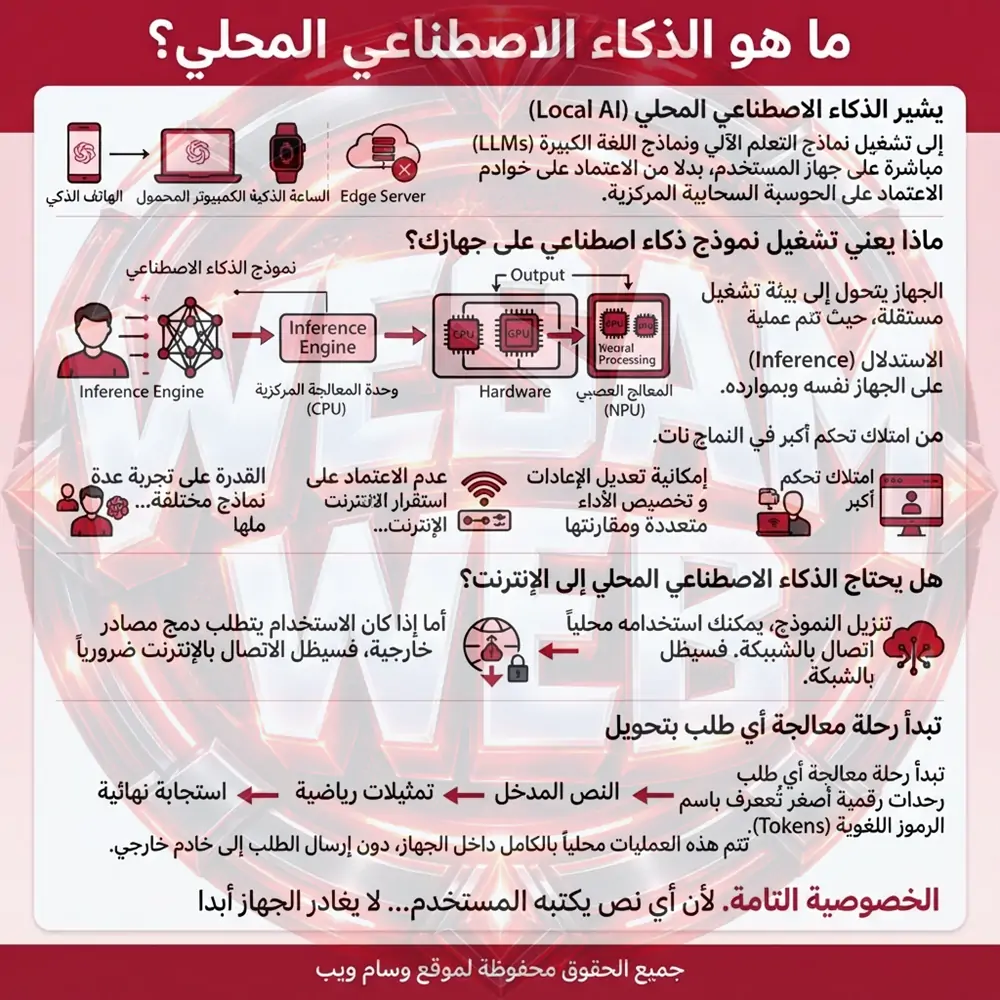
يشير الذكاء الاصطناعي المحلي (بالإنجليزية Local artificial intelligence وإختصار:Local AI)، إلى تشغيل نماذج التعلم الآلي ونماذج اللغة الكبيرة (LLMs) مباشرة على جهاز المستخدم، بدلا من الاعتماد على خوادم الحوسبة السحابية المركزية. ويمكن تنزيل وتشغيل نماذج وتطبيقات الذكاء الاصطناعي على أجهزة محلية، مثل الهواتف الذكية وأجهزة الكمبيوتر المحمولة والساعات الذكية وخوادم الحوسبة الطرفية، مما يتيح معالجة البيانات والتنبؤات في المكان الذي تنشأ فيه. وبذلك، تقل الحاجة إلى إرسال المعلومات إلى خوادم بعيدة، بينما تعتمد عملية التشغيل على مكونات جهازك مثل وحدة المعالجة المركزية (CPU) أو وحدة معالجة الرسوميات (GPU) لتنفيذ المهام.
وقد ساهمت التطورات الحديثة في أجهزة الحوسبة الطرفية (Edge Computing)، مثل المعالجات الأقوى وشرائح الذكاء الاصطناعي المتخصصة، في تمكين تشغيل نماذج أكثر تعقيدا محليا. كما يعزز هذا التوجه تزايد المخاوف بشأن خصوصية البيانات والرغبة في الحصول على تجارب ذكاء اصطناعي أسرع وأكثر موثوقية. ومع ذلك، تختلف قدرة كل جهاز على تشغيل النماذج بحسب قوة مكوناته وحجم النموذج وطريقة تشغيله، لذلك لا يمكن اعتبار جميع الأجهزة متساوية في الأداء.
بهذا المعنى، فإن عملية الاستدلال (Inference)، وهي المرحلة التي يقوم فيها النموذج بمعالجة المدخلات وتوليد الاستجابة، تتم داخل الجهاز نفسه عند استخدام نموذج محلي معد للعمل بصورة مستقلة. وهذا يجعل هذا النهج مختلفا جوهريا عن النماذج التي نتعامل معها يوميا عبر تطبيقات المحادثة السحابية، حيث تتم عملية الاستدلال عادة على خوادم مزود الخدمة ثم تصل النتيجة إلى جهاز المستخدم عبر الشبكة.
ولفهم هذا المفهوم بشكل أدق، من المفيد التمييز بين ثلاثة عناصر أساسية تشكل معا منظومة العمل المحلي، وهي النموذج نفسه بصيغته القابلة للتشغيل، ومحرك الاستدلال الذي يفسر بنية النموذج وينفذ العمليات الحسابية اللازمة، وأخيرا العتاد (Hardware) الذي يوفر القدرة الحسابية الفعلية لإتمام هذه العمليات في زمن معقول. وستتناول الأقسام التالية كل عنصر من هذه العناصر بتفصيل أكبر، بدءا من توضيح المقصود عمليا بتشغيل نموذج على جهاز شخصي.
ماذا يعني تشغيل نموذج ذكاء اصطناعي على جهازك؟
تعتمد فكرة هذا النهج على مبدأ بسيط لكنه عميق الأثر، وهو أن النموذج نفسه بأوزانه وبنيته الحسابية يتم توفيره محليا على جهاز المستخدم، ثم تتم معالجة الاستعلامات باستخدام موارد المعالج أو بطاقة الرسوميات أو معالجات الذكاء الاصطناعي المتوفرة. وفي بعض الحالات، يمكن تحميل النموذج بالكامل في ذاكرة الجهاز، بينما تستخدم بعض البيئات أساليب أخرى مثل تقسيم النموذج أو تحميل أجزاء منه وإسناد العمليات بين الذاكرة والمعالج ووحدة معالجة الرسوميات. وهذا يعني أن الجهاز يتحول إلى بيئة تشغيل مستقلة قادرة على أداء مهام معقدة مثل الإجابة عن الأسئلة وتلخيص النصوص وكتابة الأكواد البرمجية، دون اتصال خارجي أثناء الاستخدام المحلي، وهو ما يفتح الباب أمام استخدامات مهمة في البيئات المعزولة أو الحساسة أمنيا.
عندما يقوم مستخدم بتشغيل نموذج ذكاء اصطناعي على جهازه، فإنه في الواقع يقوم بتوفير ملف يحتوي على الأوزان المدربة للنموذج، وهي أرقام عددية ضخمة ناتجة عن عملية تدريب طويلة على كميات هائلة من البيانات. ثم يستخدم برنامجا وسيطا يعرف باسم محرك الاستدلال لتفسير هذه الأوزان وتنفيذ العمليات الحسابية المطلوبة لتحويل مدخلات المستخدم إلى استجابة. وقد يتراوح حجم ملف النموذج من بضع مئات من الميغابايت في النماذج الصغيرة إلى عشرات الغيغابايت أو أكثر في النماذج الأكبر، وهو ما يفسر التفاوت الكبير في متطلبات التشغيل بين نموذج وآخر.
من الناحية العملية، تشبه هذه العملية إلى حد بعيد تشغيل أي برنامج كثيف الموارد على الحاسوب، لكن مع فارق جوهري يتمثل في أن الحسابات المطلوبة هنا تعتمد بدرجة كبيرة على عمليات ضرب المصفوفات الرياضية بأعداد هائلة. وهي عمليات تتناسب بصورة جيدة مع طبيعة وحدات المعالجة المتوازية الموجودة في كروت الشاشة، ولهذا السبب يلاحظ المستخدمون فروقا كبيرة في سرعة الاستدلال بين جهاز يمتلك بطاقة رسوميات مخصصة وآخر يعتمد فقط على المعالج المركزي، حتى عند استخدام النموذج نفسه في الحالتين.
من أبرز الفوائد العملية لهذا النهج ما يلي:
- امتلاك تحكم أكبر في النموذج المستخدم، مع مراعاة شروط الترخيص التي يحددها مطور النموذج، ودون الارتباط الكامل بمزود خدمة سحابية واحد.
- إمكانية تعديل إعدادات النموذج وضبطها بدقة أكبر حسب طبيعة المهمة والموارد المتاحة على الجهاز.
- عدم الاعتماد على استقرار اتصال الإنترنت لإتمام المهام المحلية، متى كان النموذج والأدوات المطلوبة متاحة على الجهاز.
- القدرة على تجربة عدة نماذج مختلفة ومقارنة أدائها واختيار النموذج الأنسب بحسب المهمة والموارد المتوفرة.
هل يحتاج الذكاء الاصطناعي المحلي إلى الإنترنت؟
يظن كثير من المستخدمين الجدد أن أي تعامل مع الذكاء الاصطناعي AI يتطلب بالضرورة اتصالا دائما بالإنترنت، لكن هذا الافتراض غير دقيق عند الحديث عن التشغيل المحلي. فبعد تنزيل النموذج المطلوب وتثبيت البرنامج أو محرك الاستدلال اللازم، يمكن استخدام النموذج محليا دون اتصال بالشبكة، لأن عمليات المعالجة والاستدلال تتم باستخدام موارد الجهاز نفسه. ومع ذلك، يعتمد ذلك على طريقة إعداد التطبيق، إذ قد تتطلب بعض الوظائف الإضافية أو الخدمات المتصلة مصادر خارجية.
يقتصر الاحتياج إلى الإنترنت في كثير من سيناريوهات التشغيل المحلي على مراحل مثل تنزيل النموذج لأول مرة من مصدر موثوق، أو تنزيل البرنامج والتحديثات والمكونات اللازمة، ثم تحديث النموذج أو البرنامج المشغل له عند صدور إصدار جديد يحمل تحسينات في الأداء أو إصلاحات أمنية. وبعد ذلك، يمكن للمستخدم فصل الجهاز عن الشبكة والاستمرار في استخدام النموذج محليا، بشرط أن تكون جميع المكونات التي يحتاج إليها التطبيق متاحة على الجهاز. أما إذا كان الاستخدام يتطلب دمج النموذج المحلي مع مصادر بيانات خارجية أو خدمات سحابية أو واجهات برمجة تطبيقات، فسيظل الاتصال بالإنترنت ضروريا لهذه الوظائف.
هذه الخاصية بالتحديد هي ما يجعل هذا النهج خيارا مهما في بيئات العمل التي تفرض قيودا صارمة على الاتصال بالشبكات الخارجية، مثل بعض المؤسسات الحكومية والجهات البحثية التي تتعامل مع بيانات حساسة، أو حتى المسافرين الذين يحتاجون إلى أداة مساعدة موثوقة في مناطق ضعيفة التغطية. ومع ذلك، يبقى الاتصال بالإنترنت مفيدا وليس ضروريا في بعض السيناريوهات المتقدمة التي تتطلب دمج النموذج المحلي مع مصادر بيانات خارجية عبر واجهة برمجة التطبيقات (API)، وهو ما سيتم تناوله في أقسام لاحقة من هذا الدليل.
كيف تتم معالجة البيانات داخل الجهاز؟
تبدأ رحلة معالجة أي طلب يكتبه المستخدم بتحويل النص المدخل إلى وحدات رقمية أصغر تعرف باسم الرموز اللغوية (Tokens)، وهي الوحدات التي يتعامل معها النموذج بدلا من الكلمات بالطريقة التي نستخدمها في الكتابة اليومية. تمر هذه الرموز بعد ذلك عبر سلسلة من الطبقات العصبية الداخلية للنموذج، حيث يتم تحويلها إلى تمثيلات رياضية معقدة تساعد النموذج على التعامل مع السياق والعلاقات بين الرموز المختلفة في الجملة.
بعد اكتمال هذه المرحلة، يقوم النموذج بحساب احتمالات الرمز التالي بناء على السياق السابق، ثم يختار الرمز الذي يتوافق مع آلية التوليد وإعدادات النموذج المستخدمة. ويكرر هذه العملية رمزا تلو الآخر حتى تكتمل الاستجابة بالكامل. وتتم هذه العمليات محليا عند استخدام نموذج يعمل بصورة محلية، بدءا من تحويل النص إلى رموز ووصولا إلى توليد الاستجابة النهائية، دون إرسال بيانات الطلب إلى خادم خارجي ضمن مسار الاستدلال المحلي نفسه.
وهذا التصميم الداخلي هو ما يمنح الذكاء الاصطناعي المحلي ميزته الأساسية، إذ تنتقل عملية الاستدلال من البنية السحابية إلى موارد الجهاز نفسه، مما يمنح المستخدم تحكما أكبر في مكان معالجة بياناته وطريقة تشغيل النموذج. ومع ذلك، فإن مستوى الأداء يعتمد على مجموعة عوامل مترابطة، تشمل حجم النموذج، ودقة الأوزان، وسرعة الذاكرة، وقدرات المعالج ووحدة معالجة الرسوميات، وهي عوامل سنوضح تأثيرها بالتفصيل في الأقسام التالية.ساسية المتمثلة في الخصوصية التامة. لأن أي نص يكتبه المستخدم، مهما كان حساسا أو سريا. لا يغادر الجهاز أبدا في أي مرحلة من مراحل المعالجة. هذه النقطة بالذات تشكل الفارق الجوهري الذي سيتم توضيحه بتفصيل أكبر عند مقارنة هذا النهج بنظيره السحابي في القسم التالي.
ما الفرق بين الذكاء الاصطناعي المحلي والذكاء الاصطناعي السحابي؟
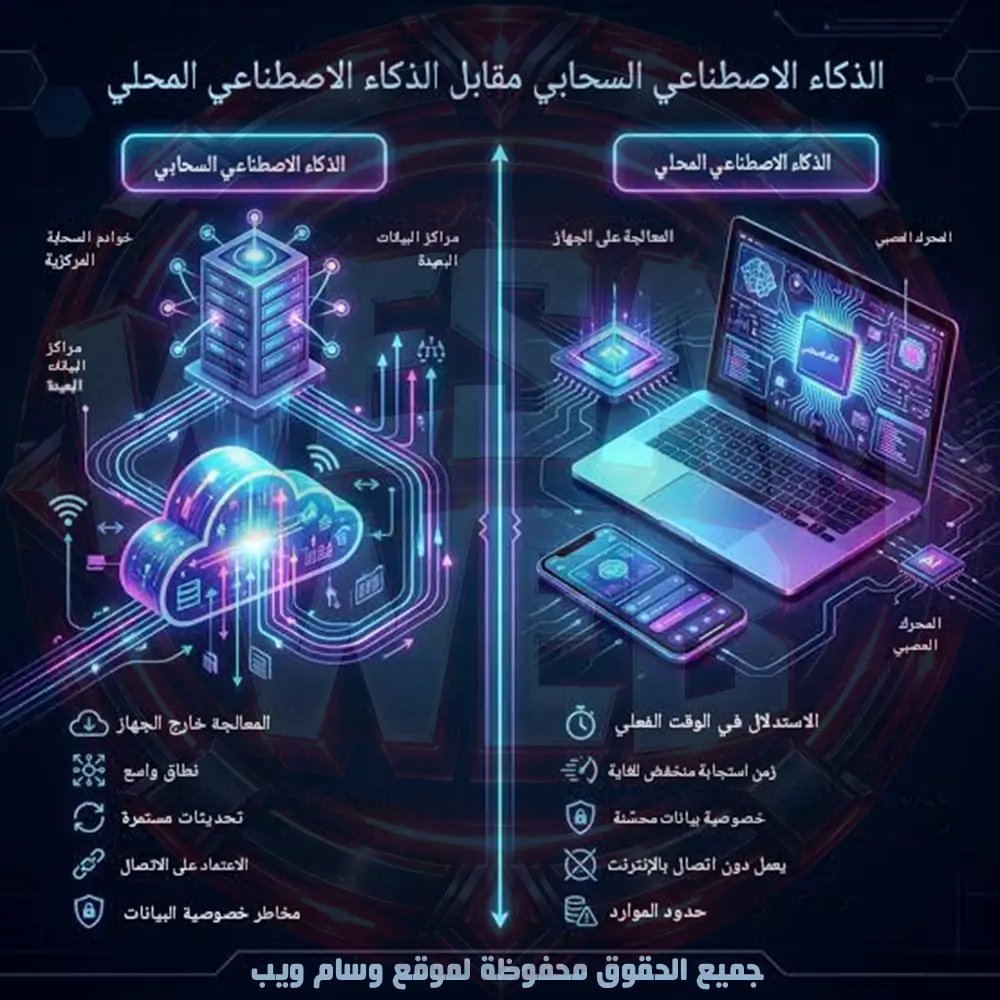
يكمن الفارق الجوهري بين النموذجين في موقع المعالجة والجهة التي توفر الموارد الحسابية المستخدمة. فبينما يعتمد الذكاء الاصطناعي السحابي على خوادم ضخمة تديرها شركات مثل OpenAI وجوجل وأنثروبيك لمعالجة طلبات المستخدم عبر الإنترنت، يقوم الذكاء الاصطناعي المحلي بمعالجة الطلبات باستخدام موارد الجهاز نفسه، مثل المعالج ووحدة معالجة الرسوميات أو وحدات معالجة الذكاء الاصطناعي. وينعكس هذا الاختلاف مباشرة على جوانب عملية متعددة، مثل الخصوصية والسرعة والتكلفة والقدرة على التخصيص. ويوضح الجدول التالي أبرز الفروقات بشكل مختصر ومباشر.
| وجه المقارنة | الذكاء الاصطناعي المحلي | الذكاء الاصطناعي السحابي |
|---|---|---|
| موقع المعالجة | داخل جهاز المستخدم أو بيئته المحلية | خوادم بعيدة تابعة لمزود الخدمة |
| الحاجة إلى الإنترنت | غير مطلوبة أثناء الاستخدام المحلي إذا كانت جميع المكونات متاحة على الجهاز | مطلوبة عادة للوصول إلى الخدمة السحابية |
| الخصوصية | يمكن إبقاء البيانات محليا، بحسب إعدادات البرنامج والوظائف المستخدمة | تنتقل البيانات إلى البنية التحتية لمزود الخدمة وفقا لطريقة تشغيل الخدمة وسياساتها |
| التكلفة | استثمار مبدئي في العتاد، ثم قد تكون تكلفة الاستخدام المباشر منخفضة | اشتراك أو دفع حسب الاستخدام، بحسب الخدمة |
| قوة النماذج المتاحة | تعتمد على إمكانيات الجهاز وحجم النموذج وطريقة تشغيله | إمكانية الوصول إلى نماذج ضخمة وبنية حسابية قوية |
| قابلية التخصيص | مرونة أكبر في اختيار النماذج وإعداد بيئة التشغيل | تختلف حسب الأدوات وواجهات البرمجة التي يوفرها المزود |
أين تتم معالجة البيانات في كل منهما؟
في حالة الذكاء الاصطناعي السحابي، يقوم المستخدم بكتابة طلبه عبر تطبيق أو متصفح، ثم يرسل هذا الطلب عبر الإنترنت إلى البنية التحتية الخاصة بمزود الخدمة. وهناك تتم معالجته باستخدام موارد حسابية قد تشمل مجموعات كبيرة من وحدات معالجة الرسوميات أو المسرعات المتخصصة، قبل إعادة إرسال الاستجابة إلى جهاز المستخدم عبر الشبكة. وتعني هذه العملية عمليا أن بيانات الطلب تنتقل إلى بنية تحتية خارج جهاز المستخدم، وتخضع طريقة التعامل معها لإعدادات الخدمة وسياسات مزودها.
أما في حالة الذكاء الاصطناعي المحلي، فيتم تنفيذ الاستدلال باستخدام موارد الجهاز أو البيئة المحلية التي تستضيف النموذج. وعند إعداد النظام للعمل بصورة محلية بالكامل، لا تحتاج بيانات الطلب إلى مغادرة هذه البيئة أثناء عملية الاستدلال نفسها. وهذا الفارق في موقع المعالجة ليس تفصيلا تقنيا بسيطا، بل يمثل الأساس الذي تنشأ عنه العديد من الاختلافات بين النهجين، بدءا من طريقة التعامل مع البيانات ووصولا إلى زمن الاستجابة ومتطلبات الاتصال بالإنترنت.
يترتب على هذا الاختلاف أيضا فارق مهم في طبيعة الاعتماد على مزود الخدمة. ففي النموذج السحابي، يعتمد المستخدم على توافر الخدمة والبنية التحتية وسياسات المزود، وقد يتأثر الاستخدام بتغييرات الأسعار أو حدود الاستخدام أو تحديثات الخدمة. أما في النموذج المحلي، فيمتلك المستخدم سيطرة أكبر على بيئة التشغيل والنموذج والبيانات، لكنه يتحمل في المقابل مسؤولية إدارة العتاد والبرامج والتحديثات والصيانة.
أيهما أفضل من حيث الخصوصية والسرعة والتكلفة؟
| المعيار | الأنسب في ظروف معينة | التوضيح |
|---|---|---|
| الخصوصية | الذكاء الاصطناعي المحلي عند ضبطه للعمل محليا | يمكن إبقاء البيانات داخل الجهاز، لكن ذلك يعتمد على البرنامج والإضافات والخدمات المستخدمة |
| السرعة في المهام البسيطة | قد يكون المحلي مناسبا على عتاد قوي | لا توجد رحلة بيانات عبر الشبكة، لكن الأداء يعتمد على العتاد والنموذج |
| السرعة في المهام المعقدة | قد يكون السحابي أسرع في بعض الحالات | يستطيع الاستفادة من بنية حسابية ضخمة ونماذج أكبر، لكن زمن الاستجابة يتأثر أيضا بالشبكة والخدمة |
| التكلفة على المدى الطويل | تعتمد على نمط الاستخدام | قد يقلل التشغيل المحلي تكاليف الاستخدام المتكرر، لكن استهلاك الكهرباء وتكلفة العتاد والتحديثات يجب احتسابها |
| التكلفة على المدى القصير | الذكاء الاصطناعي السحابي غالبا أسهل للبدء | لا يحتاج المستخدم إلى شراء عتاد قوي مسبقا، وقد تتوفر خطط مجانية أو منخفضة التكلفة بحسب الخدمة |
| سهولة البدء | الذكاء الاصطناعي السحابي | يمكن البدء عادة بإنشاء حساب واستخدام الخدمة دون إعداد نموذج وبيئة تشغيل محلية |
لماذا تستخدم الذكاء الاصطناعي المحلي بدلا من الخدمات السحابية؟
تتعدد الدوافع التي تجعل عددا متزايدا من المطورين والشركات والمستخدمين الأفراد يتجهون نحو التشغيل المحلي بدلا من الاعتماد الكامل على الخدمات السحابية الجاهزة. ومن أبرز هذه الدوافع الرغبة في زيادة السيطرة على البيانات وتقليل اعتمادها على البنية التحتية الخارجية. وتصبح هذه النقطة مهمة بشكل خاص عند التعامل مع معلومات حساسة أو بيانات داخلية لا يرغب المستخدم في إرسالها إلى خدمة خارجية. إضافة إلى ذلك، قد يكون تشغيل نموذج محلي مناسبا للمستخدمين الذين يتعاملون مع عدد كبير من الطلبات، خصوصا عندما يمتلكون عتادا مناسبا ويريدون تقليل الاعتماد على رسوم الاستخدام المتكررة.
ومن الدوافع المهمة أيضا الرغبة في الاستقلالية التشغيلية، بحيث لا يتوقف العمل المحلي بسبب انقطاع الإنترنت أو تعطل خدمة سحابية. كما يمنح التشغيل المحلي المطورين والمستخدمين المتقدمين مساحة أكبر لتجربة النماذج وإعداداتها وبيئة تشغيلها، بما يتوافق مع الإمكانيات المتاحة لديهم. ومع ذلك، فإن هذه الاستقلالية تأتي مقابل مسؤولية أكبر عن إدارة النظام والموارد والتحديثات والتوافق بين مكونات البيئة المحلية.
وتتلخص أبرز الدوافع العملية فيما يلي:
- حماية البيانات الحساسة من مغادرة البيئة المحلية عند استخدام نظام مضبوط للعمل محليا.
- تقليل الاعتماد على التكاليف المتكررة لبعض الخدمات السحابية، خصوصا مع الاستخدام المكثف.
- ضمان استمرار بعض مهام الذكاء الاصطناعي حتى عند انقطاع الإنترنت أو عدم توفر الخدمة السحابية.
- إمكانية التخصيص العميق للنموذج وبيئة التشغيل وفقا لاحتياجات المستخدم.
- تقليل الاعتماد على مزود خارجي واحد في المهام التي يمكن تنفيذها محليا.
هل الذكاء الاصطناعي المحلي أكثر خصوصية؟
يمكن أن يوفر الذكاء الاصطناعي المحلي مستوى أعلى من الخصوصية عندما يكون النموذج وجميع مكونات المعالجة المطلوبة تعمل داخل الجهاز أو البيئة المحلية، ولا توجد وظائف ترسل البيانات إلى خدمات خارجية. ففي هذه الحالة، لا تحتاج بيانات الطلب إلى الانتقال إلى سيرفر بعيد أثناء عملية الاستدلال المحلي نفسها. وتصبح هذه الميزة مهمة عند التعامل مع بيانات حساسة، مثل المستندات الداخلية والعقود والبيانات المالية والمعلومات المهنية، حيث يمكن تقليل نقاط خروج البيانات خارج البيئة التي يسيطر عليها المستخدم.
ومع ذلك، لا ينبغي اعتبار التشغيل المحلي ضمانا تلقائيا للخصوصية. فقد يحتوي البرنامج المستخدم على وظائف اتصال أو تحليلات أو تحديثات أو إضافات خارجية، كما قد يعتمد بعض المستخدمين على خدمات سحابية إضافية، مثل البحث عبر الإنترنت أو واجهات برمجة التطبيقات. لذلك، فإن مستوى الخصوصية الفعلي يعتمد على طريقة إعداد البيئة المحلية، والبرنامج المستخدم، ومصدر النموذج، والوظائف التي يتم تفعيلها.
ومن زاوية أخرى، يمنح التشغيل المحلي المستخدم سيطرة أكبر على مكان معالجة بياناته، بدلا من الاعتماد على سياسات مزود خدمة خارجي. وهذا يقلل من المخاطر المرتبطة بنقل البيانات إلى خدمات خارجية، لكنه لا يلغي مسؤولية المستخدم عن تأمين الجهاز نفسه وحماية الملفات والنماذج وبيئة التشغيل من الوصول غير المصرح به.
هل يمكن استخدامه دون اتصال بالإنترنت؟
نعم، ويعتبر هذا أحد الجوانب العملية المهمة التي تميز الذكاء الاصطناعي المحلي عن الخدمات السحابية. فبعد تنزيل النموذج وتثبيت البرنامج أو محرك الاستدلال وجميع المكونات المطلوبة، يمكن تشغيل النموذج محليا دون اتصال بالإنترنت، بشرط ألا تعتمد الوظيفة المستخدمة على خدمة خارجية. وهذا يجعله مفيدا أثناء السفر، أو العمل في مواقع ضعيفة التغطية، أو في البيئات التي تفرض قيودا على الاتصال بالشبكات الخارجية.
وتصبح هذه الخاصية مناسبة بشكل خاص للعاملين في المواقع الصناعية والحقول والمناطق النائية، وكذلك للباحثين الميدانيين والمسافرين الذين يحتاجون إلى أدوات ذكاء اصطناعي متاحة دون اتصال مستمر بالشبكة. وحتى في البيئات المكتبية العادية، يمكن أن يوفر التشغيل المحلي طبقة إضافية من الاستقلالية في حال حدوث انقطاع مؤقت في الإنترنت أو عدم توفر الخدمة السحابية.
تجدر الإشارة إلى أن بعض الوظائف الإضافية، مثل البحث في الإنترنت وتحديث النموذج وتنزيل مكتبات جديدة أو استخدام واجهات برمجة التطبيقات (APIs)، تحتاج إلى اتصال بالشبكة. لكن هذه الوظائف منفصلة عن عملية الاستدلال المحلي الأساسية، ولذلك يمكن للنموذج نفسه الاستمرار في توليد الردود دون اتصال خارجي عندما تكون البيئة مجهزة بالكامل للعمل محليا.
ما أهم مزايا وعيوب تشغيل النماذج محليا؟
من أبرز مزايا هذا النهج:
- خصوصية أعلى للبيانات عند تشغيل جميع مكونات المعالجة محليا وعدم استخدام خدمات خارجية.
- استقلالية أكبر عن الإنترنت والخدمات السحابية أثناء تنفيذ المهام المحلية.
- إمكانية تقليل التكاليف المتكررة لبعض أنماط الاستخدام بعد توفير العتاد المناسب.
- حرية أكبر في اختيار النماذج وإعداد بيئة التشغيل وتعديل إعداداتها وفقا للموارد المتاحة.
ومن أبرز العيوب التي يجب أخذها بعين الاعتبار:
- قد ترتفع التكلفة الفعلية عند احتساب شراء العتاد واستهلاك الكهرباء والترقية والصيانة، لذلك لا يكون التشغيل المحلي أرخص تلقائيا في جميع سيناريوهات الاستخدام.
- الحاجة إلى عتاد مناسب للحصول على أداء جيد، خصوصا مع النماذج الكبيرة.
- صعوبة نسبية في الإعداد الأولي وإدارة النماذج مقارنة باستخدام خدمة سحابية جاهزة.
- قدرات محدودة في بعض الحالات مقارنة بأضخم النماذج والخدمات السحابية، خصوصا على الأجهزة ذات الموارد المحدودة.
- مسؤولية التحديثات والصيانة وتأمين البيئة المحلية تقع بدرجة أكبر على عاتق المستخدم.
ماذا يعني الذكاء الاصطناعي المحلي على جهازك؟
يشير الذكاء الاصطناعي المحلي إلى أي نظام ذكاء اصطناعي يعمل بالكامل على عتاد محلي تملكه وتتحكم به فعليا، بدلا من الاعتماد على خدمات سحابية. ويشمل هذا المصطلح طائفة واسعة من القدرات:
- نماذج اللغة الكبيرة للمحادثة والكتابة والبرمجة والاستدلال والتحليل
- نماذج رؤية لفهم الصور والتعرف الضوئي والإجابة على الأسئلة البصرية
- نماذج توليد الصور مثل Stable Diffusion لإنشاء الأعمال الفنية والرسومات
- نماذج التضمين للبحث الدلالي والتوليد المعزز بالاسترجاع والتصنيف
- نماذج الصوت للتحويل من الكلام إلى نص Whisper وتوليف النص إلى كلام
- نماذج الأكواد المضبوطة بدقة لمهام البرمجة وإكمال الكود وتصحيح الأخطاء
السمة الجوهرية التي تميز الذكاء الاصطناعي المحلي هي محلية البيانات. فعندما تكتب طلبا في ChatGPT، ينتقل نصك عبر الإنترنت إلى خوادم OpenAI، حيث تتم معالجته هناك ثم تعود الاستجابة. أما مع الذكاء الاصطناعي المحلي، فإن أوزان النموذج تعيش على جهازك، ويتم الاستدلال على المعالج أو بطاقة الرسوميات، ولا تلمس البيانات أي شبكة خارجية. هذا التمييز له آثار عميقة على الخصوصية والتكلفة وزمن الاستجابة والتحكم.
يسمى الذكاء الاصطناعي المحلي أحيانا بـ on-device AI أو on-premise AI أو edge AI أو self-hosted AI. ورغم وجود فروق دقيقة بين هذه المصطلحات، حيث يشير edge AI غالبا إلى إنترنت الأشياء والأجهزة المدمجة، بينما يعني on-premise عادة خوادم المؤسسات، إلا أنها جميعا تشترك في مبدأ واحد: الذكاء الاصطناعي يعمل حيث أنت، وليس في سحابة شخص آخر.
كيف صعدت نماذج الأوزان بهذه السرعة والكفاءة؟
أصبح الذكاء الاصطناعي المحلي عمليا بفضل ثورة النماذج مفتوحة الأوزان. في فبراير 2023، أطلقت Meta نموذج LLaMA، وخلال أسابيع تمكن المجتمع من تشغيله على عتاد استهلاكي. ومنذ ذلك الحين، كان الإيقاع متواصلا:
- Meta Llama 3.2 (2024-2025): متاح بأحجام 1B و3B و8B و70B و405B، مع إصدارات متعددة الوسائط. نموذج 8B ينافس GPT-3.5 في معظم المهام.
- DeepSeek-R1 (2025): نموذج يركز على الاستدلال، ويضاهي GPT-4 في الرياضيات والبرمجة والمنطق.
- Mistral وMixtral: نماذج كفؤة بقدرات متعددة اللغات قوية، مع معماريات مزيج الخبراء.
- Google Gemma 2: نماذج مدمجة وعالية الجودة بأحجام 2B و9B و27B.
- Microsoft Phi-3/Phi-4: نماذج لغة صغيرة، تحقق نتائج قوية عند 3.8B و14B.
- Qwen 2.5: عائلة شاملة من علي بابا، تغطي اللغة والكود والرياضيات والرؤية.
كيف يعمل الذكاء الاصطناعي المحلي؟
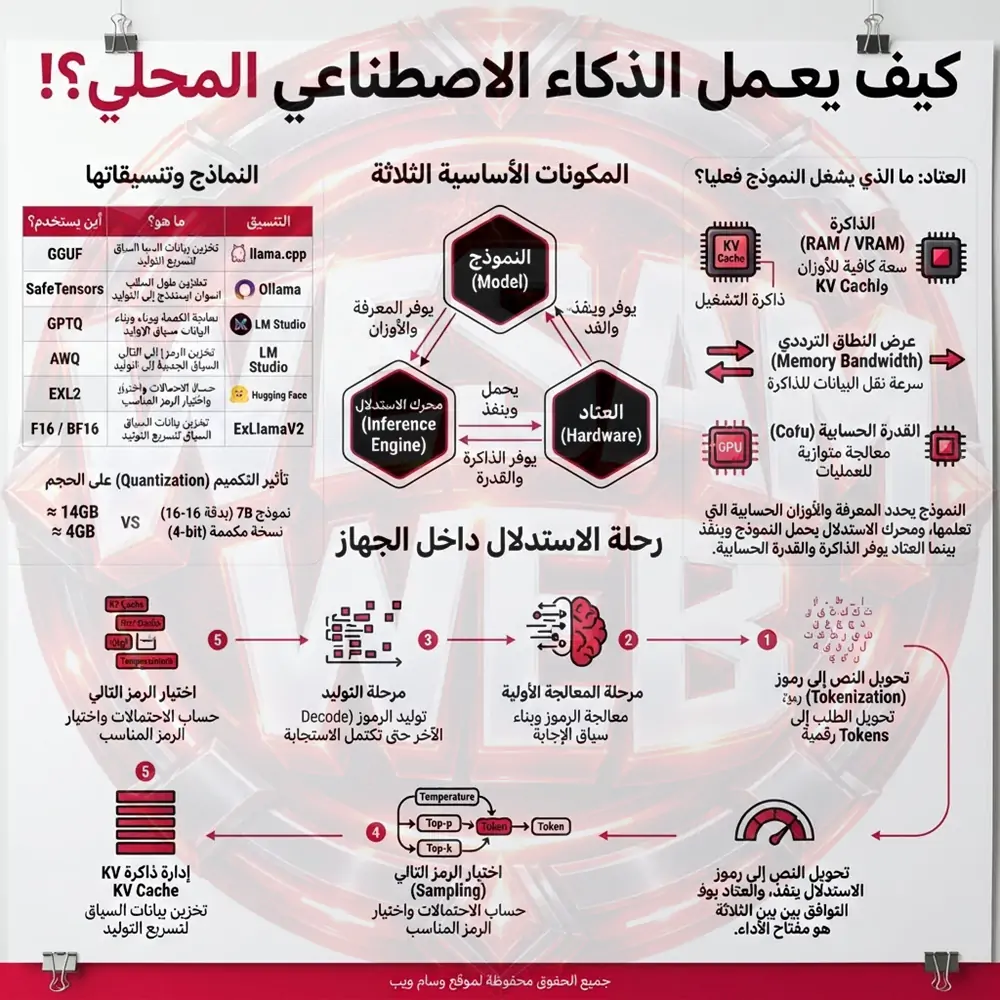
يعتمد تشغيل الذكاء الاصطناعي محليا على ثلاثة مكونات أساسية مترابطة، وهي النموذج (Model)، ومحرك الاستدلال (Inference Engine)، والعتاد (Hardware). يعمل النموذج على توفير المعرفة والأوزان الحسابية التي تعلمها أثناء التدريب، بينما يتولى محرك الاستدلال تحميل النموذج وتنفيذ العمليات الرياضية المطلوبة لإنتاج الاستجابة. أما العتاد، فيوفر الذاكرة والقدرة الحسابية وعرض النطاق الترددي اللازمين لتنفيذ هذه العمليات. وفهم العلاقة بين هذه المكونات الثلاثة هو المفتاح الحقيقي لفهم أداء أي نظام ذكاء اصطناعي محلي.
النماذج وتنسيقاتها (Models and Model Formats)
نموذج الذكاء الاصطناعي هو في الأساس مجموعة ضخمة من الأوزان والمعاملات الرقمية التي تمثل ما تعلمه النموذج أثناء التدريب. ويمكن أن يحتوي النموذج الحديث على مليارات أو حتى مئات المليارات من المعاملات، وتحتاج هذه المعاملات إلى مساحة كبيرة في الذاكرة عند تشغيلها بدقة عالية. فعلى سبيل المثال، يحتاج نموذج 7 مليارات معامل إلى نحو 14 جيجابايت عند دقة 16 بت، بينما يحتاج نموذج 70 مليار معامل إلى نحو 140 جيجابايت، قبل احتساب ذاكرة التشغيل الإضافية.
وهنا تظهر أهمية التكميم (Quantization)، وهي تقنية تقلل عدد البتات المستخدمة لتمثيل أوزان النموذج، مثل الانتقال من 16 بت إلى 8 أو 4 بت. يؤدي ذلك إلى تقليل حجم النموذج ومتطلبات الذاكرة بشكل كبير، وقد يساعد أيضا في تحسين سرعة الاستدلال. لكن التكميم ليس بلا مقابل، إذ يمكن أن يؤدي خفض الدقة إلى فقدان جزء من جودة النموذج، ويختلف هذا التأثير بحسب طريقة التكميم والنموذج والمهمة.
ومن أشهر التنسيقات المستخدمة محليا GGUF، وهو تنسيق ملفات طوره مشروع llama.cpp ليخزن الأوزان والبيانات الوصفية بطريقة مناسبة للتشغيل المحلي. ومن المهم التمييز بين التنسيق والتكميم، لأن GGUF يمكن أن يحتوي على أوزان بدقات مختلفة. فنموذج 7B بدقة 16 بت يحتاج نظريا إلى نحو 14 جيجابايت، بينما تنخفض نسخة 4 بت إلى نحو 4 جيجابايت. لذلك أصبحت النماذج المكممة أساسية لتشغيل النماذج الكبيرة على أجهزة المستخدمين، بدلا من حصرها في الخوادم ومراكز البيانات.
ومن أشهر تنسيقات النماذج التي قد يصادفها المستخدم ما يلي:
| التنسيق | ما هو؟ | أين يستخدم عادة؟ |
|---|---|---|
| GGUF | تنسيق ملفات مناسب للتشغيل المحلي، ويدعم أوزانا بدقات متعددة بما فيها الأوزان المكممة | llama.cpp، Ollama، LM Studio وغيرها |
| SafeTensors | تنسيق آمن وفعال لتخزين أوزان النماذج، ويستخدم على نطاق واسع في منظومة Hugging Face | Transformers، TGI، وأدوات وخوادم استدلال متعددة |
| GPTQ | أسلوب لتكميم أوزان النماذج، يستخدم خصوصا في بيئات الاستدلال المعتمدة على GPU | محركات وأدوات GPU متعددة مثل TGI وvLLM |
| AWQ | أسلوب تكميم يراعي أهمية التنشيطات للحفاظ على جودة جيدة مع تقليل متطلبات الذاكرة | vLLM وTGI وبيئات GPU أخرى |
| EXL2 | صيغة تكميم موجهة للاستدلال عالي الأداء على GPU وتتيح مرونة في معدل البتات | ExLlamaV2 وبيئات متوافقة |
| F16 / BF16 | دقات عددية أعلى تحافظ على قدر أكبر من دقة الأوزان، لكنها تحتاج إلى ذاكرة أكبر | التدريب والاستدلال عالي الدقة، بحسب العتاد والمحرك |
وتجدر الإشارة إلى أن GPTQ وAWQ وEXL2 هي أساليب أو صيغ مرتبطة بالتكميم وليست بدائل مباشرة لـ GGUF. لذلك قد يختلف اختيار التنسيق المناسب باختلاف محرك الاستدلال والعتاد الذي سيشغل النموذج. وتدعم بعض محركات الاستدلال الحديثة مجموعة واسعة من هذه الصيغ، بينما تفرض محركات أخرى تنسيقات محددة لتحقيق أفضل توافق وأداء.
محركات الاستدلال (Inference Engines)
إذا كان النموذج هو المادة التي تحتوي على المعرفة المتعلمة، فإن محرك الاستدلال هو البرنامج الذي يجعل هذه الأوزان قابلة للاستخدام. فهو يتولى تحميل النموذج في الذاكرة، وتجهيز المدخلات، وتنفيذ العمليات الحسابية، وإدارة الذاكرة المستخدمة أثناء الاستدلال، ثم تحويل النتائج الرقمية إلى الاستجابة التي يراها المستخدم.
ولا يقتصر دور محرك الاستدلال على تنفيذ النموذج فقط، بل يتعامل مع مجموعة من العمليات المهمة، مثل تحويل النص إلى Tokens، وحساب آلية الانتباه (Attention)، وإدارة ذاكرة KV Cache، وتنفيذ عملية أخذ العينات (Sampling) التي تحدد الرمز التالي أثناء توليد الإجابة. ولهذا يمكن أن يعطي النموذج نفسه أداء مختلفا بشكل واضح عند تشغيله باستخدام محركات استدلال مختلفة على العتاد نفسه.
ومن أشهر الأدوات والمنصات المستخدمة في هذا المجال:
- llama.cpp: محرك استدلال مكتوب أساسا بلغة C/C++، ويعد من أهم المشاريع في التشغيل المحلي للنماذج، خصوصا نماذج GGUF. ويدعم مجموعة واسعة من بيئات العتاد، بما فيها المعالج المركزي وبطاقات NVIDIA وAMD وApple Silicon وغيرها، مع إمكانية توزيع الحمل بين CPU وGPU في بعض السيناريوهات.
- Ollama: منصة مبسطة لتشغيل وإدارة النماذج محليا، توفر طريقة سهلة لتنزيل النماذج وتشغيلها والتعامل معها عبر سطر الأوامر وواجهات برمجة التطبيقات. وتستخدم تقنيات ومحركات استدلال مناسبة للنماذج المدعومة، لذلك من الأدق النظر إليها كمنصة تشغيل وإدارة للنماذج وليست مجرد اسم آخر لـ llama.cpp.
- vLLM: محرك استدلال عالي الأداء يركز على معدل المعالجة (Throughput) وخدمة النماذج، خصوصا عندما يتعامل النظام مع عدد كبير من الطلبات أو المستخدمين. ويستخدم تقنيات مثل PagedAttention والتجميع المستمر للطلبات (Continuous Batching)، كما يدعم أساليب مختلفة للتوازي والتكميم.
- LM Studio: تطبيق مكتبي يوفر واجهة رسومية لتنزيل النماذج وتشغيلها والتفاعل معها محليا، ويجعل تجربة النماذج المحلية أسهل للمستخدم الذي لا يريد التعامل مع أوامر الطرفية والإعدادات المعقدة.
- ExLlamaV2: محرك استدلال مخصص لبيئات GPU، ويركز على التشغيل عالي الأداء للنماذج المتوافقة مع تنسيقات تكميم معينة، مثل EXL2 وGPTQ.
- TGI (Text Generation Inference): خادم استدلال من Hugging Face موجه إلى تشغيل النماذج في البيئات التي تحتاج إلى خدمة الاستدلال، ويدعم مجموعة من تقنيات التكميم مثل GPTQ وAWQ وEXL2 وFP8 وغيرها.
- MLX: إطار عمل من Apple مصمم للاستفادة من بنية Apple Silicon والذاكرة الموحدة في مهام التعلم الآلي، ولذلك أصبح من الخيارات المهمة لتشغيل النماذج محليا على أجهزة Mac المتوافقة.
- MLC LLM: مشروع يركز على نشر وتشغيل نماذج الذكاء الاصطناعي على مجموعة متنوعة من الأجهزة والمنصات، بما في ذلك أجهزة الكمبيوتر والهواتف والمتصفحات، من خلال تقنيات التحويل والترجمة إلى عتاد ومنصات مختلفة.
كيف تتم عملية الاستدلال داخل الجهاز؟
عندما تكتب طلبا إلى نموذج ذكاء اصطناعي محلي، لا ينتقل النص مباشرة إلى إجابة جاهزة. بل يمر عبر سلسلة من المراحل الحسابية التي تبدأ بتحويل النص إلى Tokens وتنتهي بتوليد الرموز واحدا تلو الآخر حتى تكتمل الاستجابة. ويمكن تلخيص هذه الرحلة في خمس مراحل أساسية.
1. تحويل النص إلى رموز (Tokenization)
أولا، يحول محرك الاستدلال النص الذي كتبه المستخدم إلى وحدات تعرف باسم Tokens. وقد تمثل الوحدة كلمة كاملة أو جزءا من كلمة أو علامة أو مجموعة من الأحرف، بحسب نظام التقطيع الذي يستخدمه النموذج. ثم تتحول هذه الوحدات إلى معرفات رقمية يمكن للنموذج التعامل معها حسابيا.
لذلك، لا توجد قاعدة ثابتة تقول إن كل كلمة تعادل Token واحدا. فعدد الرموز يعتمد على اللغة والنص ونظام التقطيع المستخدم، وقد تكون النسبة مختلفة بشكل واضح بين الإنجليزية والعربية وغيرها من اللغات. ولهذا فإن حساب تكلفة الذاكرة أو طول السياق يجب أن يعتمد على عدد الـ Tokens الفعلي، وليس على عدد الكلمات وحده.
2. مرحلة المعالجة الأولية (Prefill)
بعد تحويل الطلب إلى Tokens، تبدأ مرحلة تعرف باسم Prefill أو معالجة الإدخال. في هذه المرحلة، يعالج النموذج رموز الطلب الموجودة بالفعل، ويجري العمليات الحسابية اللازمة لبناء التمثيلات الداخلية وحساب حالة السياق التي سيعتمد عليها أثناء توليد الإجابة.
وتستفيد هذه المرحلة بدرجة كبيرة من القدرة الحسابية المتوازية لوحدات معالجة الرسوميات والمسرعات الحديثة، ولذلك يمكن أن يتأثر أداؤها بقوة بقدرة العتاد الحسابية وكفاءة محرك الاستدلال. كما تلعب حركة البيانات بين الذاكرة ووالمعالجات دورا مهما في الأداء، خصوصا مع النماذج الكبيرة والسياقات الطويلة.
3. مرحلة التوليد (Decode)
بعد انتهاء معالجة الطلب، يبدأ النموذج في توليد الاستجابة. وهنا يدخل النظام في مرحلة Decode، حيث يتم توليد Token جديد في كل خطوة اعتمادا على السياق السابق. وبعد إنتاج الرمز الجديد، تتم إضافته إلى السياق، ثم يحسب النموذج الرمز التالي، وتتكرر العملية حتى يصل إلى نهاية الإجابة أو الحد الأقصى المحدد.
وهذه المرحلة هي التي يلاحظها المستخدم مباشرة عند مشاهدة النص وهو يظهر أمامه تدريجيا. وغالبا ما يتم قياس سرعة التوليد بوحدة Tokens per Second أو tok/s. لكن لا توجد سرعة ثابتة يمكن وصفها بأنها “جيدة” لجميع الأجهزة، لأن معدل التوليد يتغير بحسب حجم النموذج، ودقة الأوزان، وطول السياق، ونوع العتاد، ومحرك الاستدلال، وطريقة توزيع النموذج على الذاكرة والمعالجات.
4. اختيار الرمز التالي (Sampling)
في كل خطوة من خطوات التوليد، لا ينتج النموذج كلمة واحدة جاهزة، بل يحسب احتمالات للرموز المحتملة التالية. ثم تستخدم خوارزمية التوليد هذه الاحتمالات لاختيار الرمز الذي سيضاف إلى الاستجابة.
وتتحكم إعدادات مثل Temperature وTop-p وTop-k في طريقة هذا الاختيار. فرفع درجة الحرارة يمكن أن يجعل التوليد أكثر تنوعا، بينما يؤدي خفضها عادة إلى نتائج أكثر تحفظا واتساقا. أما Top-p وTop-k فتحددان مجموعة المرشحين التي يمكن الاختيار منها. ولهذا يمكن أن يعطي النموذج نفسه إجابات مختلفة عند تغيير إعدادات التوليد، حتى مع استخدام الطلب نفسه.
5. إدارة ذاكرة KV Cache
تعد KV Cache من أهم الأجزاء التي تؤثر في استهلاك الذاكرة أثناء الاستدلال. فبدلا من إعادة حساب بعض المعلومات المرتبطة بالرموز السابقة في كل خطوة، يحتفظ النظام بقيم Key وValue الناتجة عن عمليات الانتباه السابقة، ثم يعيد استخدامها أثناء توليد الرموز الجديدة.
ومع زيادة طول السياق (Context Length)، تكبر كمية البيانات التي تحتاجها KV Cache، وبالتالي ترتفع متطلبات الذاكرة. ولهذا قد يكون تشغيل نموذج معين ممكنا من حيث حجم الأوزان، لكنه يصبح أكثر استهلاكا للذاكرة عند استخدام سياق طويل جدا. وهذه نقطة مهمة للغاية عند اختيار بطاقة الرسوميات أو حجم الذاكرة المناسب للتشغيل المحلي.
العتاد: ما الذي يشغل النموذج فعليا؟
بعد فهم النموذج ومحرك الاستدلال، نصل إلى العنصر الثالث، وهو العتاد (Hardware). وهنا لا يعتمد أداء الذكاء الاصطناعي المحلي على رقم واحد مثل سرعة المعالج أو عدد أنوية بطاقة الرسوميات، بل على مجموعة من العوامل التي تعمل معا. وأهمها سعة الذاكرة، وعرض النطاق الترددي للذاكرة، والقدرة الحسابية، وطريقة توزيع النموذج بين وحدات المعالجة.
الذاكرة (RAM / VRAM):
تحتاج أوزان النموذج إلى مساحة في الذاكرة أثناء التشغيل. فإذا كان النموذج المكمم يحتاج إلى نحو 8 جيجابايت للأوزان، فهذا لا يعني أن جهازا يحتوي على 8 جيجابايت فقط سيكون كافيا بالضرورة. إذ يحتاج النظام أيضا إلى مساحة لـ KV Cache وذاكرة التشغيل والبرنامج ونظام التشغيل والعمليات الأخرى.
ولهذا يجب النظر إلى حجم النموذج على أنه نقطة بداية فقط عند تحديد متطلبات الجهاز. وكلما زاد حجم النموذج أو ارتفع طول السياق، زادت الحاجة إلى ذاكرة إضافية. كما يمكن لبعض محركات الاستدلال توزيع أجزاء النموذج بين VRAM وRAM، لكن ذلك قد يؤثر في الأداء مقارنة بتشغيل النموذج بالكامل على ذاكرة أسرع.
عرض النطاق الترددي للذاكرة (Memory Bandwidth):
يمثل عرض النطاق الترددي مقدار البيانات التي تستطيع الذاكرة نقلها خلال فترة زمنية معينة، ويعد عاملا مهما للغاية في سرعة الاستدلال، وخصوصا أثناء مرحلة Decode. فالنموذج يحتاج إلى الوصول المتكرر إلى كميات كبيرة من الأوزان والبيانات، وكلما كان نقل هذه البيانات أسرع، أمكن لوحدات المعالجة الاستفادة منها بكفاءة أكبر.
ولهذا تتمتع بطاقات الرسوميات الحديثة بميزة مهمة مقارنة بذاكرة النظام التقليدية في كثير من مهام الاستدلال، لأنها توفر عرض نطاق ترددي مرتفعا جدا للذاكرة. كما تستفيد أجهزة Apple Silicon من الذاكرة الموحدة، بينما تختلف قدرات DDR5 وLPDDR5X وغيرها بحسب نوع النظام وسرعة الذاكرة وتصميم المنصة.
القدرة الحسابية (Compute):
تلعب القدرة الحسابية دورا أساسيا أيضا، وخصوصا أثناء مرحلة Prefill التي تتطلب معالجة عدد كبير من الرموز والعمليات الحسابية في وقت واحد. وتساعد وحدات المعالجة المتوازية في GPU والمسرعات المتخصصة على تنفيذ هذه العمليات بكفاءة عالية.
ومع ذلك، من الخطأ اختزال أداء الذكاء الاصطناعي المحلي في FLOPS فقط. فالأداء النهائي يتأثر أيضا بعرض نطاق الذاكرة، وحجم النموذج، وطول السياق، وكفاءة النوى البرمجية، ودقة الأوزان، ومحرك الاستدلال، ومدى توافقه مع العتاد. لذلك قد يتفوق جهاز على آخر في سرعة معالجة الطلب، بينما يتفوق الجهاز الثاني في سرعة توليد الرموز، بحسب طبيعة الحمل المستخدم.
كيف تتعاون المكونات الثلاثة لإنتاج الإجابة؟
يمكن تلخيص العملية بالكامل في سلسلة مترابطة تبدأ عندما يكتب المستخدم طلبه وتنتهي بظهور الاستجابة على الشاشة:
المستخدم → Tokenization → Prefill → Attention وعمليات النموذج → KV Cache → Decode → Sampling → Token جديد → تكرار العملية → الاستجابة النهائية
في البداية، يحول محرك الاستدلال طلب المستخدم إلى Tokens، ثم يمررها إلى النموذج الموجود في الذاكرة. بعد ذلك، تنفذ وحدات المعالجة العمليات الرياضية المطلوبة خلال مرحلة Prefill، ويتم بناء المعلومات التي يحتاجها النموذج لفهم السياق. وعند بدء التوليد، تدخل العملية في حلقة Decode، حيث يتم حساب احتمالات الرمز التالي، واختيار أحدها وفق إعدادات Sampling، ثم تحديث السياق وKV Cache.
وتستمر هذه الحلقة رمزا بعد رمز حتى تكتمل الإجابة. وهنا تظهر العلاقة الحقيقية بين المكونات الثلاثة، فالنموذج يحدد ما يمكنه معرفته وتوليده، ومحرك الاستدلال يحدد كيفية تنفيذ هذه العمليات وإدارة الذاكرة، بينما يحدد العتاد مقدار الموارد المتاحة وسرعة تنفيذها. لذلك فإن الحصول على أفضل أداء محلي لا يعتمد فقط على اختيار نموذج قوي، بل على التوافق بين النموذج والتنسيق ومحرك الاستدلال والذاكرة والقدرة الحسابية للعتاد.
تصدر هذه النماذج تحت تراخيص متسامحة تسمح بـ الاستخدام التجاري والضبط الدقيق وإعادة التوزيع. وهي الأساس الذي يقوم عليه نظام الذكاء الاصطناعي المحلي بأكمله.
ما هو مكدس الذكاء الاصطناعي المحلي؟
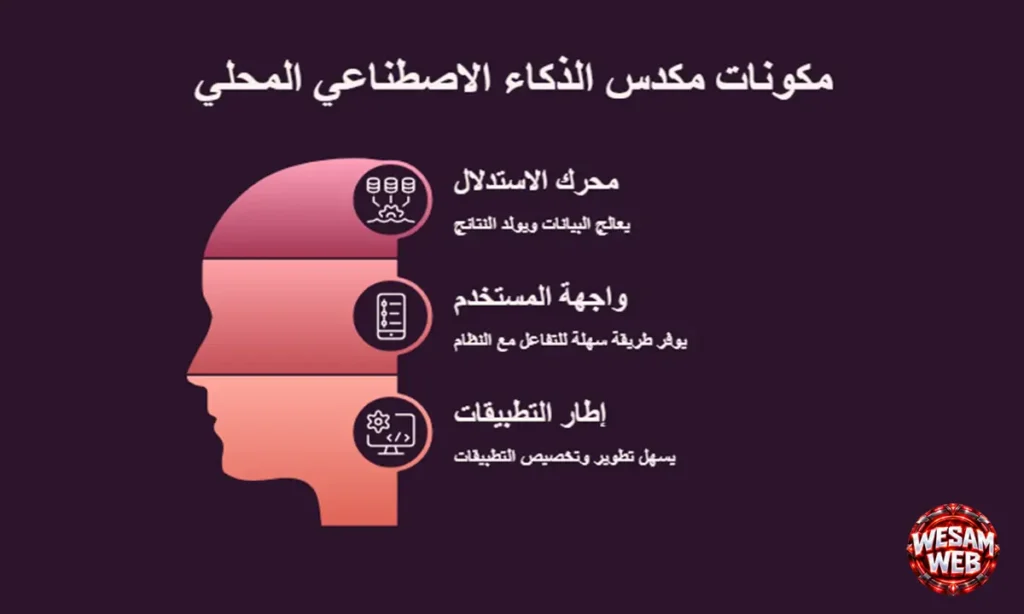
يتكون إعداد الذكاء الاصطناعي المحلي الكامل من ثلاث طبقات، لكل منها خيارات متعددة. فكر فيه مثل مكدس تطوير الويب، حيث تختار قاعدة بيانات وواجهة خلفية وواجهة أمامية. ومكدس الذكاء الاصطناعي المحلي يعمل بالطريقة نفسها.
الطبقة الأولى: محرك الاستدلال
- محرك الاستدلال هو الأساس. فهو يحمل النموذج ويشغله. ويحدد اختيارك للمحرك صيغ النماذج التي يمكنك استخدامها، والعتاد المدعوم، والأداء الذي ستحصل عليه.
- للمبتدئين: ابدأ مع Ollama. أمر واحد للتثبيت، وأمر واحد لتنزيل نموذج وتشغيله. ويكشف عن واجهة API متوافقة مع OpenAI تتصل بها معظم الأدوات.
- للمستخدمين المتقدمين: llama.cpp عبر llama-server يمنحك تحكما كاملا في التكميم وطول السياق وتفريغ طبقات بطاقة الرسوميات وحجم الدفعة. أما vLLM فهو الخيار الأفضل لـ خدمة عالية الإنتاجية مع مستخدمين متزامنين.
- لمستخدمي Mac: MLX يوفر تحسينا أصليا لـ Apple Silicon بأداء ممتاز على شرائح M1 إلى M4.
الطبقة الثانية: واجهة المستخدم
توفر طبقة الواجهة واجهة محادثة وإدارة المحادثات وتبديل النماذج، وغالبا ميزات إضافية مثل RAG والبحث في الويب وتوليد الصور.
- Open WebUI: واجهة المحادثة مفتوحة المصدر الأكثر شعبية. غنية بالميزات، تدعم خلفيات متعددة، وفيها RAG مدمج، وتوفر دعما متعدد المستخدمين.
- LM Studio: تطبيق سطح مكتب مصقول يضم محرك استدلاله الخاص. رائع لمن يفضل تجربة رسومية لإدارة النماذج.
- GPT4All: تطبيق سطح مكتب يركز على البساطة والخصوصية. يتضمن محرك استدلاله وكتالوج نماذج.
- Jan: تطبيق مفتوح المصدر مبني على Electron بواجهة نظيفة ومعمارية محلية أولا.
- SillyTavern: واجهة موجهة لـ لعب الأدوار والكتابة الإبداعية، شائعة في مجتمع الهواة.
- text-generation-webui: واجهة ويب مبنية على Gradio بدعم واسع للنماذج وضبط متقدم للمعاملات.
الطبقة الثالثة: إطار التطبيقات
لبناء تطبيقات تتجاوز المحادثة البسيطة، توفر الأطر أدوات لـ خطوط RAG وسير عمل الوكلاء واستدعاء الدوال والتكامل مع خدمات خارجية.
- LangChain / LangGraph: الإطار الأكثر شمولا لبناء تطبيقات LLM. يدعم السلاسل والوكلاء وRAG واستخدام الأدوات والذاكرة.
- LlamaIndex: يركز على استيعاب البيانات وRAG. ممتاز لبناء أنظمة بحث وأسئلة وأجوبة فوق مستنداتك.
- Haystack: إطار NLP شامل من deepset، مصمم لـ خطوط RAG الإنتاجية.
- Semantic Kernel: SDK من مايكروسوفت لدمج LLM في التطبيقات، بدعم قوي لـ .NET وPython.
- CrewAI: إطار لتنسيق وكلاء ذكاء اصطناعي متعددين يتعاونون في مهام معقدة.
- Autogen: إطار مايكروسوفت لـ محادثات متعددة الوكلاء وسير عمل مؤتمت.
ما الذي تحتاجه لتشغيل الذكاء الاصطناعي المحلي؟

قبل الشروع في تجربة الذكاء الاصطناعي المحلي، من الضروري فهم العناصر الأساسية التي يعتمد عليها تشغيل أي نموذج بشكل سلس وفعال. وهي مزيج من العتاد الصلب المناسب والبرمجيات الوسيطة التي تدير عملية الاستدلال. لا يعني هذا بالضرورة الحاجة إلى جهاز فائق القوة. فالكثير من النماذج الصغيرة والمتوسطة الحجم تعمل بكفاءة جيدة على أجهزة الاستخدام اليومي.
تتفاوت المتطلبات بشكل كبير حسب حجم النموذج المستهدف ونوع المهمة المطلوبة. فتشغيل نموذج لغوي صغير للمحادثات البسيطة يختلف جذريا عن تشغيل نموذج ضخم متعدد الوسائط. لذلك من المفيد قبل البدء تحديد الهدف الأساسي من الاستخدام. من أهم العناصر التي يجب توفرها بشكل عام ما يلي:
- ذاكرة وصول عشوائي كافية لتحميل النموذج بالكامل
- مساحة تخزين كافية لحفظ ملفات النماذج المتعددة
- معالج أو بطاقة رسوميات قادرة على إجراء الحسابات بسرعة معقولة
- نظام تشغيل حديث متوافق مع أدوات تشغيل النماذج الشائعة
هل تحتاج إلى GPU لتشغيل النماذج المحلية؟
ليست بطاقة الرسوميات أو GPU شرطا إلزاميا مطلقا لتشغيل كل النماذج المحلية. لكنها تحدث فرقا هائلا في سرعة الاستجابة مقارنة بالاعتماد على المعالج المركزي وحده. تتفوق بطاقات الرسوميات في هذه المهمة لأن بنيتها الداخلية مصممة أصلا لتنفيذ آلاف العمليات الحسابية المتوازية في وقت واحد. وهو بالضبط نوع الحسابات المطلوبة أثناء عملية الاستدلال في النماذج العصبية.
بالنسبة للنماذج الصغيرة التي لا يتجاوز حجمها بضعة مليارات من المعاملات. يمكن للمعالج المركزي وحده أن يقدم أداء مقبولا نوعا ما، خاصة على الأجهزة الحديثة ذات الأنوية المتعددة. أما عند الانتقال إلى نماذج أكبر حجما. فإن غياب بطاقة رسوميات مخصصة يعني عمليا انتظار وقت أطول بكثير للحصول على استجابة كاملة. وهو ما قد يجعل تجربة الاستخدام غير عملية في المهام اليومية المتكررة.
من الناحية العملية، توفر بطاقات الرسوميات المخصصة من شركات مثل NVIDIA أداء متميزا بفضل دعمها القوي لمكتبات التسريع المتخصصة في الذكاء الاصطناعي. بينما توفر بعض الأجهزة الحديثة المزودة بذاكرة موحدة، مثل حواسيب Apple بمعالجات M. بديلا جيدا نسبيا حتى بدون بطاقة رسوميات منفصلة تقليدية. الخلاصة العملية هي أن وجود بطاقة رسوميات يعتبر توصية قوية لمن يرغب في تجربة استخدام سلسة. وليس شرطا مطلقا لتشغيل أي نموذج على الإطلاق.
ما أهمية RAM وVRAM وCPU وNPU؟
تلعب ذاكرة الوصول العشوائي أو RAM دورا محوريا في تشغيل النماذج المحلية. لأن النموذج بكامل أوزانه يجب أن يتم تحميله في الذاكرة قبل أن يتمكن من معالجة أي طلب. وكلما كان النموذج أكبر حجما زادت كمية الذاكرة المطلوبة لتشغيله دون بطء ملحوظ أو تعطل كامل للنظام. في المقابل، تعتبر VRAM، وهي الذاكرة الخاصة ببطاقة الرسوميات، أكثر أهمية عند استخدام GPU للتسريع. لأن النموذج في هذه الحالة يحتاج إلى التحميل داخل هذه الذاكرة المخصصة للحصول على أقصى استفادة من قدرات التوازي التي توفرها البطاقة.
أما المعالج المركزي أو CPU فيظل مسؤولا عن إدارة العمليات العامة للنظام وتنسيق تدفق البيانات بين مختلف مكونات الجهاز. وتزداد أهميته بشكل خاص عند عدم توفر بطاقة رسوميات مخصصة. حيث يتحمل عبء إجراء الحسابات الرياضية للنموذج بالكامل بمفرده، وفي هذه الحالة، فإن عدد الأنوية وسرعة المعالج يؤثران بشكل مباشر على سرعة توليد الاستجابة النهائية.
أما NPU، وهي وحدة معالجة متخصصة في مهام الذكاء الاصطناعي بدأت تنتشر في الأجهزة الحديثة. فتمثل اتجاها مستقبليا واعدا يهدف إلى تخفيف العبء عن المعالج وبطاقة الرسوميات معا من خلال تصميم مخصص بالكامل لتسريع عمليات الشبكات العصبية بكفاءة طاقة أعلى بكثير. ورغم أن دعم البرمجيات لهذه الوحدات ما زال في مراحله المبكرة نسبيا. إلا أن الاتجاه العام في صناعة العتاد يشير بوضوح نحو دمجها كمكون أساسي في الأجهزة القادمة.
كيف تختار مواصفات الجهاز المناسبة؟
يعتمد اختيار المواصفات المناسبة بشكل أساسي على حجم النماذج التي ينوي المستخدم تشغيلها وطبيعة استخدامه اليومي المتوقع لها. فالمستخدم الذي يهدف فقط إلى تجربة نماذج صغيرة لمهام بسيطة مثل المساعدة في الكتابة أو الإجابة عن الأسئلة العامة يمكنه الاكتفاء بجهاز متوسط المواصفات. بينما يحتاج من يرغب في تشغيل نماذج ضخمة لمهام متقدمة مثل البرمجة المعقدة أو تحليل المستندات الطويلة إلى استثمار أكبر في العتاد المخصص.
القاعدة العملية الأبسط هنا هي البدء بمواصفات متوسطة تسمح بتجربة عدة نماذج صغيرة ومتوسطة الحجم. ثم الترقية التدريجية بناء على الاحتياج الفعلي الذي يظهر مع الاستخدام المستمر. بدلا من الاستثمار المسبق الكبير في عتاد قد يتجاوز الحاجة الحقيقية. عند التخطيط للترقية أو الشراء، من المفيد مراعاة النقاط التالية:
- مراعاة إمكانية الترقية المستقبلية للذاكرة أو بطاقة الرسوميات دون استبدال الجهاز بالكامل
- تحديد الحد الأدنى من الذاكرة المطلوبة لحجم النموذج المستهدف مسبقا
- إعطاء أولوية لبطاقة الرسوميات ذات الذاكرة الأكبر عند التوجه لنماذج متوسطة أو كبيرة
- التأكد من توفر مساحة تخزين كافية وسريعة لتحميل النماذج المتعددة
ما أنواع نماذج الذكاء الاصطناعي التي يمكن تشغيلها محليا؟
تطور مجال الذكاء الاصطناعي المحلي بشكل كبير حتى أصبح يشمل أنواعا متعددة من النماذج تتجاوز المحادثة النصية البسيطة. لتغطي مهاما متقدمة مثل توليد الصور وتحويل النصوص إلى صوت وفهم محتوى الصور والفيديو. هذا التنوع يعكس نضج البيئة التقنية المحيطة بهذا المجال. حيث لم يعد المستخدم مضطرا للاعتماد على خدمة سحابية واحدة لكل نوع من هذه المهام، بل يمكنه بناء منظومة متكاملة من النماذج المحلية المتخصصة تعمل جميعها على جهازه الشخصي.
يساعد فهم هذا التصنيف المستخدم على اختيار النموذج الأنسب لكل مهمة بدلا من محاولة استخدام نموذج واحد لكل شيء. وهو خطأ شائع يقع فيه المبتدئون في هذا المجال. فكل فئة من هذه النماذج مصممة ومدربة خصيصا لأداء نوع معين من المهام بكفاءة عالية. وتختلف متطلبات تشغيلها ومتطلبات العتاد الخاصة بها بشكل ملحوظ من فئة لأخرى. أبرز هذه الفئات تشمل ما يلي:
- نماذج اللغة الكبيرة المتخصصة في فهم النصوص وتوليدها
- نماذج توليد الصور من أوصاف نصية مكتوبة
- نماذج تحويل النص إلى صوت والعكس
- نماذج الرؤية الحاسوبية لفهم محتوى الصور
- نماذج متعددة الوسائط تجمع بين أكثر من نوع من المدخلات
نماذج اللغة الكبيرة LLMs
تعتبر نماذج اللغة الكبيرة أو LLMs الفئة الأكثر شيوعا وانتشارا ضمن منظومة الذكاء الاصطناعي المحلي. وهي النماذج المسؤولة عن فهم النصوص المكتوبة وتوليد ردود منطقية ومترابطة بناء عليها. تدرب هذه النماذج على كميات هائلة من النصوص المختلفة. مما يمنحها القدرة على التعامل مع مجموعة واسعة من المهام مثل الإجابة عن الأسئلة. وتلخيص المستندات الطويلة، وكتابة الأكواد البرمجية، وحتى الترجمة بين اللغات المختلفة.
تتفاوت هذه النماذج بشكل كبير من حيث الحجم وعدد المعاملات التي تحتويها. بدءا من نماذج صغيرة تحتوي على بضعة مليارات من المعاملات فقط وتناسب الأجهزة محدودة الموارد، وصولا إلى نماذج أكبر بكثير تقترب في قدراتها من بعض النماذج السحابية التجارية المعروفة. هذا التنوع يمنح المستخدم مرونة كبيرة في اختيار النموذج الذي يوازن بين مستوى الأداء المطلوب وإمكانيات جهازه المتاحة.
من أشهر عائلات نماذج اللغة الكبيرة المتاحة للتشغيل المحلي حاليا نماذج Llama من شركة Meta. ونماذج Mistral الفرنسية المعروفة بكفاءتها العالية رغم حجمها المعتدل. ونماذج Qwen الصينية التي أثبتت أداء قويا خاصة في المهام البرمجية والرياضية. إضافة إلى نماذج DeepSeek التي حققت انتشارا واسعا بفضل توازنها الجيد بين الأداء والحجم.
نماذج الرؤية الحاسوبية والذكاء الاصطناعي متعدد الوسائط
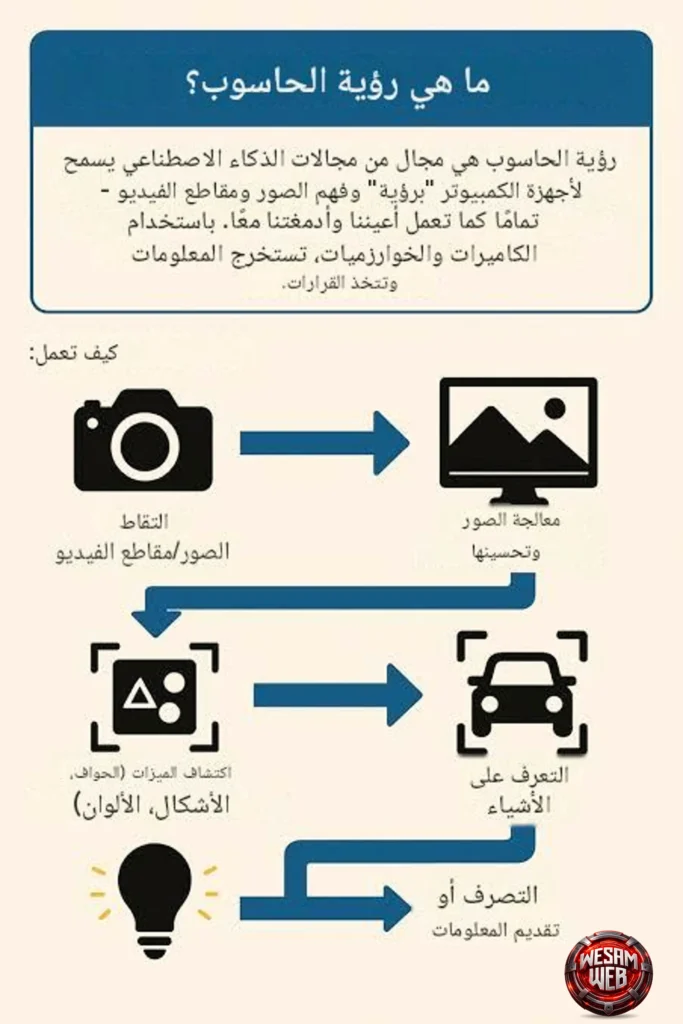
تختص نماذج الرؤية الحاسوبية بفهم محتوى الصور وتحليلها، بدءا من التعرف على الأجسام والوجوه، وصولا إلى استخراج النصوص من الصور الممسوحة ضوئيا وفهم المخططات والرسوم البيانية المعقدة. تستخدم هذه النماذج على نطاق واسع في تطبيقات مثل تصنيف الصور تلقائيا، ومراقبة الجودة في خطوط الإنتاج الصناعية. وحتى في أنظمة الأمان المحلية التي تحلل لقطات كاميرات المراقبة دون إرسالها لأي خادم خارجي.
أما النماذج متعددة الوسائط. فتمثل تطورا أكثر تقدما يجمع بين أكثر من نوع واحد من المدخلات في نموذج واحد متكامل. بحيث يصبح بإمكان النموذج استقبال نص وصورة معا في الطلب نفسه. ثم توليد استجابة نصية تأخذ بعين الاعتبار محتوى الصورة المرفقة. هذا النوع من النماذج أصبح متاحا بشكل متزايد للتشغيل المحلي. ويفتح إمكانيات عملية واسعة مثل شرح محتوى مستند ممسوح ضوئيا أو تحليل رسم بياني معقد مباشرة على الجهاز.
يمثل هذا الاتجاه نحو الدمج بين الوسائط المختلفة أحد أهم مسارات التطور المستقبلي في هذا المجال. إذ يسمح للمستخدم بالتعامل مع مهام أكثر تعقيدا وواقعية باستخدام نموذج واحد فقط بدلا من الاضطرار لاستخدام عدة نماذج متخصصة منفصلة لكل نوع من المدخلات. وهو ما يبسط بشكل كبير تجربة الاستخدام اليومية لمن يعمل مع محتوى متنوع الأشكال.
مقالة ذات صلة: الرؤية الحاسوبية (Computer Vision): العين الثالثة التي تعيد اختراع الذكاء البشري.
الدردشة والمحادثة
تعد هذه حالة الاستخدام الأكثر مباشرة؛ حيث تقوم بتشغيل نموذج محلياً والدردشة معه عبر واجهة مستخدم مثل Open WebUI أو LM Studio. ستحصل على مساعد خاص ومتاح دائماً لا يملك أي معلومات عن محادثاتك سوى ما تخبره به خلال الجلسة الحالية. وتوفر نماذج مثل Llama 3.2 8B جودة محادثة ممتازة لأغراض الدردشة العامة.
المساعدة في البرمجة
توفر نماذج البرمجة المحلية مثل DeepSeek-Coder وCodeLlama وQwen2.5-Coder وStarCoder2 ميزات إكمال الكود وتوليده وشرحه وتصحيح أخطائه، مع إمكانية التكامل المباشر داخل بيئات التطوير المتكاملة IDE. وتعمل أدوات مثل Continue.dev على الاتصال المباشر بـ Ollama لتوفير تجربة مشابهة لـ Copilot دون أي اعتماد على السحابة؛ مما يضمن بقاء قاعدة الكود الخاصة بك محلية بالكامل.
التوليد المعزز بالاسترجاع RAG
يجمع نظام RAG بين نموذج لغة وقاعدة معرفية للإجابة عن الأسئلة استناداً إلى مستنداتك الخاصة. ويعني تشغيل RAG محلياً أن مستنداتك سواء كانت عقوداً أو سجلات طبية أو تقارير مالية أو أبحاثاً خاصة لا تغادر بنيتك التحتية أبداً. وتتضمن حزمة RAG المحلية النموذجية ما يلي:
- نموذج تضمين مثل nomic-embed-text عبر Ollama لتحويل المستندات إلى متجهات
- قاعدة بيانات متجهة مثل ChromaDB أو Qdrant أو Milvus لتخزين تلك المتجهات والبحث فيها
- نموذج لغة لتوليد الإجابات باستخدام السياق المسترجع
الصوت والكلام
يعمل نموذج Whisper من OpenAI، ومن المفارقة أنه متاح للاستخدام المحلي، محلياً عبر whisper.cpp، موفراً تقنية متطورة لتحويل الكلام إلى نص. ومن خلال دمجه مع نماذج تحويل النص إلى كلام محلية مثل Piper أو Bark أو XTTS، يمكنك بناء مساعدين صوتيين يعملون محلياً بالكامل. كما يعمل نموذج Whisper large-v3 في الوقت الفعلي على وحدات معالجة الرسومات الحديثة.
توليد الصور
يقوم نموذج Stable Diffusion عبر واجهات مثل AUTOMATIC1111 أو ComfyUI أو Fooocus بتوليد الصور محلياً مع منحك تحكماً كاملاً في الأوامر النصية prompts وقيم البذور seeds وتعديلات النموذج الدقيقة fine-tunes. وتنتج نماذج SDXL وStable Diffusion 3 صوراً عالية الجودة عند تشغيلها على وحدة معالجة رسومات GPU بذاكرة فيديو VRAM تبلغ 8 جيجابايت أو أكثر. كما تمثل نماذج Flux من شركة Black Forest Labs الجيل الأحدث في مجال توليد الصور محلياً.
مقالة ذات صلة: أفضل 10 أدوات تحرير الصور بالذكاء الاصطناعي مجانية (تقييم وسام ويب لـ 2026).
الرؤية والأنظمة متعددة الوسائط Multimodal
يمكن لنماذج مثل LLaVA وLlama 3.2 Vision وQwen-VL تحليل الصور محلياً. تشمل حالات الاستخدام التعرف الضوئي على الأحرف OCR للمستندات، وتحليل لقطات الشاشة، ووصف الصور لتحسين إمكانية الوصول، والإجابة على الأسئلة المرئية. يمكنك تشغيلها عبر Ollama باستخدام الأمر ollama run llava أو ollama run llama3.2-vision.
المؤسسات والامتثال
تواجه المؤسسات في قطاعات الرعاية الصحية والمالية والقانونية والحكومية لوائح صارمة لحماية البيانات مثل HIPAA وGDPR وSOX وITAR. غالبًا ما يكون الذكاء الاصطناعي المحلي هو السبيل الوحيد لاستخدام إمكانيات الذكاء الاصطناعي مع ضمان الامتثال. يمكن معالجة البيانات الحساسة مثل سجلات المرضى والبيانات المالية والوثائق السرية بواسطة الذكاء الاصطناعي دون الحاجة إلى مغادرة البنية التحتية للمؤسسة.
الأتمتة والوكلاء
يمكن لـ وكلاء الذكاء الاصطناعي المحليين أتمتة المهام المتكررة: تلخيص رسائل البريد الإلكتروني، وتصنيف المستندات، واستخراج البيانات من النماذج، وإنشاء التقارير، ومراقبة ملفات السجلات، وفرز طلبات الدعم. نظرًا لأن الاستدلال المحلي لا يتطلب أي تكلفة إضافية، يمكنك تشغيل عمليات الأتمتة هذه باستمرار دون القلق بشأن فواتير واجهة برمجة التطبيقات API.ليين أتمتة المهام المتكررة: تلخيص رسائل البريد الإلكتروني، وتصنيف المستندات، واستخراج البيانات من النماذج، وإنشاء التقارير، ومراقبة ملفات السجلات، وفرز طلبات الدعم. نظرًا لأن الاستدلال المحلي لا يتطلب أي تكلفة إضافية، يمكنك تشغيل عمليات الأتمتة هذه باستمرار دون القلق بشأن فواتير واجهة برمجة التطبيقات API.
ما أفضل نماذج الذكاء الاصطناعي المحلي في 2026؟
يشهد سوق النماذج المفتوحة المصدر تطورا سريعا ومستمرا. ما يجعل قائمة أفضل الخيارات تتغير بوتيرة أسرع من أي وقت مضى. لكن مجموعة من العائلات النموذجية أثبتت نفسها كخيارات موثوقة ومستقرة نسبيا حتى مطلع عام 2026 بفضل الدعم المستمر من الشركات المطورة والمجتمع البرمجي المحيط بها. يعرض الجدول التالي أبرز هذه النماذج مع أهم مميزاتها وعيوبها العملية.
| النموذج | أبرز الميزات | أبرز العيوب |
| Llama | دعم واسع من المجتمع وتوثيق غني ومتعدد الأحجام | يحتاج ضبطا إضافيا للمهام المتخصصة جدا |
| Mistral | كفاءة عالية بحجم صغير نسبيا وأداء قوي في المهام العامة | بعض الإصدارات ذات ترخيص مقيد تجاريا |
| Qwen | أداء متميز في البرمجة والرياضيات ودعم لغات متعددة | أحجامه الكبيرة تتطلب عتادا قويا نسبيا |
| DeepSeek | توازن ممتاز بين الأداء والحجم مع تكلفة تشغيل منخفضة | توثيق أقل تفصيلا مقارنة ببعض المنافسين |
| Gemma | تحسين قوي للتشغيل على الأجهزة محدودة الموارد | قدرات أقل نسبيا في المهام شديدة التعقيد |
| Phi | حجم صغير جدا مع أداء جيد في الاستدلال المنطقي | نافذة سياق أضيق مقارنة بالنماذج الأكبر |
ما أشهر النماذج المناسبة للتشغيل المحلي؟
من بين هذه النماذج. تبرز عائلة Llama من Meta كخيار شائع بشكل خاص بين المبتدئين والمطورين على حد سواء. نظرا لتوفرها بأحجام متعددة تناسب مختلف مستويات العتاد. إضافة إلى الدعم الواسع الذي توفره أدوات التشغيل الشائعة لهذه العائلة تحديدا. كما تحظى نماذج Mistral الفرنسية بسمعة قوية بفضل كفاءتها العالية رغم حجمها المعتدل نسبيا مقارنة بمنافسيها.
في المقابل، أثبتت نماذج Qwen الصينية تفوقا ملحوظا في المهام البرمجية والرياضية المعقدة. ما جعلها خيارا مفضلا لدى المطورين المتخصصين في هذه المجالات. بينما حققت نماذج DeepSeek انتشارا واسعا بفضل توازنها الاستثنائي بين جودة الأداء وحجم النموذج المطلوب لتشغيله. وهو ما يجعلها مناسبة للعتاد متوسط المواصفات.
أما نماذج Gemma من جوجل فتتميز بتحسين خاص يستهدف الأجهزة محدودة الموارد. ما يجعلها خيارا جيدا للمستخدمين الذين لا يملكون عتادا فائق القوة. بينما تركز نماذج Phi من مايكروسوفت على تحقيق أداء قوي في الاستدلال المنطقي رغم حجمها الصغير جدا. وهو اتجاه بحثي مثير للاهتمام يثبت أن حجم النموذج ليس العامل الوحيد المحدد لجودة أدائه.
كيف تختلف النماذج في الحجم والأداء ومتطلبات التشغيل؟
| فئة الحجم | عدد المعاملات التقريبي | الذاكرة المطلوبة تقريبا | الاستخدام المناسب |
| صغير | من 1 إلى 4 مليار | من 4 إلى 8 غيغابايت | مهام بسيطة وأجهزة محدودة الموارد |
| متوسط | من 7 إلى 14 مليار | من 8 إلى 16 غيغابايت | استخدام يومي عام ومهام متنوعة |
| كبير | من 30 إلى 70 مليار | من 24 إلى 48 غيغابايت | مهام متقدمة تتطلب دقة أعلى |
| ضخم | أكثر من 100 مليار | أكثر من 64 غيغابايت | مهام بحثية ومؤسسية متخصصة |
كيف تختار النموذج المناسب لاستخدامك؟
تعتمد عملية اختيار النموذج المناسب بشكل أساسي على تحديد الهدف الفعلي من الاستخدام قبل النظر في أي عامل آخر. فمن يريد مساعدا بسيطا للكتابة اليومية لا يحتاج بالضرورة إلى أضخم نموذج متاح. بينما من يعمل على مهام برمجية معقدة أو تحليل بيانات دقيق يحتاج إلى نموذج أثبت كفاءة واضحة في هذا المجال تحديدا. من المفيد أيضا مراعاة حجم النموذج بالنسبة لإمكانيات الجهاز المتاح. لأن اختيار نموذج أكبر من قدرة الجهاز يؤدي غالبا إلى بطء شديد أو تعطل كامل للعملية.
الخطوة العملية الأفضل هي البدء بتجربة نموذج متوسط الحجم من عائلة معروفة وموثوقة. ثم تقييم الأداء الفعلي بناء على المهام الحقيقية التي يحتاجها المستخدم يوميا. بدلا من الاعتماد فقط على نتائج الاختبارات المعيارية العامة التي قد لا تعكس بدقة تجربة الاستخدام الشخصية. تشمل أهم النقاط التي يجب مراعاتها عند الاختيار ما يلي:
- طبيعة المهمة الأساسية المستهدفة من النموذج
- حجم الذاكرة المتوفرة فعليا في الجهاز
- مدى الحاجة إلى دعم اللغة العربية بجودة عالية
- توفر نسخ مضغوطة من النموذج تناسب العتاد المحدود
ما أفضل البرامج لتشغيل الذكاء الاصطناعي المحلي؟
بعد اختيار النموذج المناسب، تأتي الخطوة الثانية المهمة وهي اختيار البرنامج الوسيط الذي سيتولى عملية تحميل النموذج وإدارته وتشغيله بكفاءة على الجهاز. وهي خطوة لا تقل أهمية عن اختيار النموذج نفسه، لأن جودة هذا البرنامج تؤثر بشكل مباشر على سهولة الاستخدام وسرعة الأداء. تختلف هذه البرامج فيما بينها من حيث سهولة الاستخدام والميزات المتقدمة المتاحة. وسيتم في هذا القسم استعراض ثلاثة من أبرز الخيارات المتاحة حاليا. وهي Ollama وLM Studio وOpen WebUI، لمساعدة القارئ على اختيار الأداة الأنسب لمستوى خبرته التقنية.
ما هو Ollama وكيف يعمل؟
يعتبر Ollama من أكثر أدوات تشغيل النماذج المحلية شعبية بين المطورين. بفضل تصميمه البسيط الذي يعتمد على سطر الأوامر بشكل أساسي. ما يجعله خيارا مثاليا لمن يفضل التعامل التقني المباشر بدلا من الواجهات الرسومية المعقدة. يقوم البرنامج بتبسيط عملية تنزيل النماذج وتشغيلها إلى أمر واحد بسيط. حيث يتولى تلقائيا إدارة تحميل النموذج وضبط الإعدادات الافتراضية المناسبة له.
يوفر Ollama أيضا واجهة برمجة تطبيقات محلية سهلة الاستخدام. ما يسمح للمطورين بدمج النماذج المحلية بسلاسة داخل تطبيقاتهم الخاصة دون الحاجة إلى إعداد معقد إضافي. هذه الميزة تحديدا جعلته الخيار المفضل لكثير من المشاريع البرمجية التي تحتاج إلى دمج قدرات الذكاء الاصطناعي محليا داخل أدواتها أو خدماتها الداخلية.
من الناحية العملية، يدعم Ollama مجموعة واسعة من النماذج الشائعة جاهزة للتنزيل المباشر من مكتبته الخاصة. ويعمل على أنظمة التشغيل الرئيسية الثلاثة، ما يمنحه مرونة كبيرة في الاستخدام عبر بيئات عمل مختلفة. يظل هذا البرنامج نقطة انطلاق ممتازة لمن يرغب في خطوة أولى سريعة وبسيطة نحو عالم الذكاء الاصطناعي المحلي.
ما هو LM Studio ومتى تستخدمه؟
على النقيض من التوجه العملي لبرنامج Ollama، يقدم LM Studio تجربة قائمة بالكامل على واجهة رسومية سهلة الاستخدام. ما يجعله الخيار الأنسب للمستخدمين الذين يفضلون التفاعل البصري المباشر دون الحاجة للتعامل مع سطر الأوامر إطلاقا. يوفر البرنامج متصفحا داخليا مدمجا لتصفح النماذج المتاحة وتنزيلها مباشرة. مع عرض معلومات واضحة عن حجم كل نموذج ومتطلبات تشغيله المتوقعة.
تتميز هذه الأداة أيضا بتوفير واجهة محادثة جاهزة تشبه إلى حد بعيد تطبيقات المحادثة السحابية المعروفة. ما يسهل الانتقال إليها على المستخدمين المعتادين على هذه التطبيقات دون منحنى تعلم صعب. كما يتيح البرنامج مراقبة استهلاك الموارد أثناء التشغيل بشكل مباشر ومرئي. وهو ما يساعد المستخدم على فهم مدى ملاءمة النموذج المختار لإمكانيات جهازه بشكل عملي وسريع.
يعتبر LM Studio خيارا مثاليا للمستخدمين الجدد الذين يرغبون في تجربة سريعة وواضحة دون الخوض في تفاصيل تقنية معقدة. كما يناسب أيضا المستخدمين الذين يفضلون إدارة عدة نماذج مختلفة ومقارنتها بصريا من واجهة واحدة موحدة ومنظمة.
ما دور Open WebUI في تشغيل النماذج المحلية؟
يمثل Open WebUI طبقة إضافية تعمل عادة فوق أدوات تشغيل أخرى مثل Ollama. حيث يوفر واجهة ويب متقدمة يمكن الوصول إليها عبر المتصفح. ما يمنح المستخدم تجربة أقرب إلى منصات المحادثة السحابية الاحترافية لكن مع كامل مزايا التشغيل المحلي والخصوصية الكاملة للبيانات. هذا التصميم يجعله خيارا مثاليا لمن يرغب في تجربة استخدام غنية بالميزات دون التخلي عن استقلالية التشغيل المحلي.
من أبرز ما يميز هذه الأداة قدرتها على دعم عدة مستخدمين في نفس الوقت داخل بيئة واحدة. ما يجعلها مناسبة بشكل خاص للفرق الصغيرة أو المؤسسات التي ترغب في توفير وصول مشترك لنموذج محلي واحد لعدة أعضاء دون الحاجة لتشغيل نسخة منفصلة على كل جهاز على حدة. كما تدعم الأداة أيضا ميزات متقدمة مثل رفع المستندات والتفاعل معها مباشرة داخل المحادثة.
يبرز دور Open WebUI بشكل خاص في السيناريوهات التي تتطلب واجهة احترافية قابلة للتخصيص، سواء لأغراض داخلية في بيئة عمل أو لبناء منتج قائم على نموذج محلي يحتاج إلى واجهة متكاملة جاهزة دون الحاجة لبناء كل شيء من الصفر. ما يوفر وقتا وجهدا كبيرين على المطورين الراغبين في تسريع مرحلة التطوير الأولية.
ما هو الخادم المناسب لـ LocalAI؟
يعتمد اختيار الخادم المناسب لتشغيل LocalAI على حجم النماذج التي تريد تشغيلها وعدد المستخدمين المتزامنين. فلا يحتاج LocalAI إلى بطاقة رسوميات إلزامية، حيث يعمل بكفاءة على المعالج المركزي مع ذاكرة وصول عشوائي كافية، لكن وجود GPU يسرع الاستدلال بشكل ملحوظ. الخادم المثالي يوازن بين الذاكرة وعرض النطاق الترددي والقدرة الحسابية بحسب الاستخدام الفعلي.
| السيناريو | المعالج | الذاكرة (RAM) | بطاقة الرسوميات | التخزين | النماذج المدعومة |
|---|---|---|---|---|---|
| مبتدئ / نموذج صغير | معالج حديث بأربعة أنوية | 8 جيجابايت | بدون GPU أو GPU بـ 4 جيجابايت VRAM | SSD 20 جيجابايت | نماذج 2B–7B مكممة |
| استخدام شخصي متقدم | i5-12400 أو Ryzen 5 5600 | 32 جيجابايت | RTX 3060 12GB | NVMe 500 جيجابايت | نماذج 7B–14B |
| فريق صغير (5–8 مستخدمين) | i7-13700 أو Ryzen 7 7700X | 64 جيجابايت DDR5 | RTX 4070 Ti Super 16GB | NVMe Gen4 1TB | نماذج 32B AWQ |
| إنتاجي (10–20 مستخدماً) | i9-14900K أو Ryzen 9 7950X | 128 جيجابايت | RTX 4090 24GB | NVMe Gen4 2TB | نماذج 70B AWQ |
| مؤسسي / بيانات حساسة | معالج خادم متعدد الأنوية | 256 جيجابايت | 2× RTX 4090 (48GB VRAM) | NVMe سعة كبيرة | 40+ مستخدماً متزامناً |
القاعدة العملية: ابدأ بذاكرة 32 جيجابايت وبطاقة رسوميات بذاكرة 12 جيجابايت على الأقل، ثم ارقِ تدريجياً بحسب النماذج التي تحتاجها فعلاً. وللاستخدام المؤسسي مع بيانات حساسة، يُفضل خادم مخصص مع مراعاة الامتثال للوائح حماية البيانات .
كيفية تثبييت وتشغل نموذج ذكاء اصطناعي محليا
بعد التعرف على النماذج المتاحة وأبرز البرامج المستخدمة لتشغيلها. تأتي المرحلة العملية الفعلية وهي تنزيل النموذج وتشغيله لأول مرة على الجهاز. تتشابه هذه العملية إلى حد كبير عبر مختلف الأدوات المتاحة، وتتكون بشكل عام من ثلاث خطوات رئيسية متسلسلة. وهي تحديد مصدر النموذج الموثوق، ثم تثبيت البرنامج المشغل المناسب. وأخيرا تنزيل النموذج المختار وتشغيله فعليا داخل هذا البرنامج.
من المهم التعامل مع هذه العملية بشيء من الصبر في المرة الأولى. خاصة أن حجم بعض النماذج قد يستغرق وقتا للتنزيل حسب سرعة الاتصال بالإنترنت المتوفرة. لكن بمجرد اكتمال هذه الخطوة يصبح النموذج جاهزا للاستخدام الفوري والمتكرر دون الحاجة لتكرار عملية التنزيل مرة أخرى. تشمل أهم النقاط العملية التي يجب مراعاتها في هذه المرحلة ما يلي:
- التأكد من توفر مساحة تخزين كافية قبل بدء عملية التنزيل
- اختيار النسخة المضغوطة المناسبة من النموذج بناء على إمكانيات الجهاز
- التحقق من استقرار الاتصال بالإنترنت أثناء عملية التنزيل الأولى
- قراءة الوثائق الأساسية المرفقة مع كل نموذج قبل بدء الاستخدام
من أين تحصل على النماذج المحلية؟
يعتبر موقع Hugging Face المصدر الأشهر والأوسع انتشارا للحصول على نماذج الذكاء الاصطناعي مفتوحة المصدر. حيث يستضيف آلاف النماذج المختلفة من عدة جهات مطورة. مع توفير معلومات تفصيلية عن كل نموذج تشمل حجمه ومتطلبات تشغيله وأداءه في الاختبارات المعيارية. ويمثل نقطة انطلاق ممتازة لمن يرغب في استكشاف الخيارات المتاحة ومقارنتها بعناية قبل اتخاذ القرار النهائي.
بديل آخر أبسط بكثير للمبتدئين يتمثل في المكتبات المدمجة داخل برامج التشغيل نفسها. مثل مكتبة Ollama الخاصة التي تضم مجموعة مختارة من أشهر النماذج جاهزة للتنزيل المباشر بأمر واحد بسيط دون الحاجة للبحث في مصادر خارجية متعددة. هذا الخيار يوفر وقتا وجهدا كبيرين على المستخدم الجديد الذي لا يرغب في الخوض في تفاصيل تقنية معقدة منذ البداية.
من المهم دائما التأكد من تنزيل النماذج من مصادر موثوقة ومعروفة فقط. وتجنب أي مصادر غير رسمية قد تحتوي على نسخ معدلة أو غير آمنة من النماذج الأصلية. المصادر الرسمية للشركات المطورة، إلى جانب المنصات المعروفة مثل Hugging Face، تظل الخيار الأكثر أمانا واستقرارا على المدى الطويل.
كيف تثبت أداة تشغيل النماذج؟
تختلف خطوات التثبيت قليلا حسب الأداة المختارة ونظام التشغيل المستخدم. لكنها تشترك جميعا في بساطة نسبية تناسب حتى المستخدمين غير المتخصصين تقنيا. بشكل عام تتضمن عملية التثبيت الخطوات التالية:
- تنزيل ملف التثبيت الرسمي من الموقع الخاص بالأداة المختارة
- تشغيل ملف التثبيت واتباع التعليمات الظاهرة على الشاشة
- التأكد من اكتمال التثبيت عبر تشغيل الأداة والتحقق من ظهورها بشكل صحيح
- مراجعة إعدادات الأداة الأساسية قبل الانتقال لتنزيل أول نموذج
كيفية تثبيت واستخدام الذكاء الاصطناعي المحلي؟
لا يستغرق البدء أكثر من خمس دقائق باستخدام الأدوات المناسبة. إليك أسرع طريقتين:
الطريقة الأولى: التثبيت المحلي عبر Ollama
الخطوة 1: تثبيت Ollama
Ollama هو محرك استدلال مجاني ومفتوح المصدر يعمل على macOS وLinux وWindows. ثبته بأمر واحد:
# macOS / Linux
curl -fsSL https://ollama.ai/install.sh | sh
الخطوة 2: تشغيل أول نموذج
اسحب وشغل نموذجا بأمر واحد:
# نموذج عام ممتاز
ollama run llama3.2

# نموذج صغير وسريع للاختبار
ollama run phi3

# نموذج متخصص في البرمجة
ollama run deepseek-coder-v2
التشغيل الأول ينزل النموذج بحجم بضعة جيجابايت. أما التشغيلات اللاحقة فتبدأ فورا.
الخطوة 3: إضافة واجهة مستخدم (اختياري)
لتجربة أغنى مع سجل المحادثات وتبديل النماذج وميزات متقدمة:
# Open WebUI (يتطلب Docker)
docker run -d -p 3000:8080 \
  --add-host=host.docker.internal:host-gateway \
  -v open-webui:/app/backend/data \
  --name open-webui \
  ghcr.io/open-webui/open-webui:main
أو نزل LM Studio للحصول على تجربة سطح مكتب أصلية.
الخطوة 4: الاستكشاف والتجربة
بعد تشغيل النموذج، جرب مهام مختلفة:
- اطلب منه شرح كود أو كتابة دوال أو تصحيح أخطاء
- اطلب منه تلخيص مستندات أو مقالات
- استخدمه للعصف الذهني والكتابة الإبداعية
- ابن خط RAG فوق مستنداتك باستخدام LangChain
الطريقة الثانية: التثبيت على خادم افتراضي VPS
تشغيل LocalAI على خادم افتراضي VPS عملية بسيطة يمكن إنجازها في خطوات قليلة. نستخدم Docker لتجنب التعقيدات الإضافية.
1. تثبيت المتطلبات الأساسية
sudo apt update && sudo apt upgrade -y
sudo apt install -y docker.io docker-compose
sudo systemctl enable docker
sudo systemctl start docker
2. تنزيل المستودع وتجهيزه
git clone https://github.com/go-skynet/LocalAI.git
cd LocalAI
أو استخدم صورة Docker مباشرة:
docker pull localai/localai:latest
3. تنزيل نموذج الذكاء الاصطناعي
للبداية، يفضل استخدام نموذج خفيف مثل Mistral-7B. النماذج تنشر بصيغة GGUF ويجب وضعها في مسار محدد:
mkdir -p models
cd models
wget https://huggingface.co/TheBloke/Mistral-7B-Instruct-GGUF/resolve/main/mistral-7b-instruct.Q4_K_M.gguf
4. التشغيل باستخدام Docker
docker run -it --rm -p 8080:8080 \
  -v $(pwd)/models:/models \
  -e MODELS_PATH=/models \
  localai/localai:latest
الآن LocalAI متاح على المنفذ 8080.
5. اختبار API باستخدام Curl
curl http://localhost:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mistral-7b-instruct.Q4_K_M.gguf",
    "messages": [{"role":"user","content":"مرحبا! ما هو LocalAI؟"}]
  }'
إذا تم كل شيء بشكل صحيح، ستتلقى رداً مشابهاً لـ ChatGPT.
6. الاستخدام مع Python
from openai import OpenAI
client = OpenAI(base_url="http://localhost:8080/v1", api_key="not-needed")
resp = client.chat.completions.create(
    model="mistral-7b-instruct.Q4_K_M.gguf",
    messages=[{"role": "user", "content": "أعطني شرحا قصيرا عن LocalAI"}]
)
print(resp.choices[0].message.content)
بهذه الخطوات البسيطة، تكون قد شغلت LocalAI على خادمك الافتراضي واستخدمته تماما مثل واجهات OpenAI API. الفرق الوحيد أن جميع العمليات تتم محليا دون الحاجة لدفع تكاليف أو إرسال بيانات لخوادم خارجية.
ما استخدامات الذكاء الاصطناعي المحلي في العمل والحياة؟
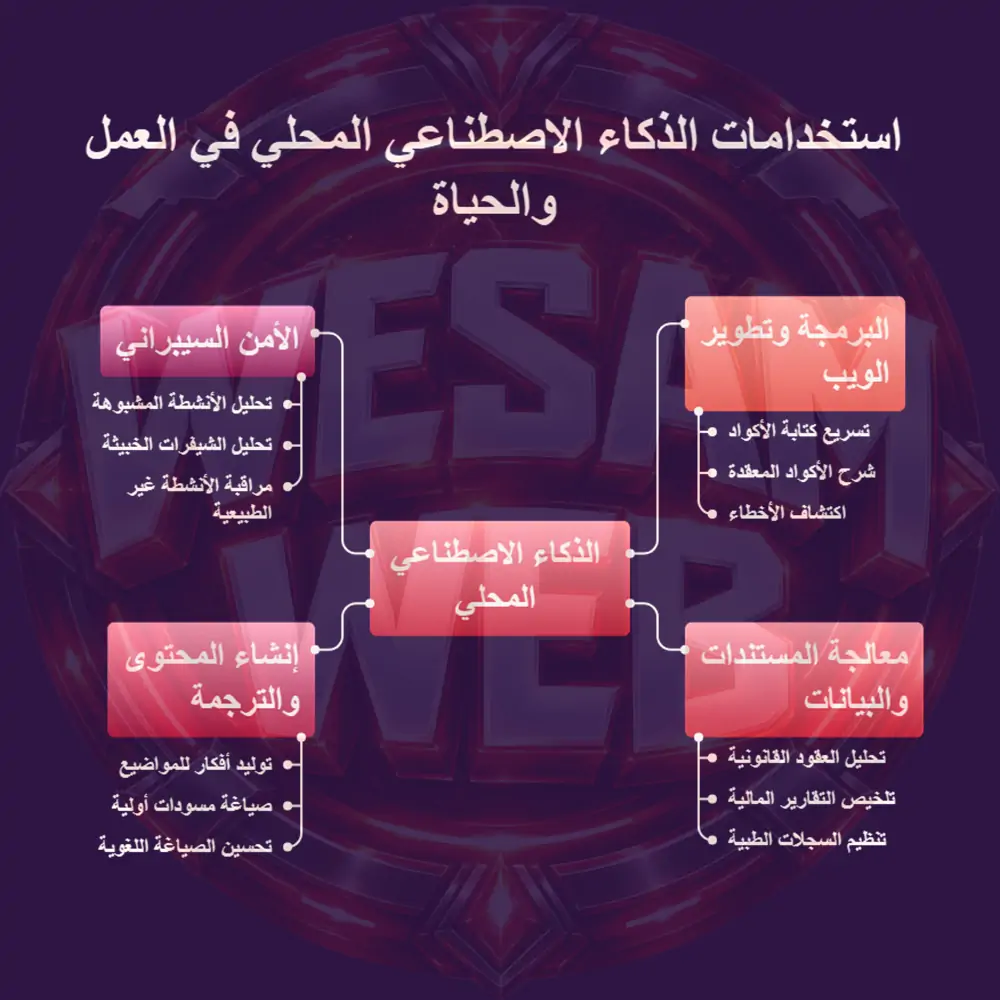
تجاوز الذكاء الاصطناعي المحلي مرحلة كونه أداة تجريبية للهواة. ليصبح جزءا فعليا من سير العمل اليومي للكثير من المهنيين في مجالات متنوعة. وذلك بفضل الجمع بين قوة النماذج الحديثة والخصوصية الكاملة التي يوفرها التشغيل على الجهاز الشخصي. يمتد نطاق هذه الاستخدامات من المهام التقنية البحتة مثل البرمجة، وصولا إلى المهام الإبداعية مثل كتابة المحتوى، مرورا بمعالجة المستندات والبيانات الحساسة التي تتطلب مستوى عاليا من الأمان.
يساعد استعراض هذه الاستخدامات العملية القارئ على تكوين تصور واقعي عن القيمة المضافة الفعلية لهذه التقنية في حياته المهنية أو الشخصية. بدلا من النظر إليها كمجرد مفهوم نظري مجرد. الأقسام الفرعية التالية تتناول أربعة مجالات رئيسية تشهد إقبالا متزايدا على تبني هذا النهج، وهي البرمجة، ومعالجة المستندات، وإنشاء المحتوى، والأمن السيبراني، مع أمثلة عملية توضح كيفية الاستفادة الفعلية في كل مجال.
كيف تستخدمه في البرمجة وتطوير الويب؟
أصبح الذكاء الاصطناعي المحلي أداة مساعدة أساسية لكثير من المطورين. خاصة مع توفر نماذج متخصصة في فهم الأكواد البرمجية وتوليدها بدقة عالية. مثل النماذج المشتقة من عائلة Qwen التي أثبتت أداء متميزا في هذا المجال تحديدا. يستفيد المطورون من هذه النماذج في تسريع كتابة الأكواد المتكررة. وشرح أجزاء معقدة من الشيفرة البرمجية، والمساعدة في اكتشاف الأخطاء البرمجية وإصلاحها بسرعة أكبر.
تظهر أهمية العامل المحلي بشكل خاص عند العمل على مشاريع تحتوي على شيفرة برمجية سرية أو خاصة بشركة معينة. حيث يشكل إرسال هذه الشيفرة إلى خدمة سحابية خارجية مخاطرة أمنية قد ترفضها كثير من سياسات الشركات الداخلية. يسمح التشغيل المحلي للمطور بالاستفادة الكاملة من قدرات الذكاء الاصطناعي دون أي مخاوف تتعلق بتسريب الملكية الفكرية أو الشيفرة المصدرية الحساسة.
إضافة إلى ذلك، توفر بعض بيئات التطوير الحديثة إمكانية دمج النماذج المحلية مباشرة داخل محرر الأكواد نفسه. ما يمنح المطور تجربة سلسة مشابهة لأدوات المساعدة البرمجية السحابية المعروفة. لكن مع الحفاظ الكامل على خصوصية المشروع والاستمرار في العمل حتى في حالة انقطاع الاتصال بالإنترنت أثناء التطوير.
كيف تستخدمه مع الملفات والمستندات والبيانات؟
يمثل التعامل مع المستندات والملفات الحساسة أحد أكثر المجالات استفادة من مزايا الذكاء الاصطناعي المحلي. حيث يمكن للمستخدم رفع مستندات كاملة مثل العقود القانونية أو التقارير المالية أو السجلات الطبية. ثم طرح أسئلة مباشرة حول محتواها أو طلب تلخيصها. دون أي قلق بشأن مغادرة هذا المحتوى الحساس لحدود الجهاز الشخصي في أي مرحلة من مراحل المعالجة.
تستخدم هذه القدرة على نطاق واسع في القطاعات التي تتعامل يوميا مع كميات كبيرة من المستندات السرية. مثل المكاتب القانونية التي تحتاج إلى مراجعة سريعة لعقود طويلة. والمؤسسات المالية التي تتعامل مع تقارير حساسة. والجهات الطبية التي تحتاج إلى تنظيم سجلات المرضى بسرعة دون المساس بسرية المعلومات الطبية المحمية بموجب قوانين صارمة في كثير من الدول.
يمتد هذا الاستخدام أيضا إلى تحليل البيانات الجدولية المخزنة في ملفات جداول البيانات. حيث يمكن لنموذج محلي مدعوم بأدوات مناسبة أن يساعد في استخراج أنماط معينة من البيانات، أو صياغة تقارير موجزة بناء على أرقام معقدة. وكل ذلك يتم محليا دون الحاجة لرفع أي بيانات حساسة إلى أي خدمة تحليل سحابية خارجية.
كيف تستخدمه في إنشاء المحتوى والترجمة؟
يستفيد صناع المحتوى وكتاب المقالات بشكل متزايد من الذكاء الاصطناعي المحلي كأداة مساعدة في مراحل مختلفة من عملية الكتابة. بدءا من توليد أفكار أولية للمواضيع، مرورا بصياغة مسودات أولية سريعة، وصولا إلى مراجعة النصوص المكتوبة وتحسين صياغتها اللغوية. يوفر هذا النهج مرونة كبيرة للكتاب الذين يفضلون العمل دون اتصال دائم بالإنترنت أو الذين يتعاملون مع محتوى حصري لم يحن وقت نشره بعد.
في مجال الترجمة، تقدم النماذج المحلية بديلا عمليا جيدا للترجمة الفورية بين اللغات المختلفة. خاصة مع تحسن دعم اللغات غير الإنجليزية في الإصدارات الحديثة من هذه النماذج. يستفيد من هذه الميزة المترجمون المستقلون الذين يتعاملون مع نصوص سرية تخص عملاءهم. حيث يسمح التشغيل المحلي بإنجاز عملية الترجمة الأولية دون مشاركة محتوى العميل الحصري مع أي خدمة سحابية خارجية.
كما يستخدم صناع المحتوى الرقمي هذه النماذج أيضا في إعداد نسخ متعددة من نفس المحتوى بلهجات أو أساليب مختلفة، أو في تحويل محتوى مكتوب إلى صيغ صوتية باستخدام نماذج تحويل النص إلى صوت المحلية. ما يوسع نطاق الاستفادة من محتوى واحد عبر منصات وجماهير مختلفة دون تكاليف إضافية متكررة.
كيف تستخدمه في الأمن السيبراني والبيانات الحساسة؟
يجد متخصصو الأمن السيبراني في التشغيل المحلي حلا مثاليا لتحليل الأنشطة المشبوهة والسجلات الأمنية دون الحاجة لإرسال هذه البيانات الحساسة إلى أي خدمة خارجية. وهو أمر بالغ الأهمية عند التعامل مع بيانات تتعلق بثغرات أمنية محتملة أو حوادث اختراق فعلية لم يتم الإفصاح عنها علنا بعد. يسمح استخدام نموذج محلي بتحليل هذه المعلومات بسرعة مع الحفاظ التام على سريتها.
يستخدم هذا النهج أيضا في تحليل الشيفرات البرمجية الخبيثة المشتبه بها داخل بيئة معزولة تماما عن الشبكة. حيث يساعد النموذج المحلي في فهم سلوك هذا النوع من الشيفرات دون أي حاجة للاتصال بالإنترنت الذي قد يشكل خطرا إضافيا أثناء عملية التحليل نفسها. هذه القدرة على العمل في بيئة معزولة بالكامل تعتبر من أهم متطلبات العمل الآمن في هذا المجال المتخصص.
إضافة إلى ذلك، تستفيد فرق الأمان الداخلية في المؤسسات الكبيرة من إمكانية بناء أدوات مخصصة قائمة على نماذج محلية لمراقبة الأنشطة غير الطبيعية في الشبكة الداخلية. مع ضمان بقاء كل البيانات المرصودة ضمن الحدود الجغرافية والتقنية للمؤسسة. وهو متطلب أساسي في كثير من الأطر التنظيمية الصارمة المتعلقة بحماية البيانات الحكومية والمالية الحساسة.
هل يمكن استخدام الذكاء الاصطناعي المحلي داخل الشركات؟
نعم، ويشهد هذا الاتجاه نموا ملحوظا بين المؤسسات من مختلف الأحجام. خاصة تلك التي تتعامل مع بيانات حساسة أو تخضع لأطر تنظيمية صارمة تفرض قيودا على مكان تخزين ومعالجة بيانات العملاء. يختلف الاستخدام المؤسسي عن الاستخدام الفردي في نطاقه وتعقيده. حيث يتطلب غالبا بنية تحتية أكثر قوة قادرة على خدمة عدد كبير من الموظفين في وقت واحد بدلا من مستخدم فردي واحد.
يتيح هذا النهج للشركات الاستفادة من قدرات الذكاء الاصطناعي المتقدمة دون التنازل عن السيطرة الكاملة على بياناتها الداخلية. وهو ما يمثل توازنا مهما بين الاستفادة من التقنية الحديثة والالتزام بمعايير الأمان والامتثال التنظيمي المفروضة على كثير من القطاعات. تشمل أبرز الفوائد المؤسسية لهذا النهج ما يلي:
- سيطرة كاملة على بيانات العملاء دون مشاركتها مع أي طرف خارجي
- إمكانية تخصيص النموذج ليتوافق مع طبيعة عمل المؤسسة تحديدا
- تقليل التكاليف التراكمية مقارنة بالاشتراكات السحابية طويلة الأمد
- الامتثال الأسهل لمتطلبات حماية البيانات في القطاعات الحساسة
متى يكون التشغيل المحلي أفضل للشركات؟
يصبح التشغيل المحلي خيارا استراتيجيا واضحا عندما تتعامل الشركة مع بيانات تصنف كحساسة بموجب القوانين المحلية أو الدولية. مثل البيانات المالية للعملاء أو السجلات الطبية أو المعلومات القانونية السرية. حيث يفرض كثير من هذه الأطر قيودا صارمة على نقل هذه البيانات خارج حدود معينة أو مشاركتها مع أطراف ثالثة. وهو ما يجعل الاعتماد الكامل على الخدمات السحابية خيارا معقدا قانونيا في كثير من الأحيان.
يبرز هذا الخيار أيضا كحل عملي للشركات التي تعمل في بيئات ذات اتصال محدود أو غير مستقر بالإنترنت. مثل بعض المواقع الصناعية النائية أو الفروع في مناطق ضعيفة التغطية. حيث يضمن التشغيل المحلي استمرارية العمل دون اعتماد على جودة الاتصال بالشبكة الخارجية. كما يصبح خيارا اقتصاديا جذابا للشركات ذات الحجم الكبير من الاستخدام اليومي. حيث تتفوق تكلفة الاستثمار في بنية تحتية داخلية على تكلفة الاشتراكات السحابية المتراكمة على المدى الطويل.
في المقابل، يبقى الخيار السحابي أكثر منطقية للشركات الصغيرة ذات الاستخدام المحدود أو غير المنتظم. حيث لا يبرر حجم الاستخدام الفعلي تكلفة الاستثمار في بنية تحتية داخلية كاملة. وهو ما يفتح المجال لنقاش أوسع حول النهج الهجين الذي سيتم تناوله بتفصيل أكبر في قسم لاحق من هذا الدليل.
هل يمكن ربطه بقواعد البيانات وواجهات API؟
نعم، ويعتبر هذا الدمج أحد أهم العوامل التي تجعل الذكاء الاصطناعي المحلي خيارا عمليا للاستخدام المؤسسي الحقيقي بدلا من كونه مجرد أداة محادثة معزولة. يمكن ربط النموذج المحلي بقواعد بيانات المؤسسة الداخلية من خلال طبقة وسيطة تسمح للنموذج بالوصول إلى معلومات محدثة وسياقية عند الإجابة عن استفسارات الموظفين. وهو أسلوب يعرف تقنيا بتقنية الاسترجاع المعزز بالتوليد. والتي تحسن بشكل كبير من دقة إجابات النموذج بناء على بيانات المؤسسة الفعلية بدلا من الاعتماد فقط على معرفته العامة المكتسبة أثناء التدريب.
كما يمكن للمطورين بناء واجهات برمجة تطبيقات داخلية خاصة تتيح للأنظمة والتطبيقات المختلفة داخل المؤسسة التواصل مع النموذج المحلي بشكل موحد ومنظم. تماما كما تتواصل هذه الأنظمة مع أي خدمة سحابية خارجية. لكن مع بقاء كامل تدفق البيانات داخل الشبكة الداخلية للمؤسسة. تشمل أبرز أشكال هذا الدمج العملي ما يلي:
- ربط النموذج بقواعد بيانات المستندات الداخلية للإجابة عن استفسارات دقيقة
- بناء واجهات برمجية داخلية لدمج النموذج مع أنظمة إدارة العملاء
- أتمتة مهام تحليل البيانات المتكررة عبر استدعاءات برمجية مجدولة
- ربط النموذج بأنظمة خدمة العملاء الداخلية لتحسين سرعة الاستجابة
ما علاقته بـ VPS والاستضافة وKubernetes؟

عندما يتجاوز الاستخدام المؤسسي حدود الجهاز الفردي الواحد. تصبح الحاجة ملحة لاستضافة النموذج على بنية تحتية أقوى قادرة على خدمة عدد أكبر من المستخدمين في وقت واحد. وهنا يأتي دور خوادم VPS المخصصة التي توفر موارد حاسوبية مخصصة يمكن تكوينها بدقة لتناسب متطلبات تشغيل النموذج المستهدف. مع الاحتفاظ بكامل السيطرة على البيئة التقنية المحيطة بها دون مشاركتها مع أي مستخدم آخر.
في السيناريوهات الأكبر حجما التي تتطلب توزيع الحمل عبر عدة خوادم أو ضمان استمرارية الخدمة دون انقطاع. تدخل تقنية Kubernetes كأداة أساسية لإدارة وتنسيق تشغيل النموذج عبر مجموعة من الحاويات البرمجية الموزعة. ما يسمح بالتوسع التلقائي حسب حجم الطلب الفعلي وضمان استمرار الخدمة حتى في حال تعطل أحد الخوادم داخل المجموعة. هذا النهج يتطلب خبرة تقنية أعمق، لكنه يوفر مستوى من الموثوقية يناسب المؤسسات ذات الاستخدام الكثيف والمستمر.
يمثل هذا الترابط بين الذكاء الاصطناعي المحلي والبنية التحتية التقليدية للاستضافة والحوسبة السحابية الداخلية نقطة التقاء مهمة بين مجالين تقنيين كانا يبدوان منفصلين سابقا. حيث تصبح خبرة إدارة الخوادم وقواعد البيانات والحاويات البرمجية جزءا أساسيا من أي مشروع جاد يهدف إلى تبني هذه التقنية على مستوى مؤسسي حقيقي بدلا من الاستخدام الفردي المحدود.
هل الذكاء الاصطناعي المحلي آمن فعلا؟
يثار سؤال الأمان بشكل متكرر عند الحديث عن أي تقنية جديدة. ورغم أن الذكاء الاصطناعي المحلي يوفر مستوى عاليا من الخصوصية بحكم تصميمه الأساسي. إلا أن هذا لا يعني أنه خال تماما من أي مخاطر أمنية محتملة يجب على المستخدم الانتباه إليها. الأمان في هذا السياق مفهوم متعدد الأبعاد يتجاوز مجرد بقاء البيانات داخل الجهاز. ليشمل أيضا مصدر النموذج نفسه وطريقة إعداده وحماية الوصول إليه من أي استخدام غير مصرح به.
ما المخاطر الأمنية للنماذج المحلية؟
أحد أبرز المخاطر المحتملة يتعلق بتنزيل نماذج من مصادر غير موثوقة أو غير رسمية. حيث قد تحتوي بعض هذه النسخ المعدلة على شيفرة خبيثة مدمجة أو سلوك غير متوقع تم زرعه عمدا. وهو ما يستوجب الحرص الدائم على التنزيل من مصادر معروفة وموثقة فقط مثل المنصات الرسمية للشركات المطورة أو المستودعات الكبرى المعروفة بمراجعتها الأمنية للمحتوى المستضاف عليها.
خطر آخر يتعلق بإعدادات الوصول إلى واجهة النموذج المحلي نفسها. خاصة عند تشغيله على خادم متاح عبر الشبكة الداخلية لخدمة عدة مستخدمين. حيث قد يؤدي الإعداد غير الدقيق لهذه الواجهة إلى إتاحة الوصول لأشخاص غير مصرح لهم أو حتى لأي شخص متصل بالشبكة نفسها دون أي مصادقة حقيقية. وهو ما يشكل ثغرة أمنية حقيقية إذا لم يتم التعامل معها بجدية كافية منذ البداية.
كما تجدر الإشارة إلى أن أمان الجهاز المضيف نفسه يبقى عاملا حاسما. فحتى لو كان النموذج المحلي آمنا تماما من الناحية النظرية. فإن أي اختراق للجهاز المضيف نفسه عبر ثغرات أخرى غير متعلقة بالنموذج قد يعرض كل البيانات المعالجة عليه للخطر. بما في ذلك أي محادثات أو مستندات حساسة تمت معالجتها سابقا عبر النموذج المحلي.
كيف تحمي النموذج والبيانات وواجهة الوصول؟
- تنزيل النماذج حصريا من مصادر رسمية وموثوقة ومعروفة
- تحديث برنامج التشغيل والنموذج بشكل دوري لسد أي ثغرات مكتشفة
- تفعيل مصادقة قوية عند إتاحة الوصول للنموذج عبر الشبكة الداخلية
- عزل بيئة التشغيل عن الشبكة العامة عند التعامل مع بيانات بالغة الحساسية
- الحفاظ على تحديث نظام التشغيل والحماية العامة للجهاز المضيف
أيهما تختار، الذكاء الاصطناعي المحلي أم السحابي أم الهجين؟
بعد استعراض كافة الجوانب التقنية والعملية في الأقسام السابقة. يبقى السؤال الأهم بالنسبة لمعظم القراء هو أي المسارات الثلاثة يناسب احتياجاتهم الفعلية. فالخيار الصحيح ليس واحدا موحدا يناسب الجميع، بل يعتمد بشكل كبير على طبيعة الاستخدام المستهدف ومستوى الحساسية المطلوب في البيانات المعالجة والموارد المتاحة فعليا لدى المستخدم أو المؤسسة.
يجمع النهج الهجين بين مزايا الطريقتين من خلال استخدام النموذج المحلي للمهام الحساسة أو المتكررة يوميا. مع الرجوع إلى النماذج السحابية الأضخم عند الحاجة إلى قدرات متقدمة تتجاوز إمكانيات العتاد المحلي المتوفر. يلخص الجدول التالي أبرز السيناريوهات المناسبة لكل خيار من الخيارات الثلاثة بشكل مباشر ومختصر.
| السيناريو | الخيار الأنسب |
|---|---|
| بيانات حساسة قانونيا أو طبيا | الذكاء الاصطناعي المحلي |
| استخدام عرضي وغير منتظم | الذكاء الاصطناعي السحابي |
| ميزانية محدودة على المدى الطويل | الذكاء الاصطناعي المحلي |
| حاجة لأقوى النماذج المتاحة عالميا | الذكاء الاصطناعي السحابي |
| مؤسسة كبيرة متنوعة الاحتياجات | النهج الهجين |
| بيئة عمل ضعيفة الاتصال بالإنترنت | الذكاء الاصطناعي المحلي |
متى تختار الذكاء الاصطناعي المحلي؟
يعتبر الخيار المحلي الأنسب عندما تكون الخصوصية أولوية قصوى لا يمكن التهاون بشأنها. كما هو الحال عند التعامل مع بيانات العملاء الشخصية أو الملفات القانونية السرية أو السجلات الطبية الحساسة. حيث يوفر هذا النهج ضمانا كاملا بعدم مغادرة أي من هذه البيانات لحدود الجهاز أو الشبكة الداخلية للمؤسسة في أي مرحلة من المعالجة.
يناسب هذا الخيار أيضا المستخدمين والمؤسسات ذات الاستخدام اليومي المكثف والمنتظم. حيث يصبح الاستثمار المبدئي في العتاد المناسب مجديا اقتصاديا على المدى الطويل مقارنة بالتكلفة المتراكمة للاشتراكات السحابية المتكررة شهريا. كما يعتبر خيارا ممتازا لمن يعمل في بيئات ضعيفة الاتصال بالإنترنت أو ينتقل باستمرار بين مواقع عمل مختلفة دون ضمان توفر شبكة مستقرة.
أخيرا، يناسب هذا الخيار بشكل خاص المطورين والمتخصصين التقنيين الراغبين في التجربة العميقة والتخصيص الدقيق لسلوك النموذج. وهو مستوى من التحكم لا توفره عادة الواجهات السحابية المقيدة بسياسات وإعدادات محددة مسبقا من قبل مزود الخدمة.
متى تختار الذكاء الاصطناعي السحابي؟
يظل الخيار السحابي الأنسب للمستخدمين الذين يحتاجون إلى أقوى النماذج المتاحة عالميا لمهام معقدة للغاية تتجاوز بكثير قدرات أي عتاد شخصي عادي. حيث تمتلك الشركات الكبرى المشغلة لهذه الخدمات بنية تحتية ضخمة يصعب مجاراتها بأي استثمار فردي معقول في العتاد الشخصي.
يناسب هذا الخيار أيضا المستخدمين الذين يبحثون عن بداية سريعة دون أي تعقيد تقني. حيث يكفي فتح حساب والبدء بالاستخدام الفوري دون الحاجة لأي إعداد أو معرفة تقنية مسبقة بمفاهيم العتاد والبرمجيات الوسيطة. هذا يجعله خيارا مثاليا للمستخدم العرضي الذي لا يحتاج إلى استخدام يومي مكثف يبرر الاستثمار في بنية تحتية محلية خاصة.
كما يظل هذا الخيار منطقيا أكثر للشركات الصغيرة ذات الاستخدام المحدود وغير المنتظم. حيث لا يبرر حجم الاستخدام الفعلي تكلفة بناء بنية تحتية داخلية كاملة. إضافة إلى الاستفادة من التحديثات المستمرة التي يقدمها المزود دون أي جهد إضافي مطلوب من طرف المستخدم نفسه.
متى يكون الذكاء الاصطناعي الهجين هو الأفضل؟
يبرز النهج الهجين كخيار مثالي للمؤسسات متوسطة وكبيرة الحجم ذات الاحتياجات المتنوعة. حيث تستخدم النموذج المحلي للمهام اليومية المتكررة والحساسة. بينما تحتفظ بإمكانية الرجوع إلى النماذج السحابية الأضخم عند الحاجة الفعلية لقدرات متقدمة تتجاوز إمكانيات العتاد المحلي المتوفر لديها في حالات استثنائية محدودة.
يوفر هذا النهج توازنا عمليا ذكيا بين التحكم الكامل في البيانات الحساسة والاستفادة من أحدث التطورات التقنية المتاحة في السوق. دون التقيد الكامل بأي من الخيارين المتطرفين. يسمح أيضا بتوزيع التكلفة بشكل أكثر مرونة. حيث يتم تخصيص الاستثمار في العتاد المحلي بناء على الاحتياج الفعلي اليومي. مع الاحتفاظ بميزانية محدودة للاستخدام السحابي العرضي عند الضرورة القصوى فقط.
يتطلب تبني هذا النهج مستوى معينا من النضج التقني داخل المؤسسة لإدارة كلا النظامين بكفاءة والانتقال بينهما بسلاسة.ا بسلاسة حسب طبيعة كل مهمة. لكن هذا الجهد الإضافي غالبا ما يستحق العناء بالنظر إلى المرونة الكبيرة التي يوفرها هذا التوازن الدقيق بين الاستقلالية والقدرة المتقدمة المطلوبة أحيانا.
ما مستقبل الذكاء الاصطناعي المحلي؟
يشير المسار الحالي لتطور هذا المجال إلى مستقبل واعد بشكل خاص. مدفوعا بتحسن مستمر في كفاءة النماذج من جهة. وتطور موازٍ في قدرات العتاد الاستهلاكي المتاح للمستخدم العادي من جهة أخرى. هذا التقارب بين الاتجاهين يجعل من المرجح أن يصبح الذكاء الاصطناعي المحلي جزءا أكثر انتشارا وطبيعية في حياتنا التقنية اليومية خلال السنوات القليلة القادمة. بدلا من بقائه خيارا متخصصا يقتصر على المطورين والمهتمين التقنيين فقط.
كيف ستغير وحدات NPU مستقبل تشغيل الذكاء الاصطناعي؟
تمثل وحدات NPU المتخصصة أحد أهم محركات التغيير المتوقعة في هذا المجال خلال السنوات القادمة. حيث تهدف هذه الوحدات إلى تسريع عمليات الشبكات العصبية بكفاءة طاقة أعلى بكثير مقارنة بالاعتماد التقليدي على المعالج المركزي أو حتى بطاقة الرسوميات العامة. وهو ما يعني عمليا إمكانية تشغيل نماذج أقوى على أجهزة أصغر حجما وأقل استهلاكا للطاقة من الأجهزة الحالية.
بدأت الشركات المصنعة الكبرى مثل Intel وAMD دمج هذه الوحدات ضمن معالجاتها الحديثة المخصصة للحواسيب المحمولة والهواتف الذكية. وهو اتجاه من المتوقع أن يتسارع بشكل ملحوظ مع ازدياد الطلب على تشغيل الذكاء الاصطناعي محليا. هذا التطور سيقلل تدريجيا من الفجوة الحالية في الأداء بين الأجهزة المزودة ببطاقات رسوميات قوية مخصصة وتلك التي تعتمد على مكونات أخف وأقل استهلاكا للطاقة.
من المتوقع أيضا أن يترافق هذا التطور في العتاد مع تحسن مواز في دعم البرمجيات لهذه الوحدات المتخصصة. حيث ما زال هذا الدعم في مراحله المبكرة نسبيا مقارنة بالدعم الناضج المتوفر لبطاقات الرسوميات التقليدية. وهو ما يفتح المجال أمام تحسينات كبيرة محتملة في الأداء الفعلي خلال الفترة القادمة مع نضج هذه البيئة البرمجية بشكل أكبر.
هل سيصبح الذكاء الاصطناعي المحلي جزءا أساسيا من أجهزتنا؟
كل المؤشرات الحالية تشير بوضوح نحو هذا الاتجاه. حيث بدأت شركات تصنيع الأجهزة الكبرى بالفعل في الترويج لقدرات الذكاء الاصطناعي المحلية كميزة أساسية في منتجاتها الحديثة. بدلا من اعتبارها إضافة اختيارية ثانوية كما كان الحال في السنوات السابقة القليلة. هذا التحول في استراتيجية التسويق يعكس إدراكا واضحا لدى الشركات المصنعة بأن هذه القدرة أصبحت عامل تفضيل حقيقي لدى المستهلكين الباحثين عن أجهزة قادرة على أداء مهام ذكية دون اعتماد كامل على اتصال دائم بالإنترنت.
من المتوقع أن نشهد خلال السنوات القليلة القادمة أنظمة تشغيل كاملة تدمج نماذج ذكاء اصطناعي محلية بشكل أساسي ضمن وظائفها الافتراضية. بحيث يصبح التفاعل الذكي مع الملفات والمهام اليومية جزءا طبيعيا من تجربة استخدام الجهاز بدلا من كونه تطبيقا منفصلا يحتاج المستخدم لتثبيته وإعداده بشكل يدوي منفصل عن باقي مكونات النظام.
هذا التوجه سيقلل تدريجيا من الحاجز التقني الحالي أمام المستخدم العادي غير المتخصص. حيث سيصبح تشغيل نموذج محلي أمرا بسيطا ومباشرا مدمجا في تجربة الجهاز الافتراضية. بدلا من عملية تتطلب معرفة تقنية مسبقة بمفاهيم مثل اختيار النموذج المناسب وتثبيت البرنامج المشغل. وهو التعقيد النسبي الذي ما زال يشكل عائقا أمام انتشار أوسع لهذه التقنية حاليا بين عموم المستخدمين.
هل سيحل الذكاء الاصطناعي المحلي محل السحابة؟
من غير المرجح أن يحل الذكاء الاصطناعي المحلي محل النموذج السحابي بشكل كامل في المستقبل المنظور، بل من الأرجح أن يستمر النهجان في التعايش جنبا إلى جنب. كل واحد منهما يخدم احتياجات ونطاقات استخدام مختلفة نسبيا. فبينما يستمر التشغيل المحلي في التوسع في المهام اليومية المتكررة والحساسة. ستبقى النماذج السحابية الضخمة الخيار الأمثل للمهام البحثية والتحليلية شديدة التعقيد التي تتطلب قدرات حسابية تتجاوز بكثير إمكانيات أي جهاز شخصي مهما بلغت قوته.
من المرجح أن يتطور النهج الهجين ليصبح النمط السائد لدى المؤسسات المتوسطة والكبيرة. حيث تتوزع المهام بشكل ذكي بين النموذج المحلي والسحابي بناء على طبيعة كل مهمة ومستوى حساسيتها. تشمل أبرز العوامل التي ستحدد شكل هذا التوازن المستقبلي ما يلي:
- استمرار تحسن كفاءة النماذج المضغوطة مقارنة بحجمها الفعلي
- تطور وحدات المعالجة المتخصصة المدمجة في الأجهزة الاستهلاكية
- تشدد الأطر التنظيمية المتعلقة بحماية البيانات في مناطق مختلفة من العالم
- استمرار الحاجة إلى قدرات حسابية ضخمة لمهام بحثية متقدمة معينة
هل الذكاء الاصطناعي المحلي مناسب لك؟
بعد هذه الجولة الشاملة عبر مختلف جوانب هذه التقنية. يبقى السؤال الأخير والأهم بالنسبة للقارئ هو ما إذا كان هذا النهج مناسبا فعلا لاحتياجاته الشخصية أو المهنية المحددة. الإجابة الصادقة عن هذا السؤال تعتمد بشكل أساسي على طبيعة استخدام كل شخص ومستوى الحساسية المطلوب في البيانات التي يتعامل معها يوميا. وليس هناك إجابة واحدة تناسب الجميع بشكل مطلق ونهائي.
إذا كان القارئ يتعامل بشكل منتظم مع بيانات حساسة، أو يعمل في بيئة ضعيفة الاتصال بالإنترنت، أو يرغب في استقلالية تقنية كاملة بعيدا عن أي اعتماد على مزودي خدمة خارجيين. فإن الذكاء الاصطناعي المحلي يمثل خيارا يستحق الاستثمار الجاد فيه، سواء من ناحية الوقت المطلوب للتعلم أو التكلفة المبدئية في العتاد المناسب. أما إذا كان الاستخدام عرضيا وغير منتظم، ولا توجد حساسية خاصة في البيانات المتعامل معها. فقد يبقى الخيار السحابي أبسط وأكثر ملاءمة من الناحية العملية البحتة.
في نهاية المطاف، الخطوة الأنسب لأي قارئ مهتم بهذا المجال هي البدء بتجربة عملية بسيطة باستخدام أداة سهلة مثل Ollama أو LM Studio مع نموذج صغير الحجم. ثم تقييم التجربة الفعلية بناء على احتياجاته الحقيقية بدلا من الاعتماد فقط على القراءة النظرية. هذه الخطوة الأولى البسيطة غالبا ما تكون كافية لتكوين تصور واضح وعملي حول مدى ملاءمة هذا النهج لطريقة العمل والحياة اليومية الخاصة بكل شخص على حدة.
الأسئلة الشائعة
تتكرر مجموعة من الأسئلة العملية لدى كل من يبدأ رحلته مع الذكاء الاصطناعي المحلي. وقد تم تجميع أبرز هذه الأسئلة هنا في صيغة مختصرة ومباشرة لتكون مرجعا سريعا للقارئ بعد قراءة الدليل الكامل، أو حتى كنقطة دخول أولى سريعة لمن يريد إجابات مباشرة دون الخوض في كل التفاصيل الموسعة السابقة.
ما هو الذكاء الاصطناعي المحلي؟
هو تشغيل نماذج الذكاء الاصطناعي مباشرة على جهاز المستخدم بدلا من الاعتماد على خوادم سحابية بعيدة. بحيث تتم كل عمليات المعالجة داخل حدود الجهاز نفسه دون إرسال أي بيانات إلى أي طرف خارجي.
هل يمكن تشغيل الذكاء الاصطناعي المحلي بدون إنترنت؟
نعم، بعد تنزيل النموذج مرة واحدة يمكن استخدامه بالكامل دون أي اتصال بالإنترنت. باستثناء عمليات التحديث أو التنزيل الأولي للنماذج الجديدة.
هل الذكاء الاصطناعي المحلي أفضل من الذكاء الاصطناعي السحابي؟
لا يوجد أفضل مطلق، فالأمر يعتمد على الحاجة الفعلية، حيث يتفوق المحلي في الخصوصية والتكلفة طويلة المدى. بينما يتفوق السحابي في القدرات المتقدمة وسهولة البدء الفورية.
هل الذكاء الاصطناعي المحلي أكثر أمانا وخصوصية؟
نعم من حيث بقاء البيانات داخل الجهاز فقط. لكن الأمان الكامل يتطلب أيضا الحرص على تنزيل النماذج من مصادر موثوقة وضبط إعدادات الوصول بشكل صحيح.
ما مواصفات الكمبيوتر المطلوبة لتشغيل الذكاء الاصطناعي المحلي؟
تختلف حسب حجم النموذج. لكن كحد أدنى عملي تحتاج غالبا إلى ثمانية غيغابايت من الذاكرة على الأقل للنماذج الصغيرة. مع إمكانية الاستفادة الكبيرة من وجود بطاقة رسوميات مخصصة.
هل يمكن تشغيل الذكاء الاصطناعي المحلي بدون بطاقة رسومية GPU؟
نعم بالنسبة للنماذج الصغيرة والمتوسطة. لكن السرعة ستكون أبطأ بشكل ملحوظ مقارنة بالتشغيل على بطاقة رسوميات مخصصة، خاصة مع النماذج الأكبر حجما.
ما أفضل نماذج الذكاء الاصطناعي للتشغيل محليا في 2026؟
من أبرز الخيارات الموثوقة حاليا نماذج Llama وMistral وQwen وDeepSeek وGemma. ويختلف الاختيار الأنسب باختلاف طبيعة المهمة المطلوبة وحجم العتاد المتوفر.
ما أفضل برنامج لتشغيل نماذج الذكاء الاصطناعي محليا؟
يناسب Ollama مستخدمي سطر الأوامر والمطورين، بينما يناسب LM Studio من يفضل واجهة رسومية بسيطة. ويناسب Open WebUI من يريد واجهة ويب متقدمة قابلة للمشاركة.
كيف أنزل نموذج ذكاء اصطناعي وأشغله على جهازي؟
قم بتثبيت برنامج تشغيل مثل Ollama أو LM Studio. ثم اختر نموذجا صغيرا مناسبا لجهازك وقم بتنزيله من داخل البرنامج نفسه، وابدأ الاستخدام مباشرة بعد اكتمال التحميل.
هل يمكن تشغيل ChatGPT محليا على الكمبيوتر؟
لا، فنماذج ChatGPT مملوكة لشركة OpenAI وليست مفتوحة المصدر. لكن يمكن تشغيل نماذج مفتوحة بديلة مثل Llama أو Mistral توفر تجربة مشابهة نسبيا بشكل محلي كامل.
هل يمكن استخدام الذكاء الاصطناعي المحلي مع الملفات وقواعد البيانات؟
نعم، من خلال أدوات مخصصة تسمح للنموذج بالوصول إلى المستندات أو قواعد البيانات الداخلية والإجابة عن أسئلة مبنية على محتواها الفعلي محليا.
هل الذكاء الاصطناعي المحلي مناسب للشركات؟
نعم بشكل خاص للشركات التي تتعامل مع بيانات حساسة أو تخضع لأطر تنظيمية صارمة. كما يناسب المؤسسات ذات الاستخدام اليومي المكثف الذي يبرر الاستثمار في بنية تحتية مخصصة.
الخاتمة
يتضح من خلال هذا الدليل الشامل أن الذكاء الاصطناعي المحلي لم يعد مجرد مفهوم نظري متخصص يقتصر على المطورين والباحثين، بل أصبح خيارا عمليا وناضجا تقنيا يستحق الاهتمام الجاد من أي شخص يبحث عن استقلالية حقيقية في استخدامه للذكاء الاصطناعي بعيدا عن الاعتماد الكامل على خدمات سحابية خارجية. مع الحفاظ التام على خصوصية بياناته الشخصية أو المهنية في كل مرحلة من مراحل الاستخدام.
من الواضح أيضا أن هذا المجال يشهد تطورا متسارعا على كافة الأصعدة، سواء من ناحية كفاءة النماذج المتاحة أو قدرات العتاد المستهدف لتشغيلها أو سهولة الأدوات الوسيطة المستخدمة لإدارتها. وهو اتجاه من المتوقع أن يستمر بقوة خلال السنوات القادمة مع دمج وحدات معالجة متخصصة بشكل أعمق في الأجهزة الاستهلاكية العادية. ما سيقرب الفجوة تدريجيا بين تجربة الاستخدام المحلي وتجربة الاستخدام السحابي المتقدم.
في النهاية، يبقى القرار الأنسب مرتبطا دائما بطبيعة احتياج كل مستخدم على حدة، سواء اختار المسار المحلي الكامل أو السحابي أو النهج الهجين الذي يجمع بين مزايا الطريقتين معا. ما يهم فعلا هو أن يبني القارئ قراره على فهم واضح للفروقات الجوهرية بين هذه الخيارات. وهو ما سعى هذا الدليل إلى تقديمه بشكل موسع ومفصل. تاركا الباب مفتوحا أمام تجربة عملية مباشرة تبقى الطريقة الأفضل دائما.ا لتكوين تصور نهائي واقعي حول هذه التقنية المتنامية باستمرار.